Limiti, allucinazioni e il costo reale
Perché l'intelligenza artificiale non pensa, i vicoli ciechi della memoria sintetica e il conto fisico, energetico e legale
Quando un utente interagisce con un modello linguistico avanzato e riceve una risposta scritta con una scioltezza impeccabile, un tono empatico e una grammatica perfetta, è quasi inevitabile che scatti un antico bias cognitivo: l’antropomorfizzazione. Diamo per scontato, d’istinto, che dietro quelle parole ci sia una mente che comprende, un soggetto che riflette e una coscienza che valuta la verità. Il fenomeno è vecchio quanto l’informatica conversazionale: già nel 1966 Joseph Weizenbaum rimase sorpreso nel vedere i suoi utenti confidare la propria intimità a ELIZA, un programma che si limitava a restituire loro le loro stesse frasi riformulate. Eppure questo specchio conversazionale è un’elegante illusione matematica.
Scambiare la scioltezza verbale per ragionamento reale è il più grande equivoco dell’ecosistema tecnologico attuale. Mentre la cognizione umana si fonda sull’esperienza, sull’intenzionalità, sul significato vissuto e sulla comprensione della causalità fisica, i modelli linguistici elaborano correlazioni statistiche massicce tra simboli (token) in spazi vettoriali di altissima dimensione: calcolano probabilità su sequenze di testo. Fino a che punto questo si possa chiamare ragionare è una domanda aperta tra i ricercatori, ma i loro errori mostrano chiaramente che non ragionano come noi.
Sbrogliare i limiti, i difetti strutturali e il conto materiale dell’IA richiede di abbandonare il terreno della magia e di addentrarsi negli ingranaggi della sua stessa architettura. L’analisi rigorosa rivela che l’intelligenza sintetica non soffre solo di vuoti di memoria e di errori d’invenzione, ma si trascina dietro una pesante ipoteca fisica, ambientale e legale che lo splendore commerciale delle interfacce tende a nascondere.
Quando l’IA «mente» e si distrae
Nel gergo giornalistico e commerciale è diventato abituale dire che i modelli linguistici «hanno allucinazioni» quando forniscono dati falsi. Dal punto di vista dell’ingegneria, però, il termine è inesatto e fuorviante: suggerisce una deviazione patologica da uno stato normale di coscienza. In realtà, ciò che chiamiamo allucinazione non è un guasto del sistema, ma il suo normale modo di funzionare: lo stesso meccanismo che produce le risposte corrette produce anche quelle false.
Tre fattori spiegano il comportamento erratico delle intelligenze artificiali.
Il completamento stocastico
I grandi modelli linguistici (LLM) non consultano un’enciclopedia interna né soppesano concetti astratti prima di rispondere: ciò che fanno è un completamento stocastico. Data una sequenza di token (parole o frammenti di parole), il modello calcola la probabilità di ogni possibile token successivo e ne sceglie uno, come abbiamo visto nella prima parte, in base agli schemi statistici appresi durante l’addestramento.
Questa natura ha portato la linguista Emily Bender e le sue coautrici a rendere popolare il concetto di «pappagallo stocastico»: il sistema ripete gli schemi formali del linguaggio con una perfezione sbalorditiva, ma senza un vero ancoraggio al significato del mondo fisico. Quando un’IA «ha un’allucinazione» —cioè inventa una citazione storica, un articolo scientifico inesistente o un dato finanziario falso— non sta mentendo con malizia: si limita a completare la frase con ciò che è statisticamente probabile, cucendo insieme parole che suonano coerenti, anche se non corrispondono a nessun fatto reale.
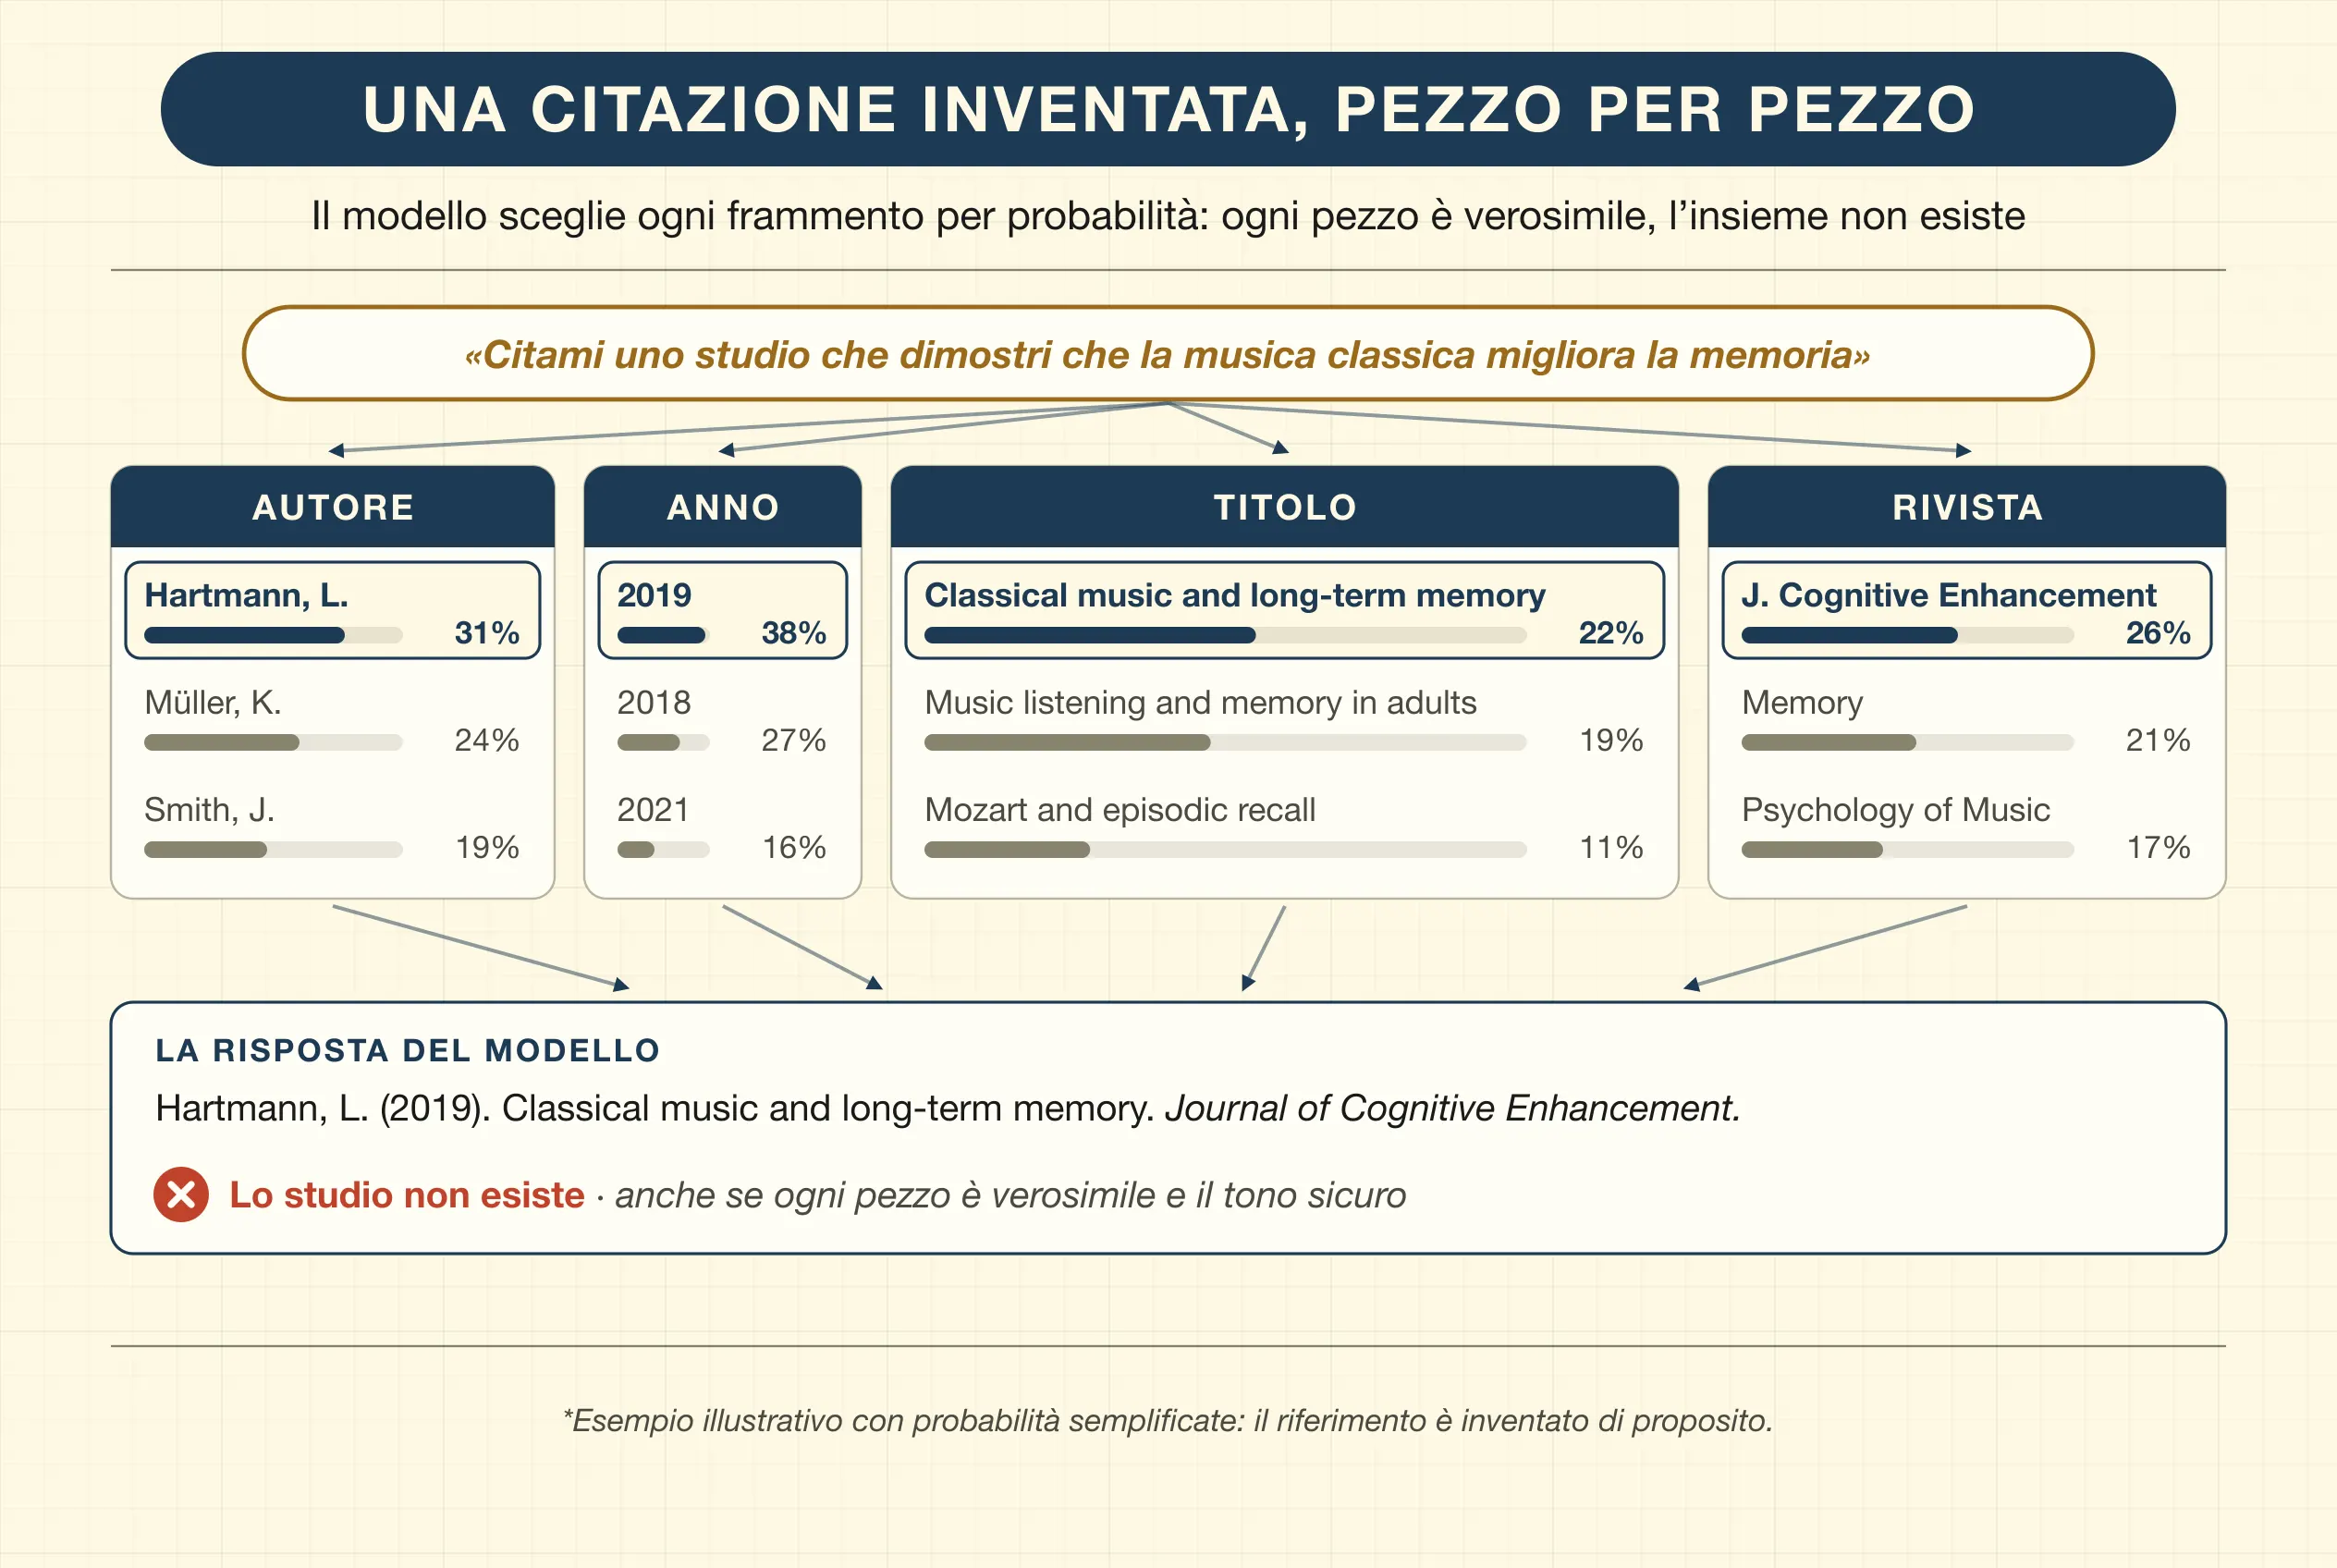
L’addestramento stesso peggiora il problema. I test con cui si valutano i modelli di solito danno lo stesso punteggio a un «non lo so» e a una risposta sbagliata, per cui a un modello conviene tirare a indovinare, come a uno studente in un test a crocette che non toglie punti per gli errori. Per questo un modello preferisce inventare con sicurezza piuttosto che ammettere di non sapere.
La finestra di contesto gigante
Le specifiche tecniche dei modelli moderni vantano «finestre di contesto» enormi, capaci di elaborare da 128.000 a oltre un milione di token in una sola richiesta, l’equivalente di diversi libri interi. Tuttavia, la capacità di trattenere e usare con precisione le informazioni contenute in quei testi non è uniforme.
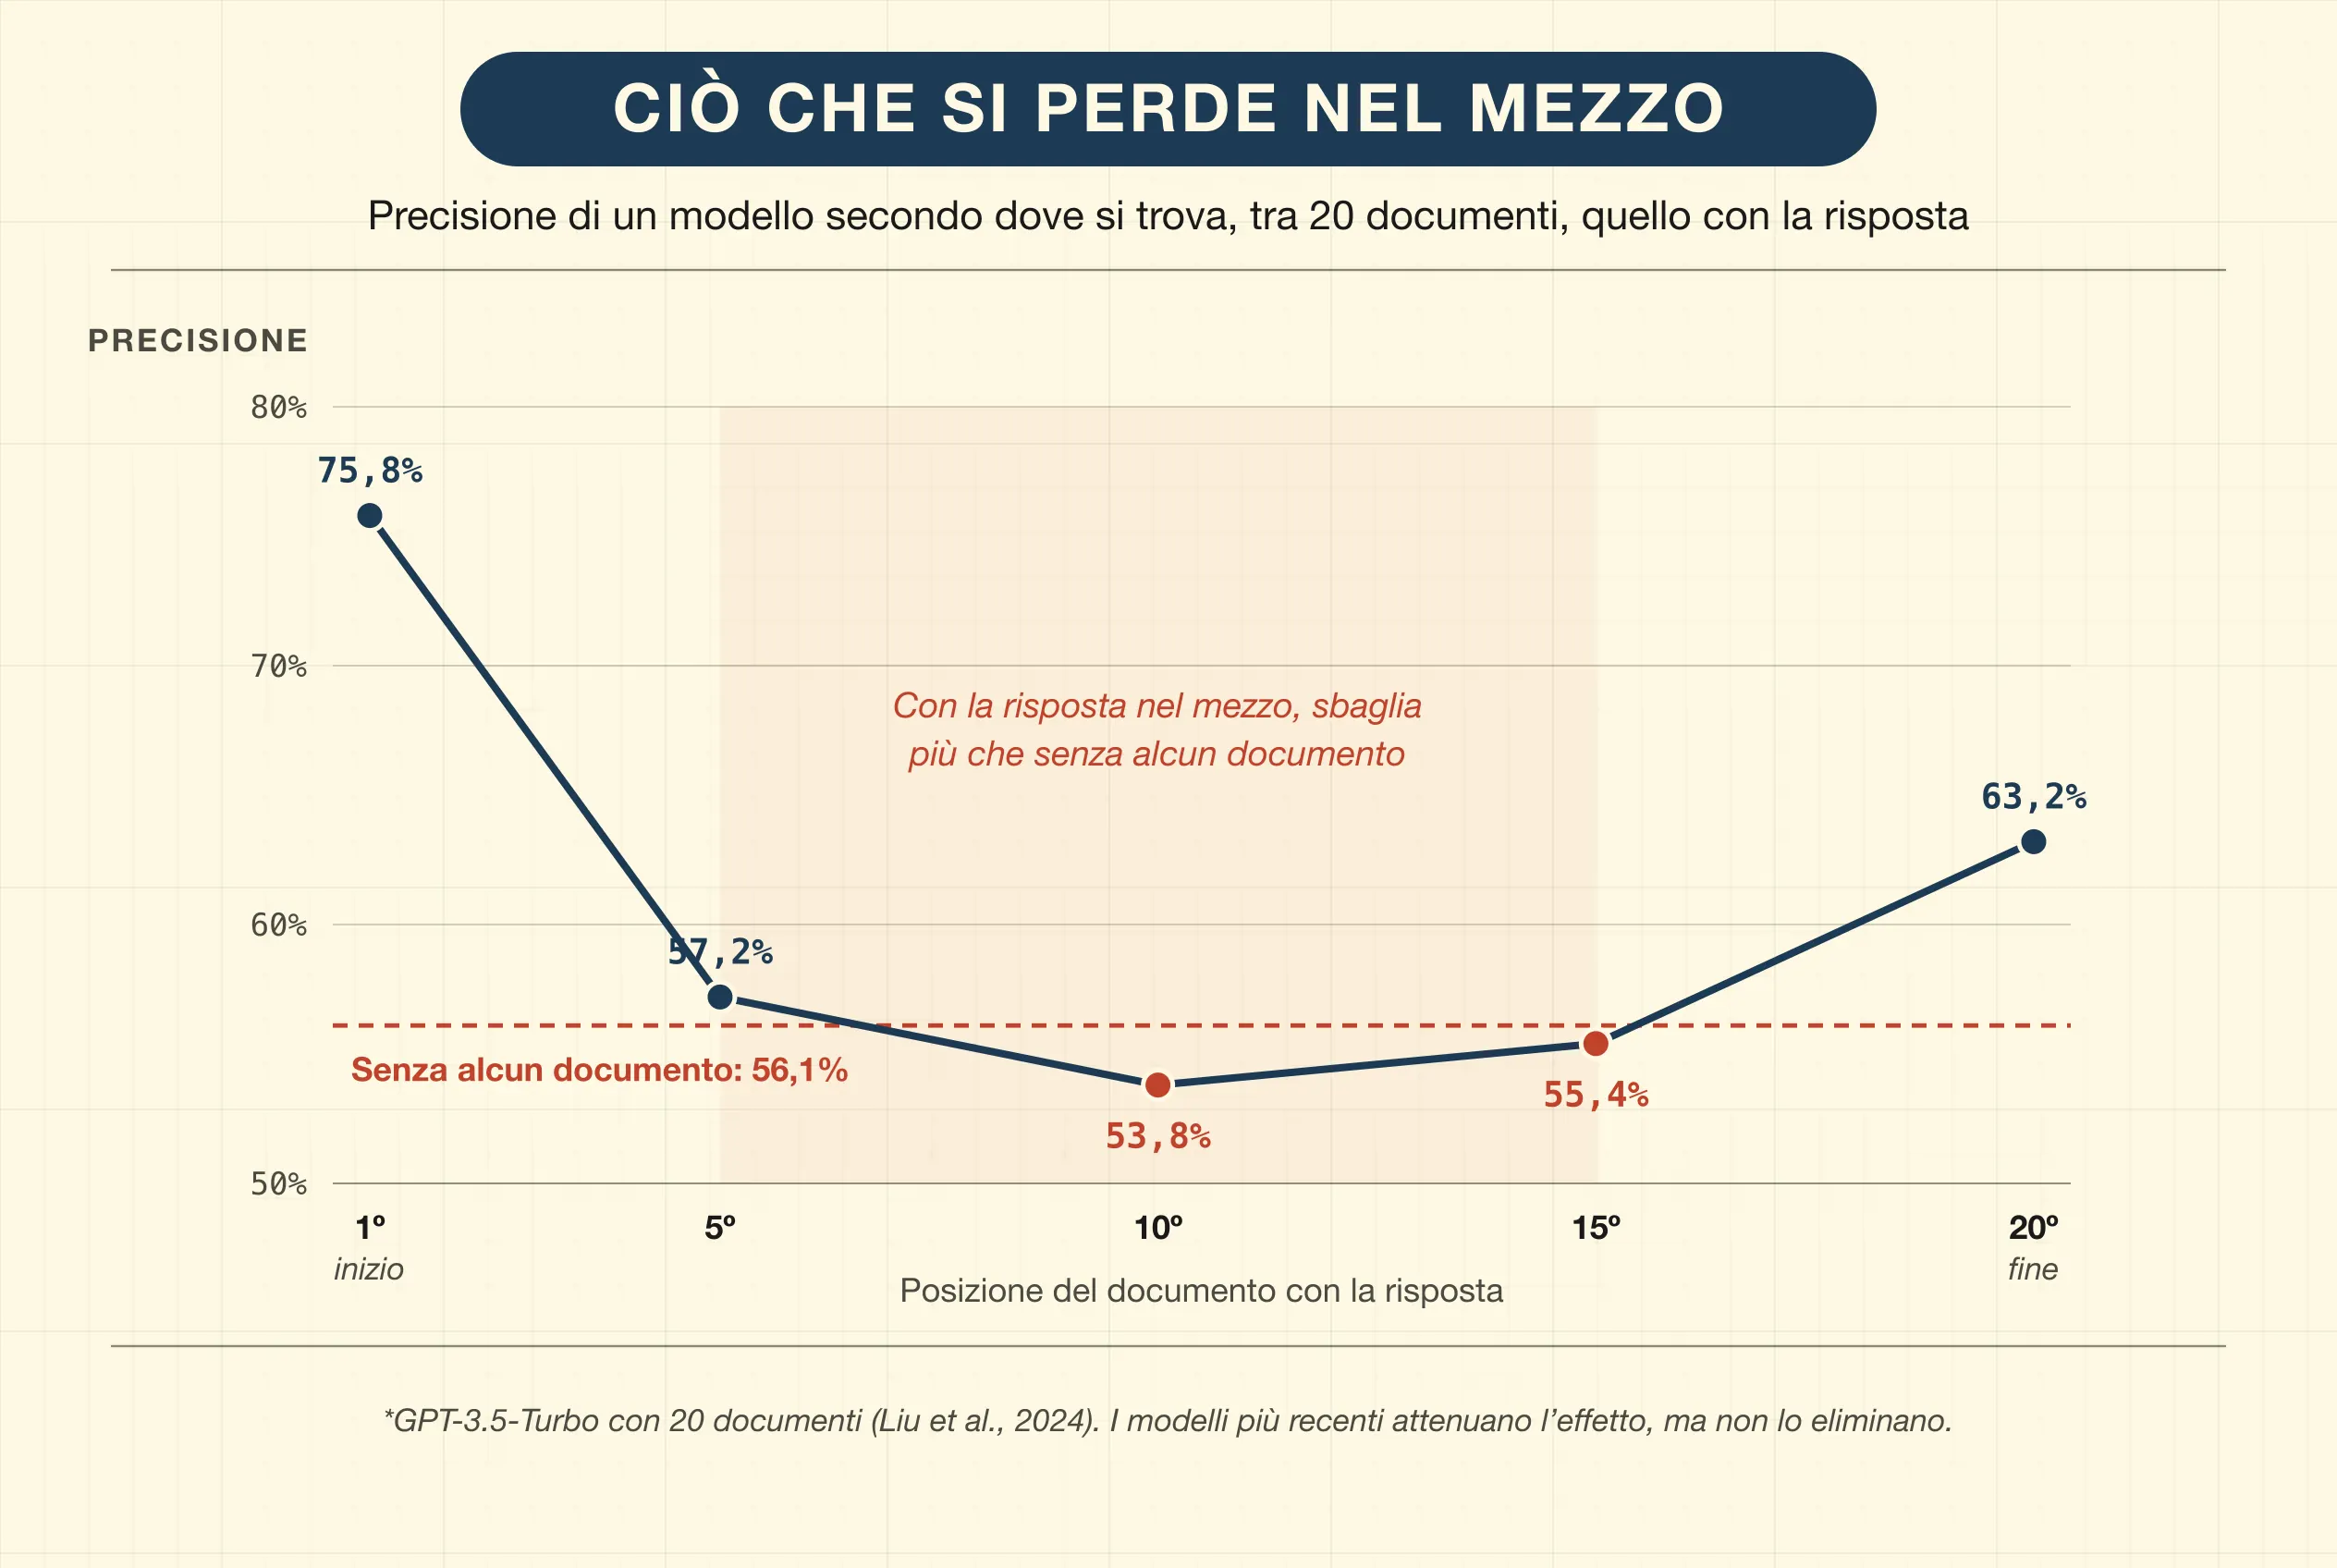
- L’effetto lost in the middle: diversi studi hanno mostrato che il rendimento dei modelli disegna una curva a U a seconda di dove si trova il dato che serve loro. Sfruttano molto bene le informazioni all’inizio e alla fine del testo, ma la loro precisione cala sensibilmente per quelle che stanno nel mezzo: in uno dei primi esperimenti, di oltre 20 punti. I modelli più recenti hanno attenuato l’effetto, ma non l’hanno eliminato.
- L’ago nel pagliaio: trovare una frase precisa nascosta in un documento enorme non è più una sfida per i modelli attuali. Il difficile arriva quando bisogna collegare più dati sparsi o ragionarci sopra: lì il rendimento cala man mano che il testo cresce, anche se l’intero file «ci sta» formalmente nella loro memoria operativa. In una valutazione del 2024, solo la metà dei modelli che dichiaravano finestre di 32.000 token o più manteneva un rendimento accettabile a quella lunghezza.
La mancanza di senso comune e di causalità fisica
Gli esseri umani possiedono un senso comune basato sulla fisica, sulla causalità e sull’esperienza corporea. Sappiamo che se lasciamo cadere un bicchiere di vetro a terra si romperà, o che non possiamo infilare un oggetto grande dentro uno più piccolo.
L’IA manca di questo quadro di riferimento empirico. Conosce la relazione tra le parole che descrivono il mondo, non il mondo in sé. Per questo tende a commettere errori logici clamorosi non appena la si porta fuori dagli schemi che compaiono in modo esplicito nei suoi dati di addestramento. In un esperimento del 2024 è bastato cambiare i nomi e i numeri di problemi scolastici di matematica per far scendere la precisione dei modelli, e aggiungere all’enunciato una frase irrilevante per farla crollare fino al 65% in alcuni di essi. Operano in un universo puramente relazionale di simboli, privo di attrito materiale.
Il muro dei dati
Per addestrare gli attuali modelli di frontiera, i laboratori tecnologici hanno dovuto divorare volumi colossali di informazioni: praticamente la totalità dei libri digitalizzati, degli articoli scientifici, della stampa storica, di Wikipedia, dei repository di codice e dei forum pubblici prodotti dall’umanità nel corso di decenni. Questo modello di sviluppo si sta ora avvicinando a un limite molto concreto: l’esaurimento dell’internet umano.
La scarsità di materia prima originale
Secondo le stime più citate, al ritmo attuale l’industria avrà consumato tutto il testo umano pubblico di qualità tra il 2026 e il 2032. Davanti alla prospettiva di questo deserto di dati freschi, le grandi aziende ricorrono sempre più ai dati sintetici: usare modelli di IA potenti per generare milioni di testi e immagini con cui addestrare le generazioni successive di algoritmi.
Il collasso del modello
Questa pratica ha portato alla luce un problema matematico noto come collasso del modello o «consanguineità digitale». Che cosa succede quando un’intelligenza artificiale si nutre dei contenuti generati da altre intelligenze artificiali?
- Prima generazione: il modello impara da dati umani diversi, pieni di sfumature, eccezioni e ricchezza stilistica.
- Seconda generazione: viene addestrato sui testi prodotti dalla precedente. Poiché questa tende a ripetere ciò che è più frequente, il modello comincia a perdere i casi poco comuni, le code della distribuzione statistica. La diversità si impoverisce e scompaiono le sfumature più rare, minoritarie o creative della cultura umana.
- Generazioni avanzate: la rete si nutre quasi esclusivamente di dati sintetici prevedibili. Gli errori, le allucinazioni residue e la mancanza di varietà si amplificano in un circolo vizioso. Il modello perde la capacità di rappresentare la realtà, subisce un degrado irreversibile e finisce per diventare un repertorio di risposte iperstereotipate e vuote.
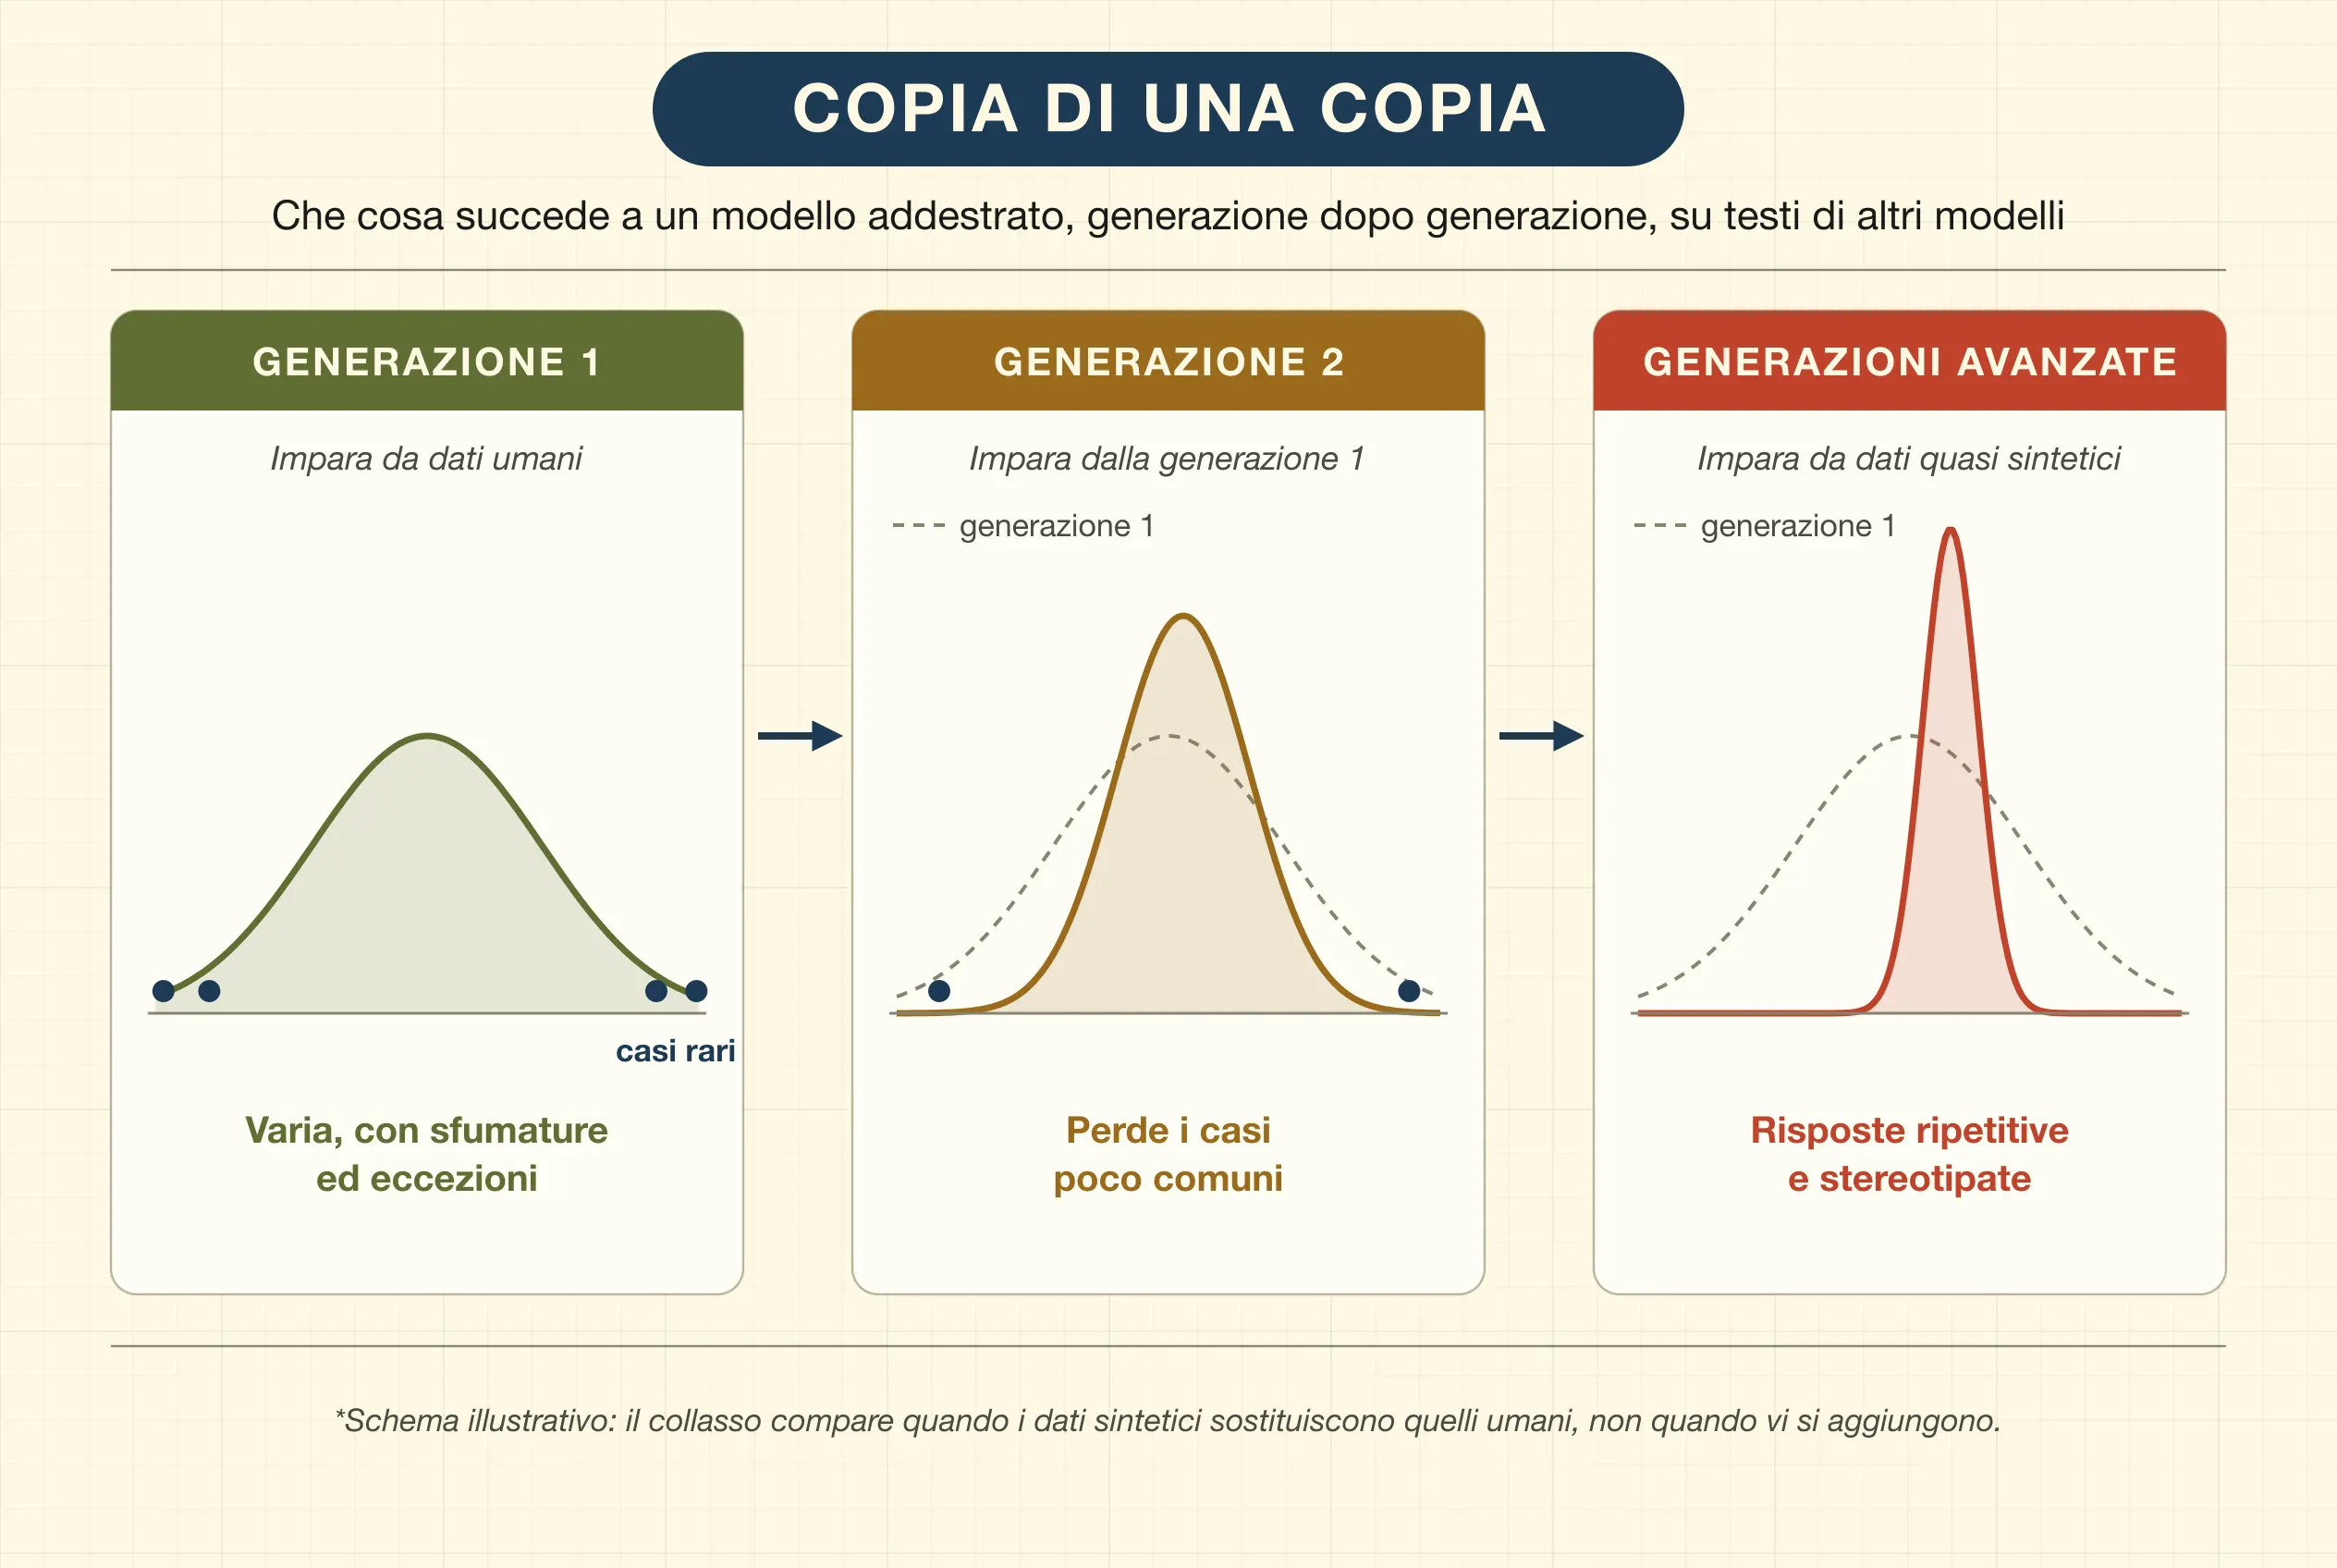
Il collasso compare soprattutto quando i dati sintetici sostituiscono quelli umani. Se si accumulano accanto a essi e vengono filtrati con cura, il rischio si riduce molto, e infatti i laboratori addestrano già con dati sintetici con buoni risultati. Il problema è che internet si sta riempiendo di testi generati dall’IA senza etichetta, e distinguere gli uni dagli altri è sempre più difficile.
Costi fisici e legali
La percezione popolare dell’intelligenza artificiale come una tecnologia eterea, ospitata in una «nuvola» senza peso e immateriale, si scontra frontalmente con la cruda realtà della sua infrastruttura industriale, profondamente ancorata alla fisica, alla geografia e al consumo di risorse naturali. Il silicio pesa, l’elettricità inquina e i dati hanno dei proprietari.
Il conto energetico e idrico
L’addestramento e il funzionamento dei grandi modelli linguistici richiedono infrastrutture di supercalcolo di scala colossale, dotate di decine di migliaia di schede di elaborazione grafica (GPU).
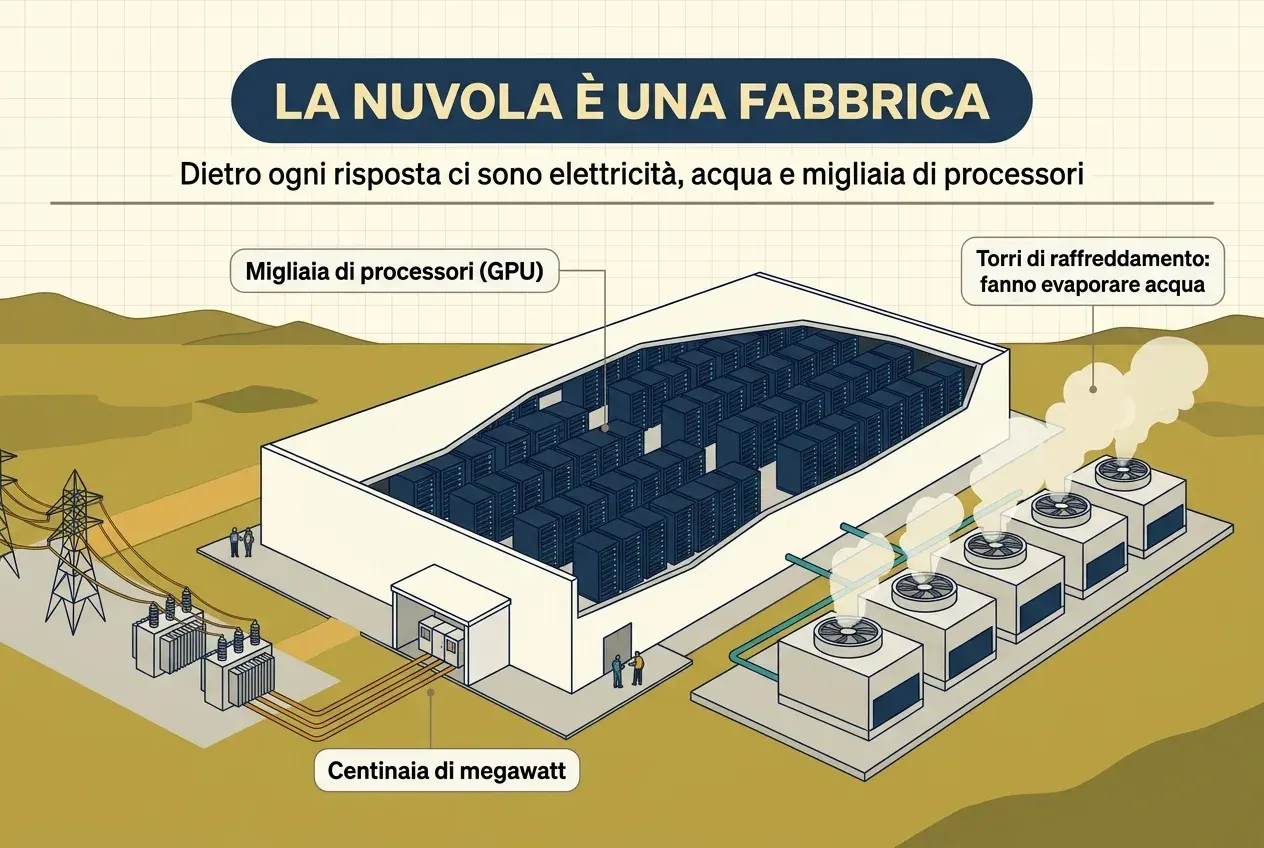
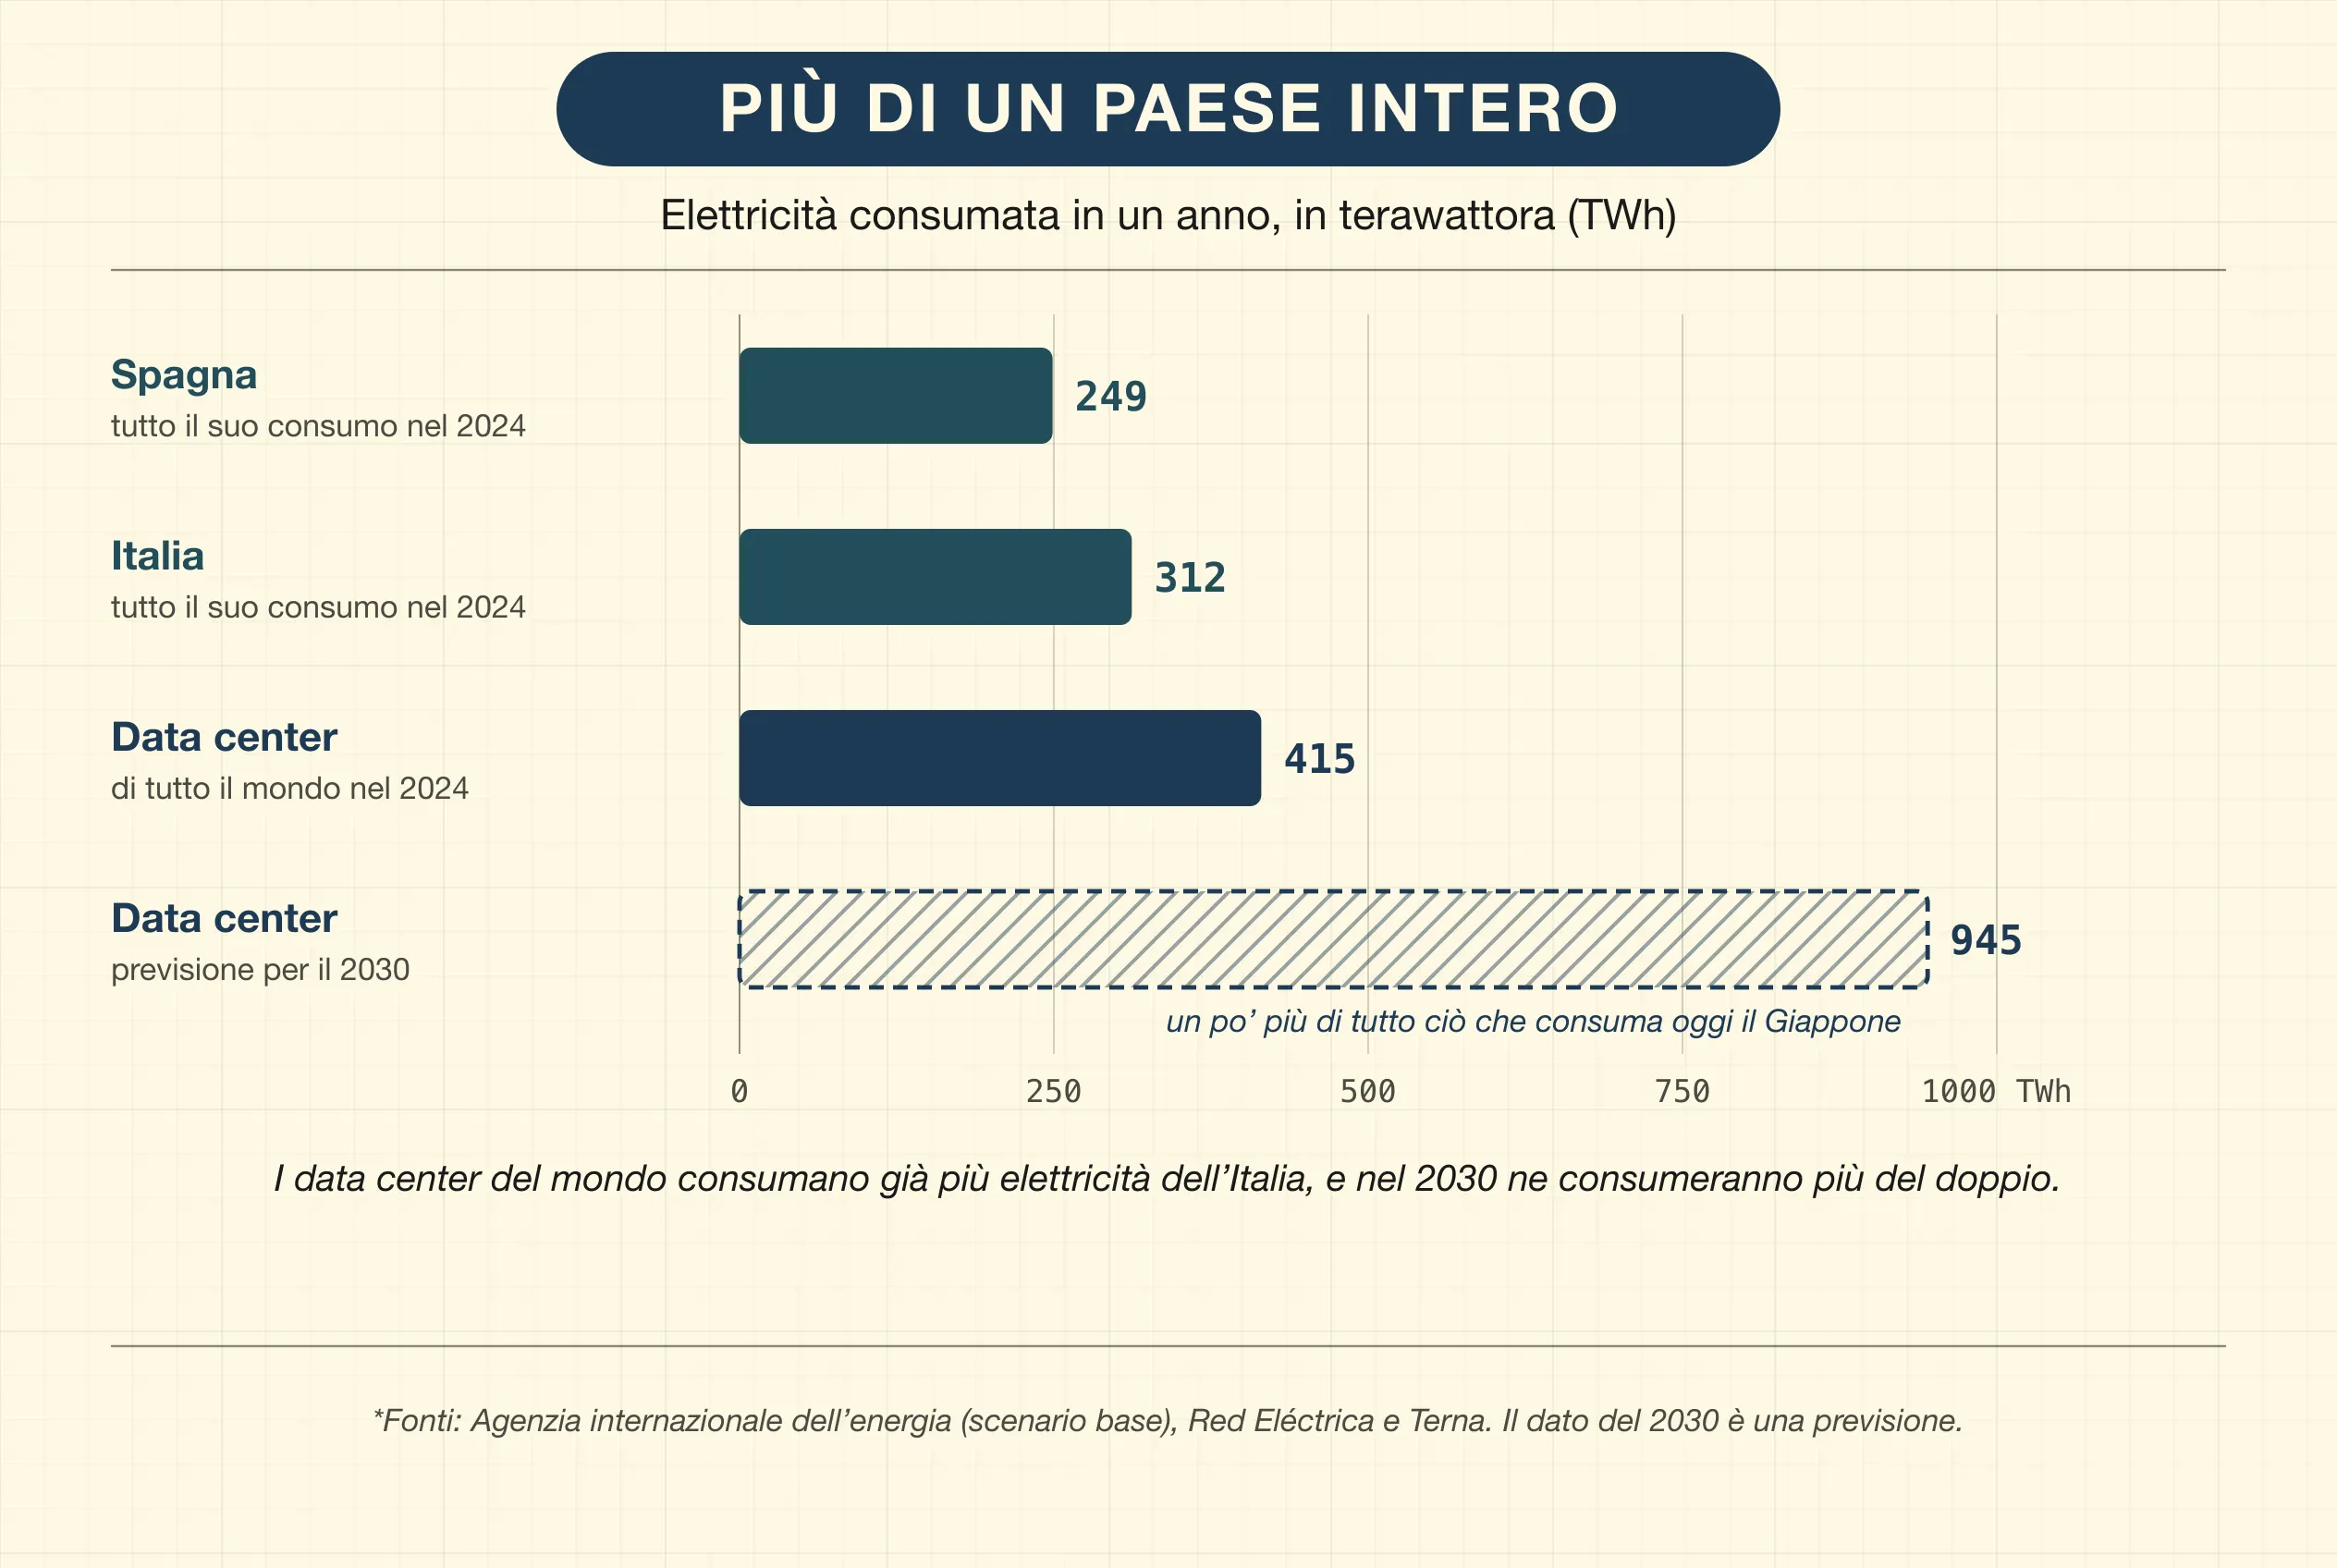
- Consumo elettrico: i data center più grandi assorbono centinaia di megawatt senza interruzione, e addestrare un solo modello di frontiera può richiedere tanta elettricità quanta ne consumano in un anno migliaia di famiglie. Nel complesso, i data center del mondo hanno consumato circa 415 terawattora nel 2024, intorno all’1,5% dell’elettricità mondiale, e l’Agenzia internazionale dell’energia prevede che la cifra raddoppi entro il 2030, spinta soprattutto dall’IA.
- Costo computazionale quadratico: nelle architetture attuali, il calcolo del meccanismo di attenzione non cresce in proporzione alla lunghezza del testo, ma con il suo quadrato. Raddoppiare il testo che consegniamo a un’IA quadruplica quel calcolo sul server, il che fa impennare il consumo energetico delle richieste lunghe.
- Impronta idrica: le server farm generano un calore estremo. Per evitare il surriscaldamento dei circuiti, molte usano torri di raffreddamento evaporativo che consumano milioni di litri di acqua dolce, spesso potabile, mettendo sotto pressione le riserve idriche delle regioni in cui si trovano. Il solo addestramento di GPT-3 potrebbe aver fatto evaporare circa 700.000 litri.
La crisi della proprietà intellettuale
La raccolta massiccia di dati (web scraping) per alimentare le IA si è svolta per anni in una zona grigia del diritto, assorbendo opere protette dal diritto d’autore senza il consenso, l’attribuzione né il compenso dei loro creatori.
Oggi i tribunali di tutto il mondo esaminano cause intentate da scrittori, artisti visivi, fotografi e mezzi di comunicazione. Il dibattito giuridico contrappone la dottrina del «fair use» (uso legittimo) difesa dalle aziende tecnologiche, secondo cui il modello si limita a «imparare» schemi astratti, alle accuse di estrattivismo dei dati e di concorrenza sleale, dato che i modelli commercializzati competono sul mercato con gli stessi creatori delle cui opere si sono nutriti.
Le prime sentenze tracciano un quadro sfumato. Nel 2025 un giudice statunitense ha considerato uso legittimo addestrare un modello con libri acquistati, ma non scaricare copie pirata per costruire una biblioteca, e Anthropic ha pagato 1,5 miliardi di dollari per chiudere il caso. Nello stesso anno un tribunale britannico ha dato ragione nella sostanza a Stability AI contro Getty Images, mentre la causa del New York Times contro OpenAI è ancora aperta. In Europa, il Regolamento sull’IA obbliga già i fornitori di modelli per finalità generali a pubblicare una sintesi dei loro dati di addestramento e a rispettare gli autori che si oppongono all’uso delle proprie opere.
I bias algoritmici e lo specchio sociale
Poiché i modelli si nutrono dell’archivio storico della società umana, ne ereditano inevitabilmente le inerzie, i pregiudizi e le discriminazioni sistemiche. Se i testi contengono bias di genere, razziali o socioeconomici, il modello li codificherà come correlazioni statistiche valide. Uno studio del 2024 lo ha mostrato in modo crudo: i modelli assegnavano lavori meno prestigiosi e condanne più dure alle persone che scrivevano in inglese afroamericano, anche se, interrogati direttamente, esprimevano opinioni favorevoli su di loro.
Senza una supervisione umana rigorosa che ne regoli l’etica, l’IA agisce come un amplificatore automatico dei pregiudizi del passato, travestendoli da presunta oggettività matematica. Questo solleva inoltre una domanda senza una risposta semplice: chi ha la capacità di affinare l’etica di un’IA? Chi è il padrone della morale?
Riferimenti e supporto scientifico
- ELIZA, il primo programma conversazionale, e la sorpresa del suo autore nel vedere quanto i suoi utenti vi si affezionassero. Weizenbaum, J. (1966). ELIZA—A computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36-45. Consultare l’articolo (DOI)
- L’articolo dei «pappagalli stocastici»: modelli che concatenano forme linguistiche senza accesso al loro significato, e i rischi di renderli sempre più grandi. Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610-623. Consultare lo studio (DOI)
- Perché i modelli hanno allucinazioni: le valutazioni premiano il tirare a indovinare più che l’ammettere di non sapere. Kalai, A. T., Nachum, O., Vempala, S. S., & Zhang, E. (2025). Why language models hallucinate. arXiv, 2509.04664. Consultare lo studio su arXiv
- L’effetto lost in the middle: i modelli sfruttano peggio le informazioni collocate al centro di un testo lungo. Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the middle: How language models use long contexts. Transactions of the Association for Computational Linguistics, 12, 157-173. Consultare l’articolo (DOI)
- La finestra di contesto reale di un modello è spesso molto più piccola di quella dichiarata. Hsieh, C.-P., Sun, S., Kriman, S., Acharya, S., Rekesh, D., Jia, F., Zhang, Y., & Ginsburg, B. (2024). RULER: What’s the real context size of your long-context language models? arXiv, 2404.06654. Consultare lo studio su arXiv
- Basta cambiare i numeri di un problema di matematica, o aggiungervi una frase irrilevante, perché i modelli sbaglino molto di più. Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2025). GSM-Symbolic: Understanding the limitations of mathematical reasoning in large language models. International Conference on Learning Representations (ICLR). Consultare lo studio su arXiv
- Quando si esaurirà il testo umano pubblico disponibile per addestrare i modelli: tra il 2026 e il 2032, al ritmo attuale. Villalobos, P., Ho, A., Sevilla, J., Besiroglu, T., Heim, L., & Hobbhahn, M. (2024). Position: Will we run out of data? Limits of LLM scaling based on human-generated data. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 49523-49544. Consultare lo studio su arXiv
- Il collasso del modello: addestrare con dati generati da altri modelli cancella i casi rari e degrada il risultato generazione dopo generazione. Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631(8022), 755-759. Consultare l’articolo (DOI)
- La sfumatura: se i dati sintetici si accumulano accanto a quelli reali invece di sostituirli, il collasso si evita. Gerstgrasser, M., Schaeffer, R., Dey, A., Rafailov, R., Sleight, H., … & Koyejo, S. (2024). Is model collapse inevitable? Breaking the curse of recursion by accumulating real and synthetic data. arXiv, 2404.01413. Consultare lo studio su arXiv
- L’architettura Transformer, il cui meccanismo di attenzione ha un costo che cresce con il quadrato della lunghezza del testo. Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998-6008. Consultare lo studio su arXiv
- Quanta elettricità consumano i data center e quanto crescerà questo consumo con l’IA. International Energy Agency. (2025). Energy and AI. IEA. Consultare il rapporto dell’IEA
- L’impronta idrica dell’IA: quanta acqua evapora per raffreddare i server che addestrano ed eseguono i modelli. Li, P., Yang, J., Islam, M. A., & Ren, S. (2025). Making AI less ‘thirsty’. Communications of the ACM, 68(7), 54-61. Consultare l’articolo (DOI)
- La prima grande sentenza su addestramento e diritto d’autore: uso legittimo con libri acquistati, non con copie pirata. Tribunale distrettuale degli Stati Uniti per il distretto settentrionale della California. (2025). Bartz v. Anthropic PBC, 787 F. Supp. 3d 1007. Consultare la sentenza
- Il Regolamento europeo sull’intelligenza artificiale, che obbliga i fornitori di modelli per finalità generali a sintetizzare i dati di addestramento e a rispettare il diritto d’autore. Parlamento europeo e Consiglio dell’Unione europea. (2024). Regolamento (UE) 2024/1689 che stabilisce regole armonizzate sull’intelligenza artificiale. Gazzetta ufficiale dell’Unione europea, L 2024/1689. Consultare il testo su EUR-Lex
- I bias umani restano impressi nelle rappresentazioni che i modelli apprendono dal linguaggio. Caliskan, A., Bryson, J. J., & Narayanan, A. (2017). Semantics derived automatically from language corpora contain human-like biases. Science, 356(6334), 183-186. Consultare l’articolo (DOI)
- Razzismo nascosto: i modelli giudicano peggio chi scrive in inglese afroamericano, pur dichiarando di non avere pregiudizi. Hofmann, V., Kalluri, P. R., Jurafsky, D., & King, S. (2024). AI generates covertly racist decisions about people based on their dialect. Nature, 633(8028), 147-154. Consultare l’articolo (DOI)
Scrive di salute, nutrizione e delle certezze che nessuno rimette in discussione.
Stiamo preparando lo spazio per commentare gli articoli.
Continua a leggere
Il cuore nella pelle
Come la radiazione ultravioletta libera l'ossido nitrico della pelle per regolare la pressione arteriosa e contrastare il rischio cardiovascolare
L'effetto Zeigarnik, o il prezzo delle idee brillanti
Il fenomeno psicologico che sabota il tuo riposo in nome della creatività
Acqua strutturata: il terreno della salute
La batteria liquida delle tue cellule e come proteggerla dall'ambiente moderno