Origine e fondamenta dell'IA
Dall'enigmatico test di Turing alle reti neurali artificiali: come l'essere umano cerca da decenni di replicare la propria mente nel silicio
Dagli automi meccanici del Settecento ai data center di oggi, che divorano gigawatt di energia, l’umanità ha coltivato un desiderio costante: creare un riflesso artificiale della propria intelligenza. Questa ambizione, che per secoli ha abitato i territori del mito e della fantascienza, trovò la sua prima formalizzazione matematica e filosofica a metà del Novecento grazie ad Alan Turing.
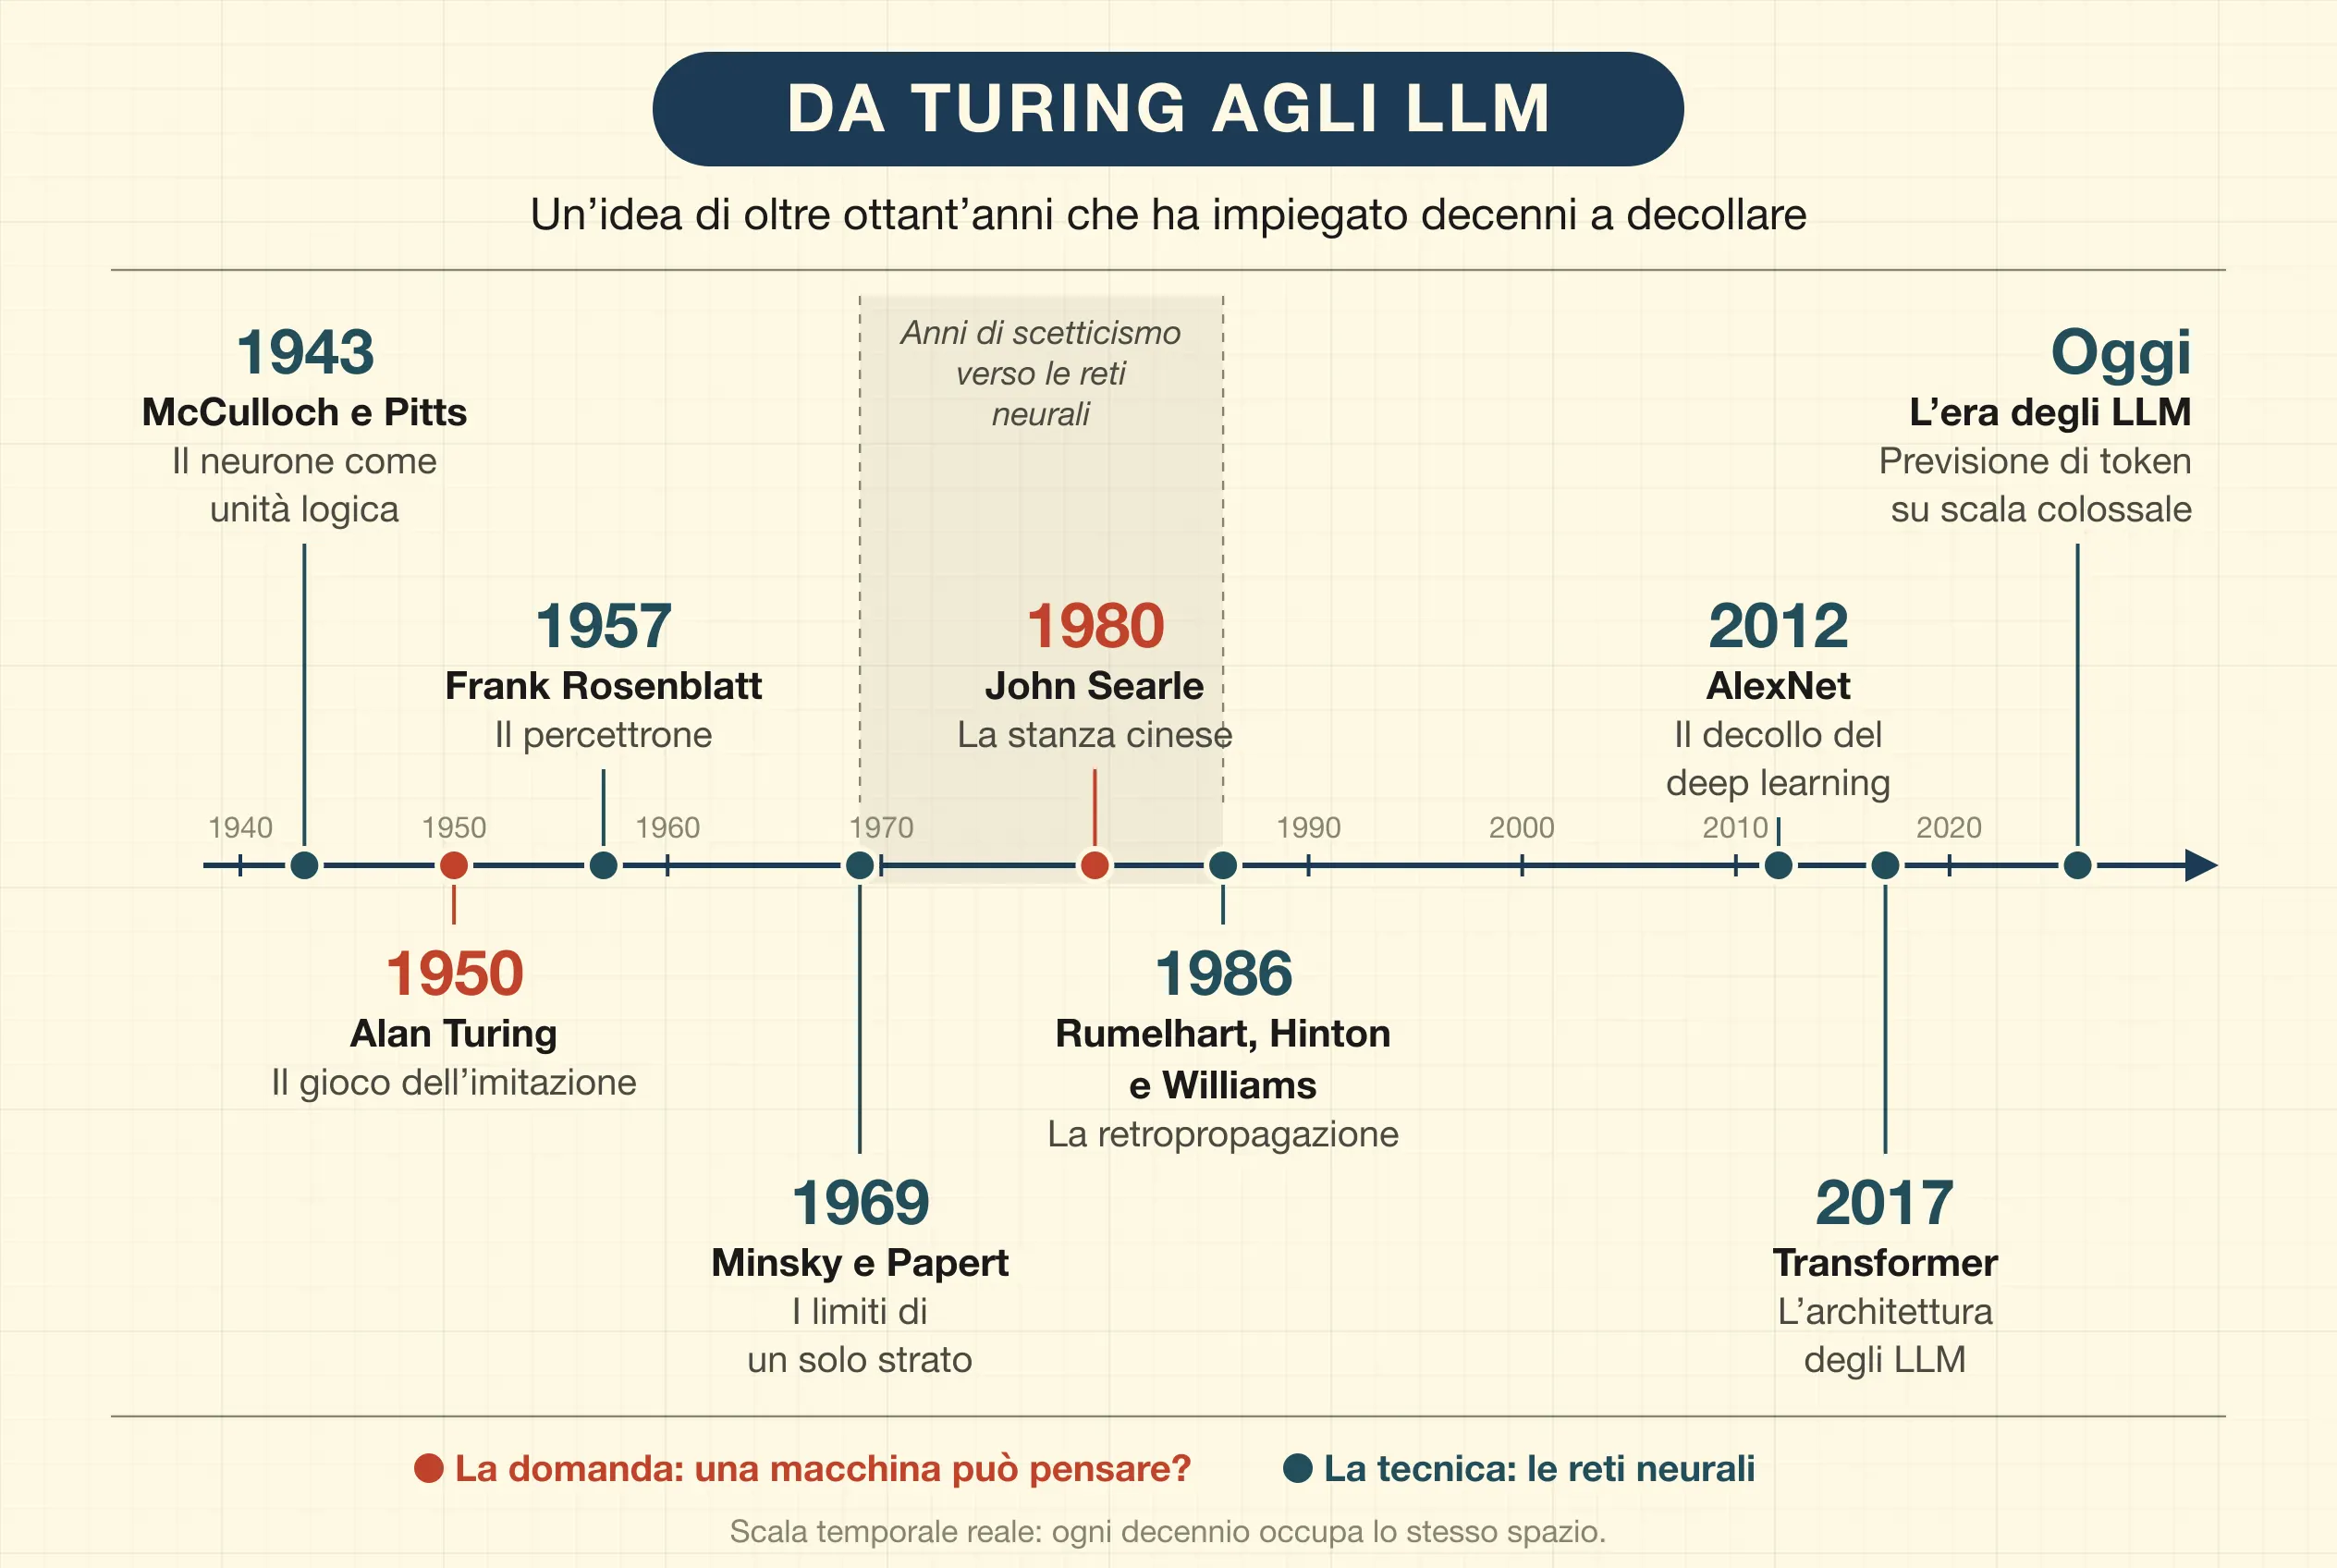
Nel 1950 Turing propose un esperimento mentale che avrebbe cambiato per sempre il dibattito filosofico e scientifico: il gioco dell’imitazione, oggi universalmente noto come test di Turing. La sua proposta aggirava la spinosa domanda metafisica —una macchina può pensare?— per concentrarsi su un criterio osservabile: un valutatore umano riesce a capire se sta conversando con una persona o con una macchina attraverso un canale di testo? Se le risposte del sistema risultano indistinguibili da quelle umane, la macchina ha superato il test.
Tre decenni dopo, nel 1980, il filosofo John Searle rispose con un celebre controesempio: la stanza cinese. Immaginiamo una persona chiusa in una stanza che non conosce una parola di cinese, ma dispone di un gigantesco manuale di regole in italiano che le spiega come manipolare i simboli cinesi che riceve da sotto la porta («se ricevi il simbolo X, rispondi con il simbolo Y»). Per chi sta fuori, le risposte sono perfette e il sistema sembra capire il cinese con scioltezza. Eppure, dentro la stanza, nessuno comprende il significato dei caratteri.
Questo esperimento mentale anticipò il grande dilemma che ci portiamo dietro ancora oggi: l’abisso tra la simulazione sintattica —manipolare simboli con efficacia— e la comprensione semantica.
Dal cervello umano al neurone artificiale
Di fronte alla strada delle regole rigide, che avrebbe finito per arenarsi, i pionieri della cibernetica decisero di guardare al modello di calcolo più efficiente che esista: il cervello umano. Un organo che, con appena 20 watt di potenza —meno di una lampadina tradizionale—, è capace di elaborare emozioni, risolvere equazioni e comporre sinfonie. Già nel 1943 il neurofisiologo Warren McCulloch e il logico Walter Pitts avevano descritto il neurone come una piccola unità logica che, a seconda dei segnali che riceve, si attiva o resta a riposo. Fu il seme di tutto ciò che venne dopo.
Anatomia del neurone biologico
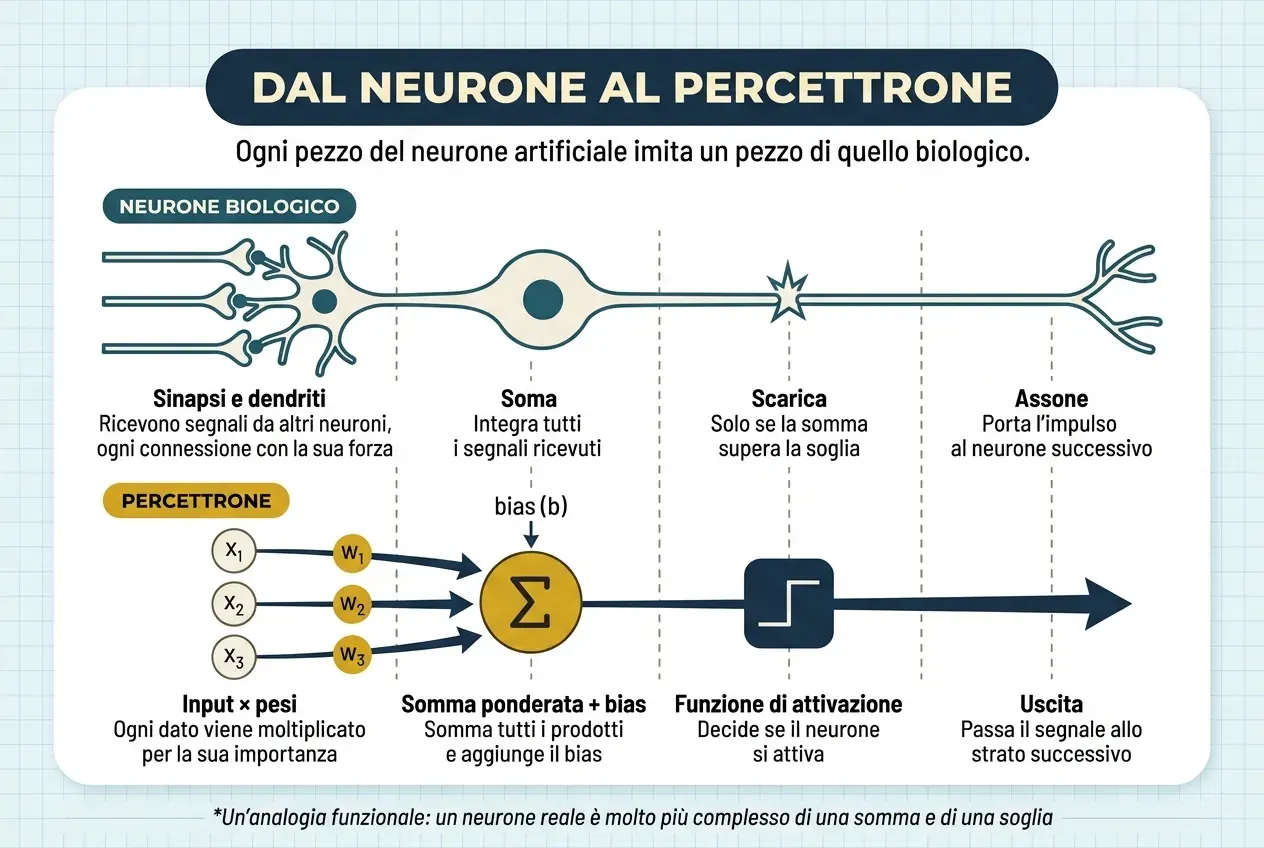
Il sistema nervoso è formato da miliardi di cellule interconnesse chiamate neuroni: il solo cervello umano ne ospita circa 86 miliardi. La loro architettura di base si divide in quattro elementi funzionali:
- Dendriti: strutture ramificate che fanno da antenne, ricevendo gli impulsi elettrici e chimici provenienti da altri neuroni.
- Soma o corpo cellulare: il centro di elaborazione, che integra tutti i segnali ricevuti. Se la loro somma supera una certa soglia elettrica, il neurone «scarica».
- Assone: un lungo prolungamento lungo il quale l’impulso elettrico generato nel soma viaggia verso altre cellule.
- Sinapsi: il punto di connessione biochimica tra l’assone di un neurone e i dendriti di un altro. La sua plasticità —la capacità di rafforzarsi o indebolirsi con l’uso— è, come intuì lo psicologo Donald Hebb nel 1949, la base fisica dell’apprendimento e della memoria.
Il percettrone: il neurone artificiale
Nel 1957 lo psicologo Frank Rosenblatt tradusse questa architettura biologica nel linguaggio della matematica inventando il percettrone, l’antenato diretto delle reti neurali attuali.
In termini matematici, un neurone artificiale è una funzione che riceve diversi input numerici (x₁, x₂, …, xₙ). Ognuno viene moltiplicato per un peso (w₁, w₂, …, wₙ), l’equivalente matematico della forza sinaptica: un numero che indica quanto conta quell’input specifico nella decisione finale.
A questi valori ponderati si somma un termine correttivo chiamato bias, che sposta la funzione in modo che al neurone costi più o meno attivarsi. Il risultato passa poi per una funzione di attivazione —un filtro matematico, come una funzione a gradino o una sigmoide— che determina il valore in uscita del neurone.
L’analogia con il neurone umano è diretta:
- Input: equivalgono ai segnali che arrivano attraverso i dendriti.
- Pesi: rappresentano la forza della sinapsi biologica. Moltiplicano ogni input per indicarne l’importanza: alcuni dati pesano più di altri nella decisione.
- Somma ponderata: come il soma, accumula i prodotti di ogni input per il suo peso e aggiunge il bias, che agisce come la tendenza naturale del neurone ad attivarsi o a tacere.
- Funzione di attivazione: il grilletto finale. Se il risultato supera una soglia, il neurone artificiale «si attiva» e trasmette il segnale allo strato successivo; altrimenti resta inerte.
Il processo di addestramento
Un singolo neurone artificiale basta appena a risolvere problemi banali. Ma quando ne impiliamo milioni —o miliardi— in strati interconnessi, otteniamo una rete neurale artificiale.
Come impara questa rete? All’inizio i pesi (w) vengono inizializzati con numeri casuali, quindi i risultati sono assurdi. Durante l’addestramento il sistema confronta la propria previsione con la risposta corretta tramite una funzione di perdita (loss function), che misura quanto ha sbagliato. Un algoritmo fondamentale, la retropropagazione (backpropagation), distribuisce quell’errore all’indietro a partire dall’ultimo strato, e un ottimizzatore —come la discesa del gradiente— regola millimetricamente ogni peso nella direzione che lo riduce. Ripetendo questo ciclo milioni di volte su quantità enormi di dati, la rete impara a riconoscere schemi complessi in modo autonomo.
Machine learning e deep learning a confronto
Per decenni le reti neurali furono una promessa mancata, frenata dalla scarsità di potenza di calcolo e dai loro limiti matematici: nel 1969 Marvin Minsky e Seymour Papert dimostrarono che un percettrone a un solo strato non riesce a risolvere nemmeno un problema semplice come l’«or esclusivo» (rispondere «sì» quando è vera una di due condizioni, ma non entrambe), e l’interesse per queste reti crollò per anni. Nel frattempo l’informatica tradizionale funzionava con la programmazione esplicita: bisognava scrivere regole rigide («se succede A, allora fai B»). Le macchine erano eccellenti nelle catene di montaggio logiche, ma cieche davanti a compiti ambigui come riconoscere un volto in una fotografia.
La rivoluzione arrivò con il machine learning (apprendimento automatico) e, più tardi, con la sua evoluzione profonda, il deep learning (apprendimento profondo), spinto da tre fattori: processori grafici (GPU) sempre più economici, internet come oceano di dati e architetture di reti neurali con molti strati nascosti. Il suo momento simbolico arrivò nel 2012, quando AlexNet, una rete profonda addestrata su GPU, stravinse il concorso di riconoscimento di immagini ImageNet.
Nel deep learning sparisce l’ingegneria manuale delle caratteristiche. Se dai in pasto a una rete profonda milioni di immagini di veicoli senza spiegarle che cos’è una ruota o un manubrio, i suoi primi strati impareranno a riconoscere schemi elementari (linee, bordi, contrasti); quelli intermedi combineranno quelle linee per riconoscere forme geometriche (cerchi, angoli), e gli ultimi ricomporranno il puzzle per stabilire se l’oggetto è un’auto, una bicicletta o un camion. La macchina estrae da sola le proprie rappresentazioni astratte del mondo a partire dai dati grezzi.
| Caratteristica | Machine learning tradizionale | Deep learning (reti profonde) |
|---|---|---|
| Intervento umano | Richiede un’ingegneria delle caratteristiche manuale (feature engineering): un esperto deve decidere in anticipo quali tratti o misure cercare (per esempio bordi o texture). | Le caratteristiche si apprendono in modo autonomo a partire dai dati grezzi, attraverso strati nascosti successivi. |
| Volume di dati | Funziona bene con insiemi di dati piccoli o moderati. | Richiede volumi enormi di dati per evitare il sovradattamento (overfitting) e generalizzare correttamente. |
| Capacità di astrazione | Limitata ai tratti forniti dall’esperto e a relazioni relativamente semplici tra di essi. | Costruisce gerarchie di concetti complessi: gli strati inferiori riconoscono linee; quelli intermedi, forme; quelli superiori, volti od oggetti interi. |
La grande differenza tra i due approcci sta nella profondità: mentre il machine learning tradizionale lavora con uno o due strati di trasformazione matematica, il deep learning ne concatena decine o centinaia, il che gli permette di modellare realtà fortemente non lineari come la voce umana, la struttura delle proteine o il linguaggio naturale.
Che cos’è davvero un LLM?
Quando arriviamo ai grandi modelli linguistici (large language models o LLM), come quelli alla base dell’attuale rivoluzione dell’IA generativa, il principio matematico resta lo stesso —reti neurali profonde regolate tramite retropropagazione—, ma applicato al tessuto della comunicazione umana: il testo.
La disinvoltura con cui gli LLM di oggi scrivono saggi, programmano o sostengono conversazioni ha diffuso la falsa impressione che le macchine ragionino come persone, ma nulla di più lontano dalla realtà. Per capire come funzionano davvero bisogna spogliare il linguaggio della sua mistica e osservarne gli ingranaggi matematici. Il motore di un LLM poggia su due pilastri: il token e la previsione stocastica.
Che cos’è un token?
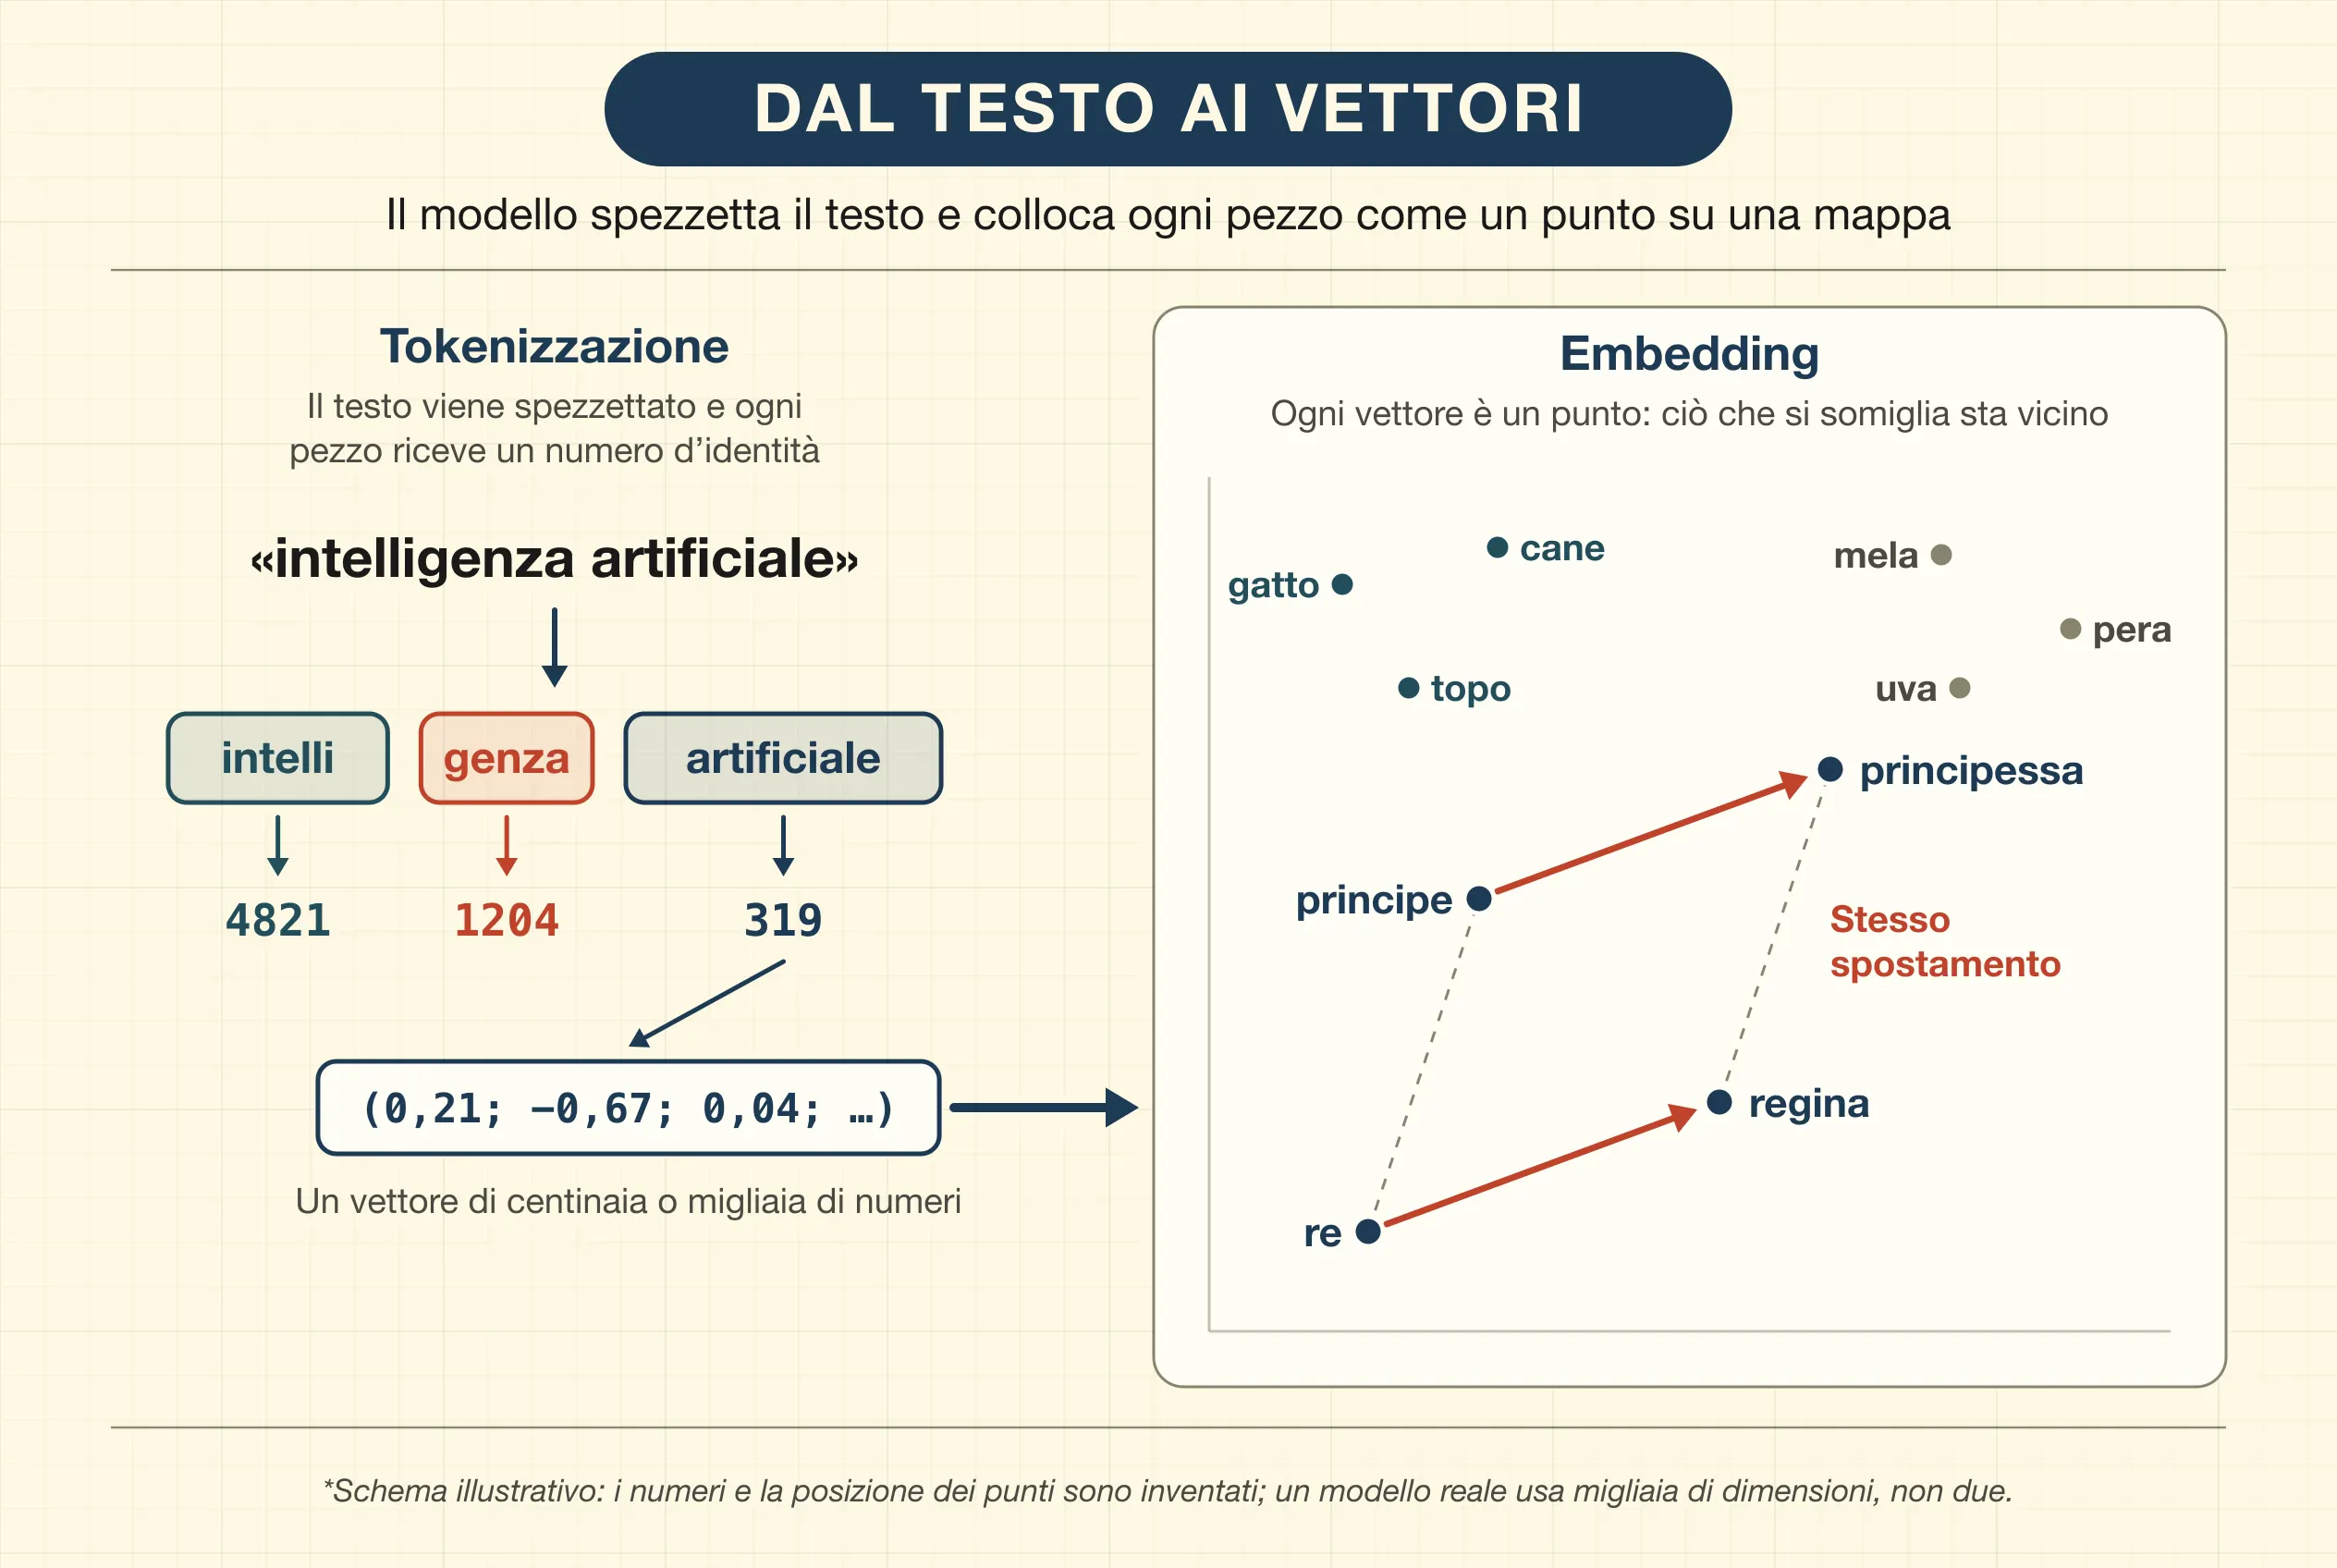
Un computer non capisce le parole come un essere umano. Non legge lettere né sillabe: elabora numeri. Per renderlo possibile, prima di elaborare un testo un LLM lo spezzetta con un algoritmo di tokenizzazione.
Un token non è necessariamente una parola completa: può essere una parola intera, una sillaba, un suffisso o perfino un singolo carattere (in inglese un token equivale in media a circa tre quarti di parola, ovvero a circa quattro caratteri). Per esempio, il tokenizzatore potrebbe scomporre l’espressione «intelligenza artificiale» in [intelli], [genza] e [ artificiale], e assegnare a ogni frammento un identificatore numerico univoco (per esempio [4821, 1204, 319]) all’interno di un vocabolario che di solito conta tra i 32.000 e i 250.000 token diversi.
Ogni token viene poi proiettato in uno spazio matematico con moltissime dimensioni sotto forma di vettore di incorporamento (embedding), dove le parole con significati o contesti simili finiscono vicine tra loro, come su una mappa. E le relazioni tra di esse si conservano: lo spostamento che porta da «re» a «regina» è molto simile a quello che porta da «principe» a «principessa».
La previsione stocastica
Una volta trasformato il testo in una sequenza di numeri e vettori, il cuore dell’LLM —un’architettura basata sul meccanismo di attenzione, il Transformer— svolge un compito in apparenza semplice, ma di una potenza colossale: prevedere il token successivo.
Un LLM non è una banca dati enciclopedica che cerca una risposta fissa in un archivio. È un motore probabilistico ad altissima dimensionalità. Davanti a una sequenza in ingresso (un prompt), la rete neurale applica le regolarità statistiche apprese da miliardi di testi e calcola una distribuzione di probabilità su quale debba essere il token successivo più coerente.
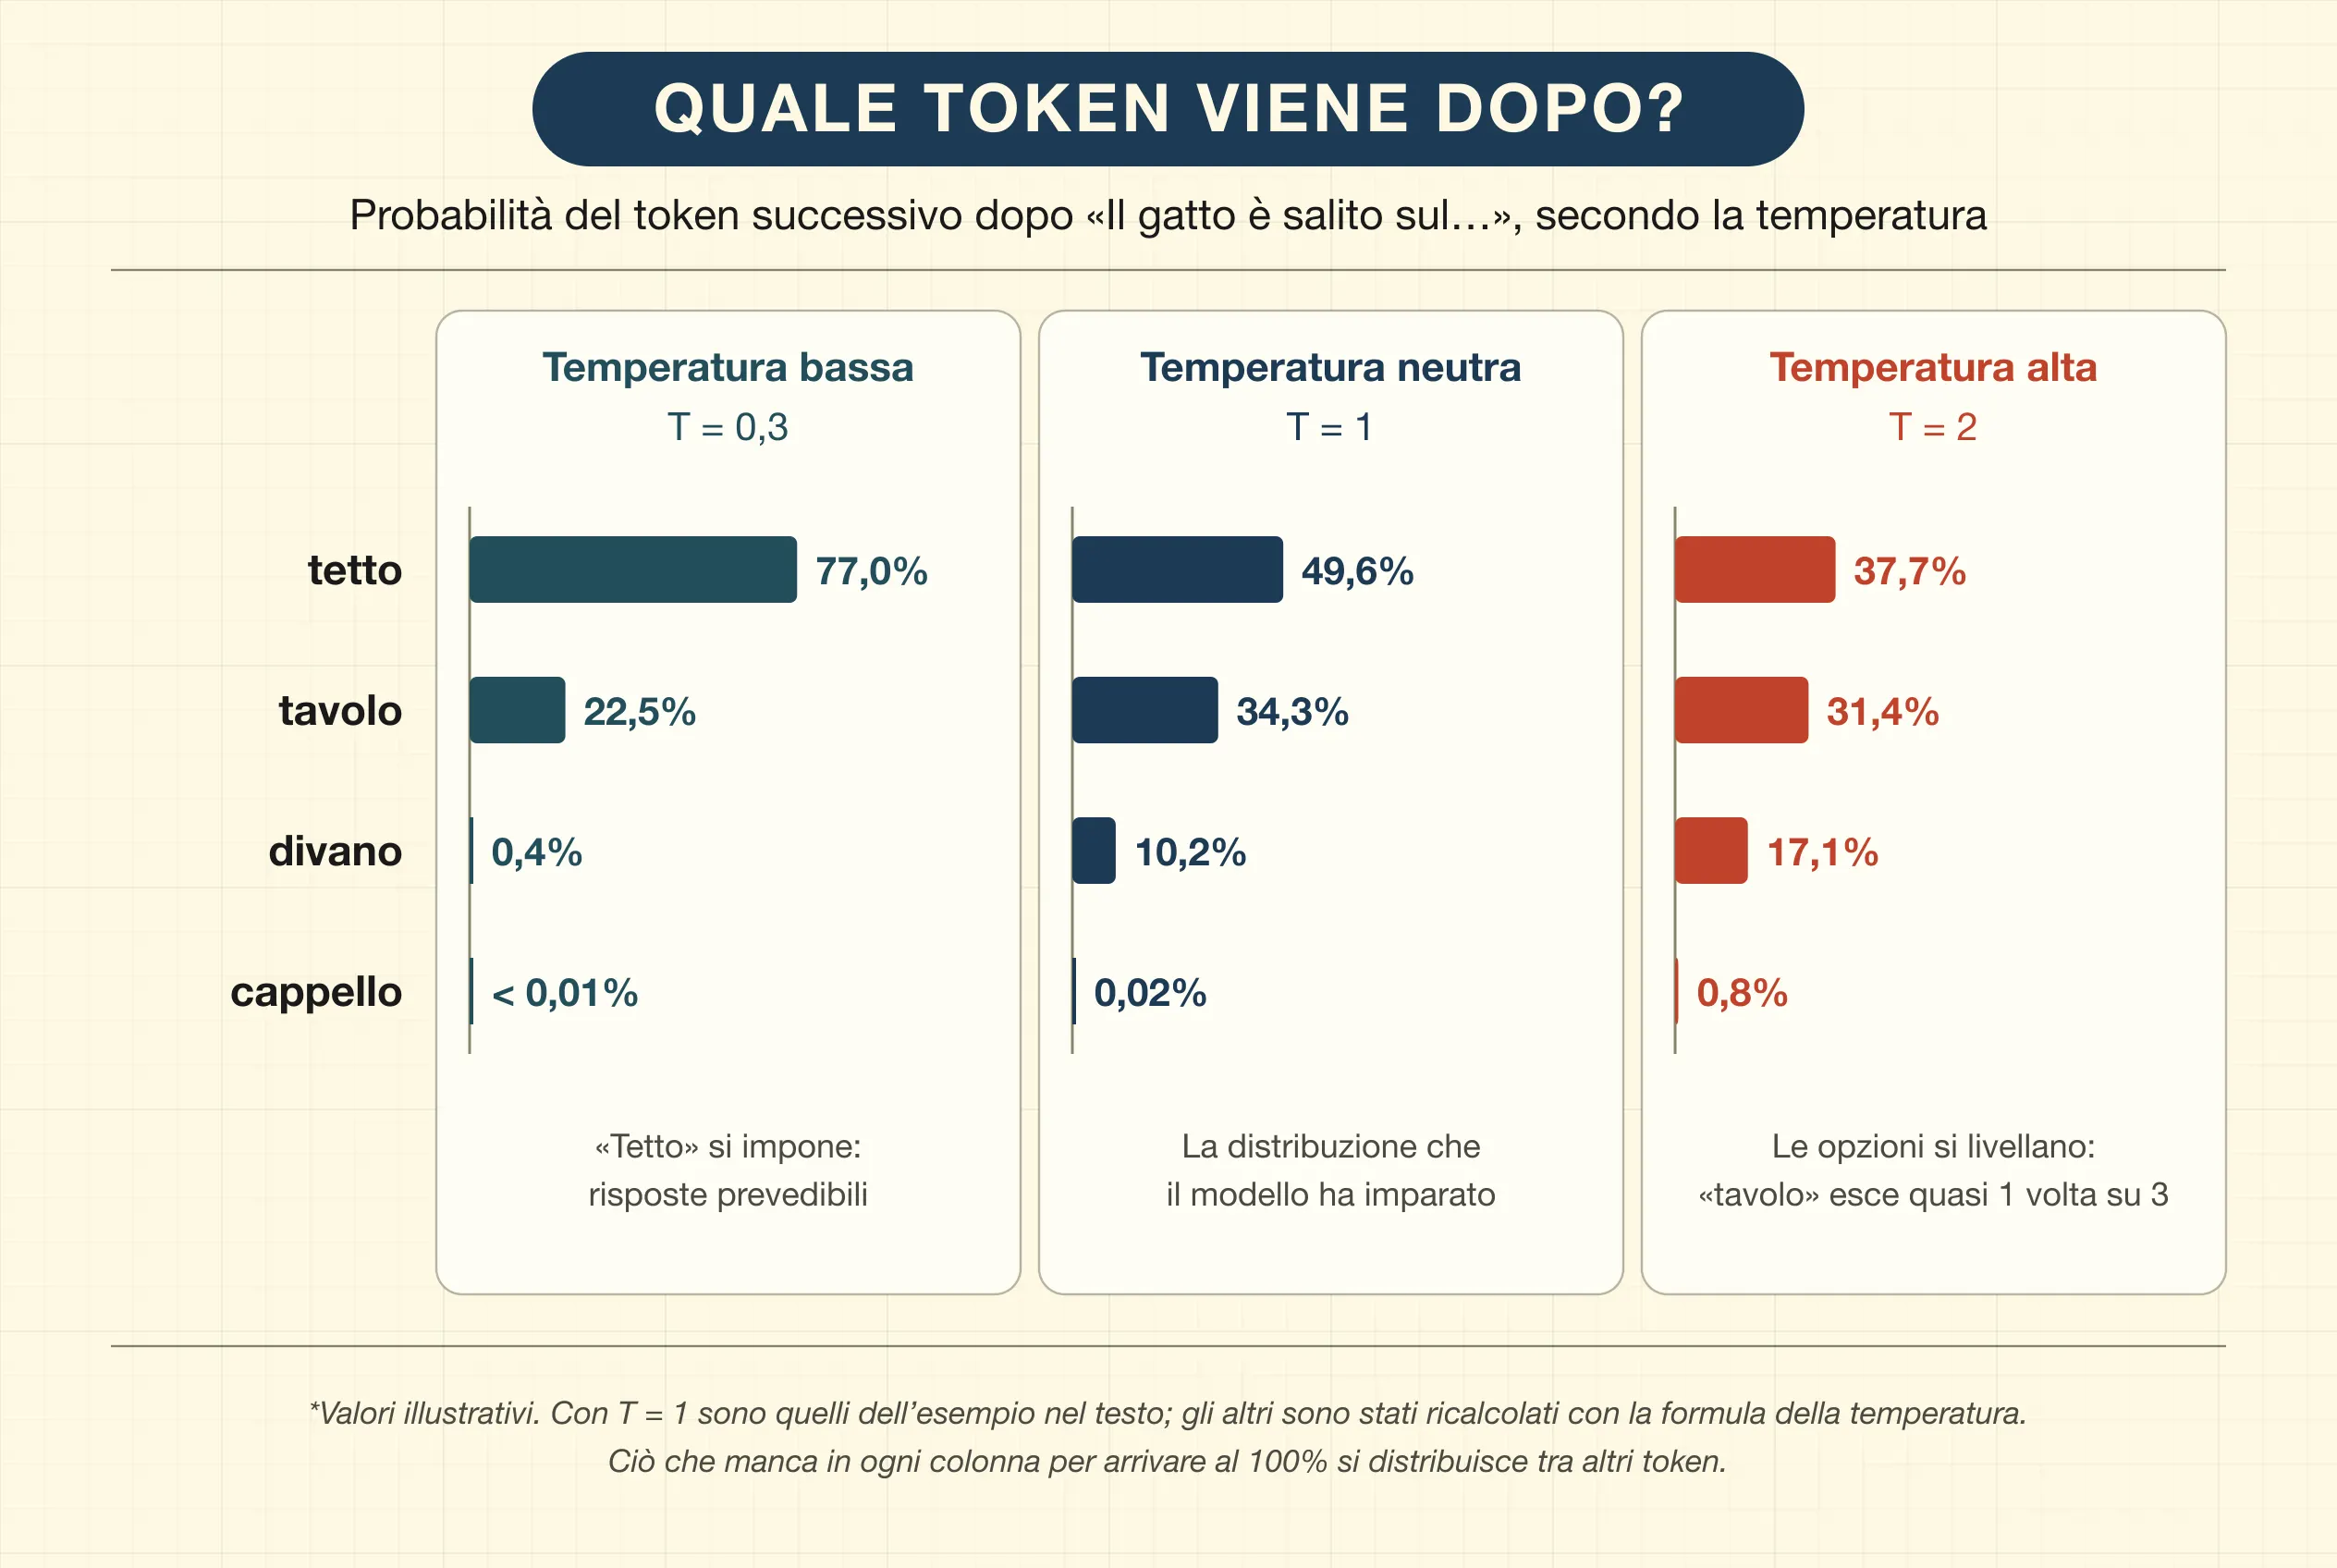
Se gli diamo la frase incompleta «Il gatto è salito sul…», il motore neurale non «pensa» a felini, a tetti o alla fisica della gravità. Ciò che fa è un enorme calcolo probabilistico attraverso i suoi pesi sinaptici, plasmati dai miliardi di testi che ha analizzato durante il pre-addestramento. Il modello restituisce una distribuzione di probabilità per il token successivo:
- tetto: 49,6%
- tavolo: 34,3%
- divano: 10,2%
- …
- cappello: 0,02%
Attraverso un parametro di controllo, la temperatura, il sistema sceglie a caso uno di questi token —con una netta preferenza per i più probabili, ma lasciando un certo margine alla variazione creativa— e ripete il processo, token dopo token, in modo ricorsivo.
Che cos’è la temperatura? Nei modelli linguistici, la temperatura è un parametro numerico che controlla il grado di casualità e di creatività del testo generato. Agisce sulle probabilità con cui il modello sceglie il token successivo: più bassa è la temperatura, più la risposta è deterministica e prevedibile; più è alta, più è creativa e varia.
Allo stesso modo, se scriviamo «Il gatto ha mangiato il…», il modello calcolerà che la probabilità che il token successivo sia «pesce» o «tonno» è altissima, mentre quella di «pianeta» o «violino» è praticamente nulla. Concatenando ad alta velocità migliaia di queste previsioni, nasce l’illusione di una conversazione fluida, coerente e creativa.
Questa fluidità stocastica, eseguita su scala colossale attraverso miliardi di parametri, è ciò che simula in modo così convincente la competenza cognitiva umana, e sfuma il confine tra il calcolo numerico e il discorso razionale.
Riferimenti e supporto scientifico
- L’articolo in cui Turing sostituì la domanda «le macchine possono pensare?» con il gioco dell’imitazione. Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433-460. Consultare l’articolo (DOI)
- La stanza cinese: manipolare simboli seguendo delle regole non basta per capire che cosa significano. Searle, J. R. (1980). Minds, brains, and programs. Behavioral and Brain Sciences, 3(3), 417-424. Consultare l’articolo (DOI)
- Il primo modello matematico del neurone: un’unità logica che si attiva o no a seconda dei segnali che riceve. McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115-133. Consultare l’articolo (DOI)
- Con il 2% del peso corporeo, il cervello assorbe il 20% della spesa metabolica e funziona con circa 20 watt, meno di un portatile. Balasubramanian, V. (2021). Brain power. Proceedings of the National Academy of Sciences, 118(32), e2107022118. Consultare l’articolo (DOI)
- Il conteggio che ha fissato in circa 86 miliardi i neuroni del cervello umano. Azevedo, F. A. C., Carvalho, L. R. B., Grinberg, L. T., Farfel, J. M., Ferretti, R. E. L., Leite, R. E. P., Jacob Filho, W., Lent, R., & Herculano-Houzel, S. (2009). Equal numbers of neuronal and nonneuronal cells make the human brain an isometrically scaled-up primate brain. The Journal of Comparative Neurology, 513(5), 532-541. Consultare lo studio (DOI)
- L’idea che imparare significhi rafforzare le connessioni tra neuroni che si attivano insieme. Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley. Consultare il libro (DOI)
- Il percettrone di Rosenblatt: una rete che impara a classificare regolando i propri pesi a partire da esempi. Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. Consultare l’articolo (DOI)
- Il limite di un solo strato: nessun percettrone semplice può imparare l’«or esclusivo». Minsky, M., & Papert, S. (1969). Perceptrons: An introduction to computational geometry. MIT Press. Consultare il libro (riedizione del 2017)
- La retropropagazione: come ripartire l’errore tra gli strati nascosti perché una rete a più strati possa imparare. Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533-536. Consultare lo studio (DOI)
- AlexNet, la rete profonda addestrata su GPU che nel 2012 staccò i rivali di dieci punti su ImageNet. Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2017). ImageNet classification with deep convolutional neural networks. Communications of the ACM, 60(6), 84-90 (pubblicato originariamente a NeurIPS 2012). Consultare lo studio (DOI)
- Che cosa vede ogni strato di una rete per la visione: bordi nei primi, forme in quelli intermedi, oggetti negli ultimi. Zeiler, M. D., & Fergus, R. (2014). Visualizing and understanding convolutional networks. Computer Vision – ECCV 2014, Lecture Notes in Computer Science, 8689, 818-833. Consultare lo studio (DOI)
- La rassegna dei tre pionieri del deep learning: imparare le rappresentazioni dai dati invece di progettarle a mano. LeCun, Y., Bengio, Y., & Hinton, G. (2015). Deep learning. Nature, 521(7553), 436-444. Consultare l’articolo (DOI)
- La tokenizzazione in sottoparole: spezzare le parole rare in frammenti frequenti. Sennrich, R., Haddow, B., & Birch, A. (2016). Neural machine translation of rare words with subword units. Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics, 1715-1725. Consultare lo studio (DOI)
- Le analogie nello spazio dei vettori: «re» sta a «regina» come «uomo» sta a «donna». Mikolov, T., Yih, W., & Zweig, G. (2013). Linguistic regularities in continuous space word representations. Proceedings of NAACL-HLT 2013, 746-751. Consultare lo studio su ACL Anthology
- L’articolo che presentò il Transformer, l’architettura basata solo sul meccanismo di attenzione su cui poggiano gli LLM attuali. Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998-6008. Consultare lo studio su arXiv
- GPT-3: un modello addestrato solo a prevedere il token successivo che, su larga scala, risolve compiti nuovi a partire da pochi esempi. Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., … & Amodei, D. (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems, 33, 1877-1901. Consultare lo studio su arXiv
- Come viene scelto ogni token: la temperatura e altre strategie di campionamento, e perché prendere sempre il più probabile produce testi ripetitivi. Holtzman, A., Buys, J., Du, L., Forbes, M., & Choi, Y. (2020). The curious case of neural text degeneration. International Conference on Learning Representations (ICLR). Consultare lo studio su arXiv
- La stanza cinese, quarant’anni dopo: i «pappagalli stocastici» che concatenano forme linguistiche senza accesso al loro significato. Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610-623. Consultare l’articolo (DOI)
Scrive di salute, nutrizione e delle certezze che nessuno rimette in discussione.
Stiamo preparando lo spazio per commentare gli articoli.
Continua a leggere
L'effetto Zeigarnik, o il prezzo delle idee brillanti
Il fenomeno psicologico che sabota il tuo riposo in nome della creatività
La procrastinazione e il sequestro limbico
Le neuroscienze dimostrano che la procrastinazione non è mancanza di volontà né di organizzazione, ma un meccanismo di difesa per regolare la frustrazione