Lo spettro dell'IA e la mappa del potere
Tre tipi di sistemi, tre poli geopolitici e la contesa tra i modelli aperti e i giganti chiusi
Quando l’opinione pubblica o i mezzi di informazione pronunciano la sigla «IA», tendono a farlo come se si riferissero a un monolite tecnologico, a un’entità onnisciente che opera secondo un unico schema. Eppure, nel panorama attuale dell’ingegneria informatica, mettere nello stesso calderone un algoritmo di raccomandazione dei contenuti, uno strumento di sintesi fotorealistica e un sistema autonomo capace di gestire una catena di approvvigionamento è un errore di analisi profondo.
L’intelligenza artificiale non è un prodotto finito, ma un vasto spettro di discipline matematiche e architetture software che si sono evolute in modo drastico. Per comprendere la reale portata di questa rivoluzione è indispensabile mettere ordine in questo zoo tecnologico: capire quali categorie di sistemi esistono, quali laboratori e interessi geopolitici ne guidano lo sviluppo e che cosa comporta per la società che il loro codice resti sotto chiave o si apra allo scrutinio pubblico.
Tipi di intelligenza artificiale
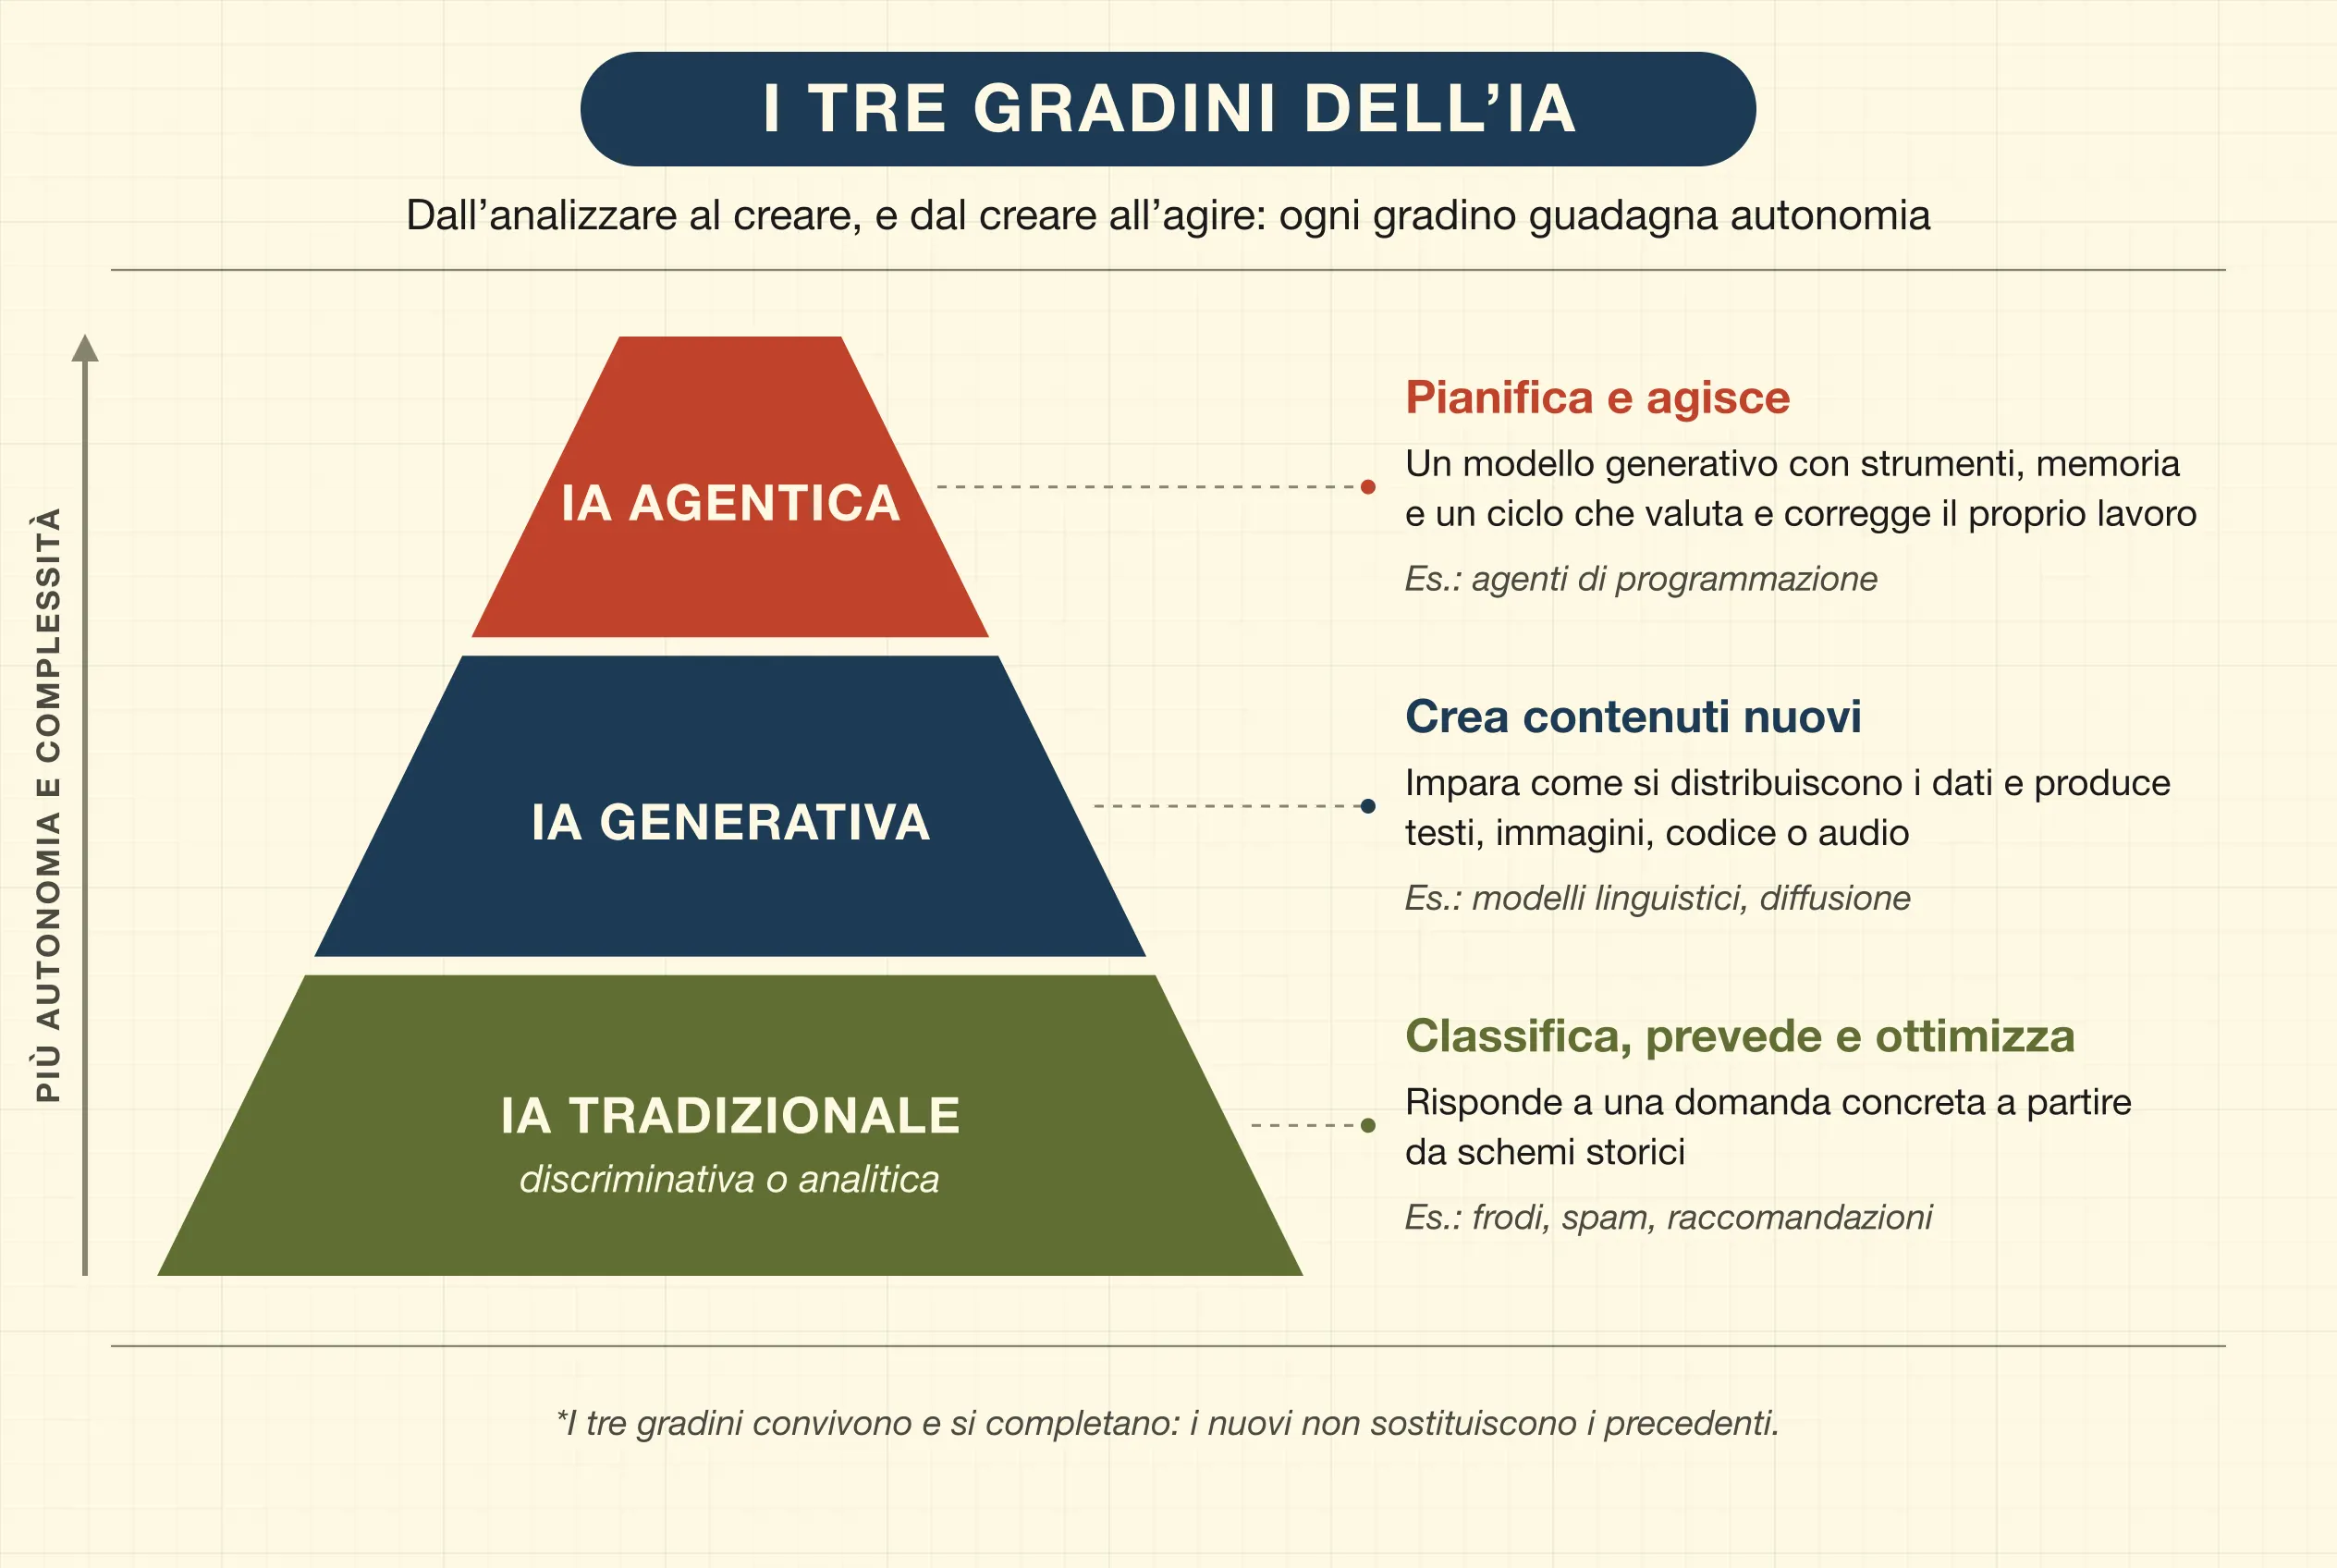
Dietro l’etichetta c’è una disciplina con più di settant’anni di storia e in continua espansione. Per mettere ordine, possiamo classificare i sistemi attuali in tre grandi gradini evolutivi in base al loro grado di autonomia e alla loro complessità strutturale. Non si sostituiscono a vicenda: convivono e si completano.
IA tradizionale
L’IA discriminativa o analitica è il fondamento storico su cui è stata costruita l’analisi dei dati moderna. Questi sistemi non creano contenuti originali; il loro scopo è classificare, prevedere e ottimizzare a partire da schemi storici strutturati.
- Come funziona: utilizza modelli statistici di regressione, alberi decisionali o reti neurali classiche per dare una risposta deterministica o probabilistica a una domanda concreta: questa operazione è fraudolenta? Che temperatura farà domani?
- Esempi: gli algoritmi che rilevano le transazioni fraudolente sulla tua carta di credito, i sistemi di previsione meteorologica, i filtri antispam della posta elettronica o i motori di raccomandazione di Spotify e Netflix. Sono strumenti molto efficienti, ma del tutto privi di flessibilità al di fuori del loro ambito specifico.
- Metafora: è come un ispettore esperto in una catena di montaggio che, dopo aver visto migliaia di pezzi, distingue all’istante quello difettoso da quello corretto secondo regole rigide.
IA generativa
Il grande fenomeno culturale di questo decennio. A differenza dell’IA discriminativa, che analizza il mondo esistente, l’IA generativa apprende la distribuzione statistica sottostante ai dati per produrre contenuti nuovi: testi, immagini, codice di programmazione o audio.
- Come funziona: davanti a un’istruzione (il prompt), ricorre ad architetture probabilistiche per costruire una risposta plausibile. Un modello linguistico calcola quale parola è probabile che venga dopo, ancora e ancora, fino ad articolare un discorso coerente; un modello di immagini parte da rumore casuale e lo ripulisce passo dopo passo finché non emerge un’immagine che corrisponde alla descrizione.
- Esempi: la scrittura di testi con modelli linguistici, la creazione di immagini tramite diffusione latente o la generazione di frammenti di codice.
- Metafora: un musicista jazz virtuoso che padroneggia tutte le scale e i generi del passato, capace di improvvisare una melodia nuova e coerente ogni volta che glielo si chiede, pur senza comprendere emotivamente il dolore o la gioia che evoca.
IA agentica
Rappresenta la frontiera operativa dello sviluppo tecnologico. Non si tratta più di un’IA che risponde a uno stimolo puntuale in una finestra di chat, ma di dotare il modello di autonomia, memoria e capacità di pianificazione.
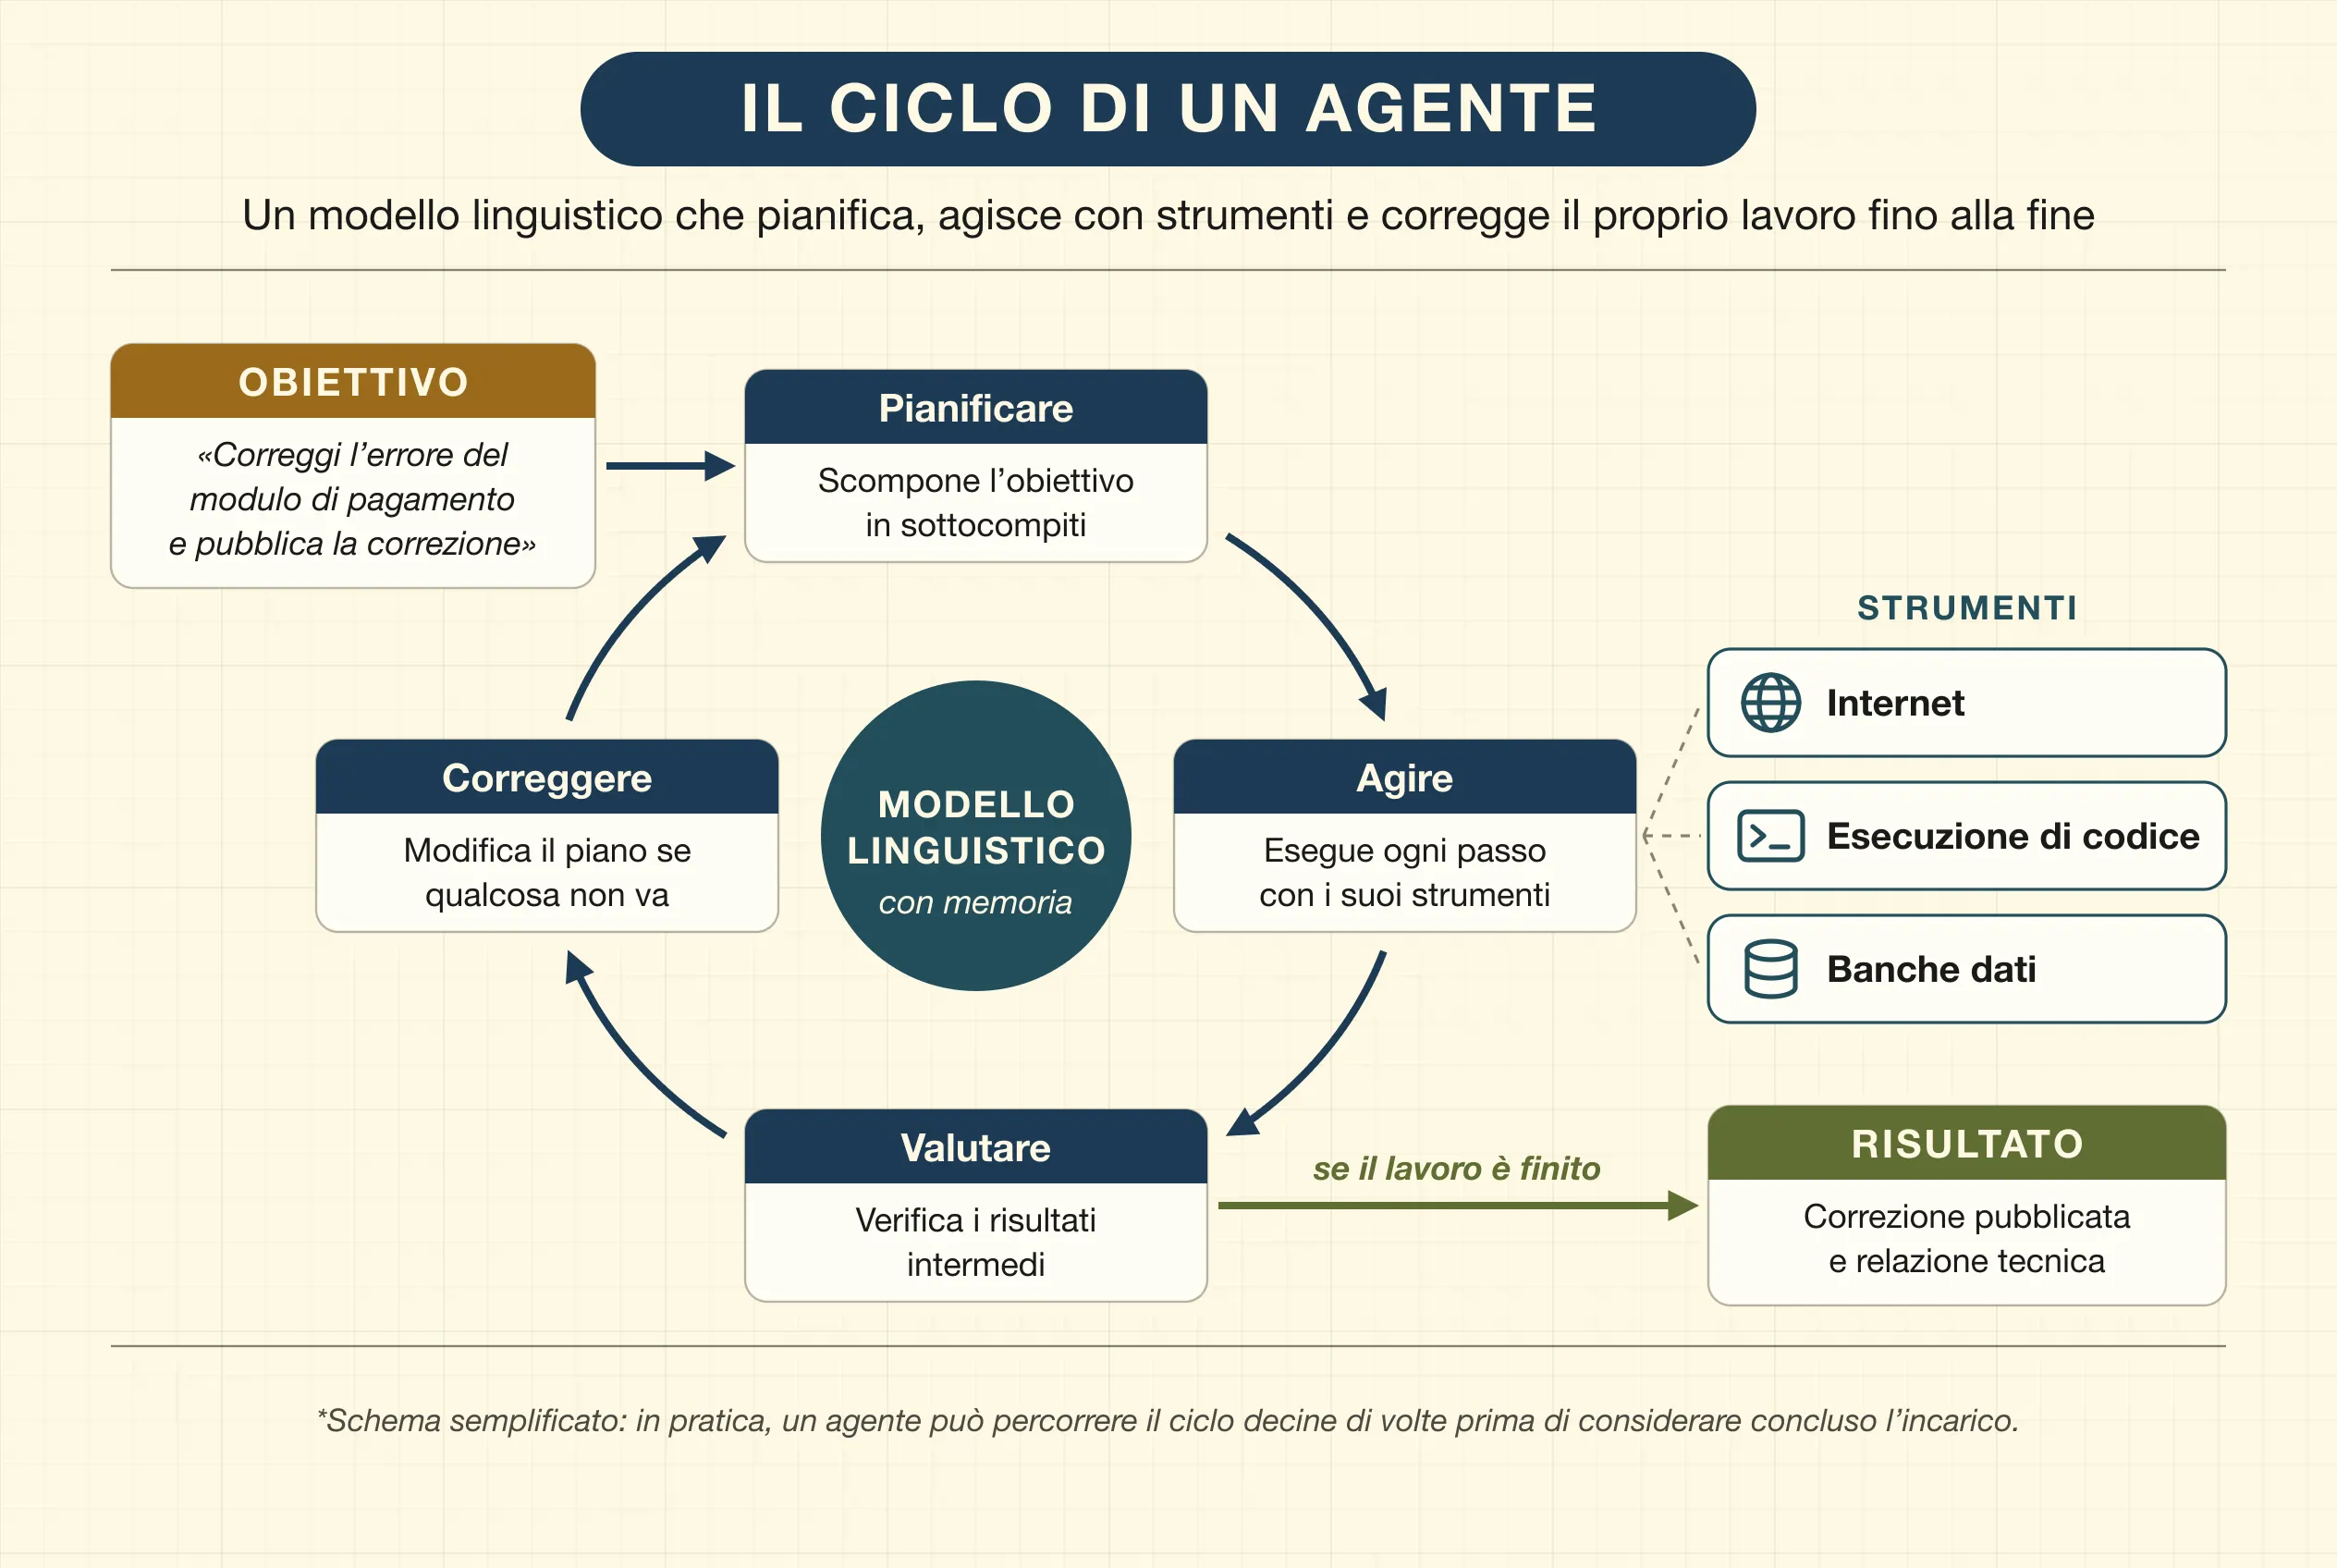
- Come funziona: combina un modello linguistico generativo con un insieme di strumenti esterni (accesso a internet, esecuzione di codice, banche dati) e un ciclo di ragionamento iterativo. L’agente riceve un obiettivo di alto livello, lo scompone in sottocompiti, esegue azioni, valuta i risultati intermedi e corregge i propri errori fino a portare a termine l’incarico.
- Esempi: assistenti di programmazione capaci di esaminare intere basi di codice, correggere errori, distribuire il risultato sui server e redigere la relazione tecnica senza un intervento umano costante.
- Limite fondamentale: l’affidabilità sul lungo periodo e la gestione dell’incertezza quando affrontano scenari del mondo reale che non erano previsti nella loro progettazione.
Mentre l’IA discriminativa cerca la precisione nell’analisi e quella generativa la verosimiglianza nella sintesi, l’IA agentica introduce l’agentività funzionale: chiude il cerchio tra il pensiero computazionale e l’azione nel mondo reale.
La mappa del potere globale
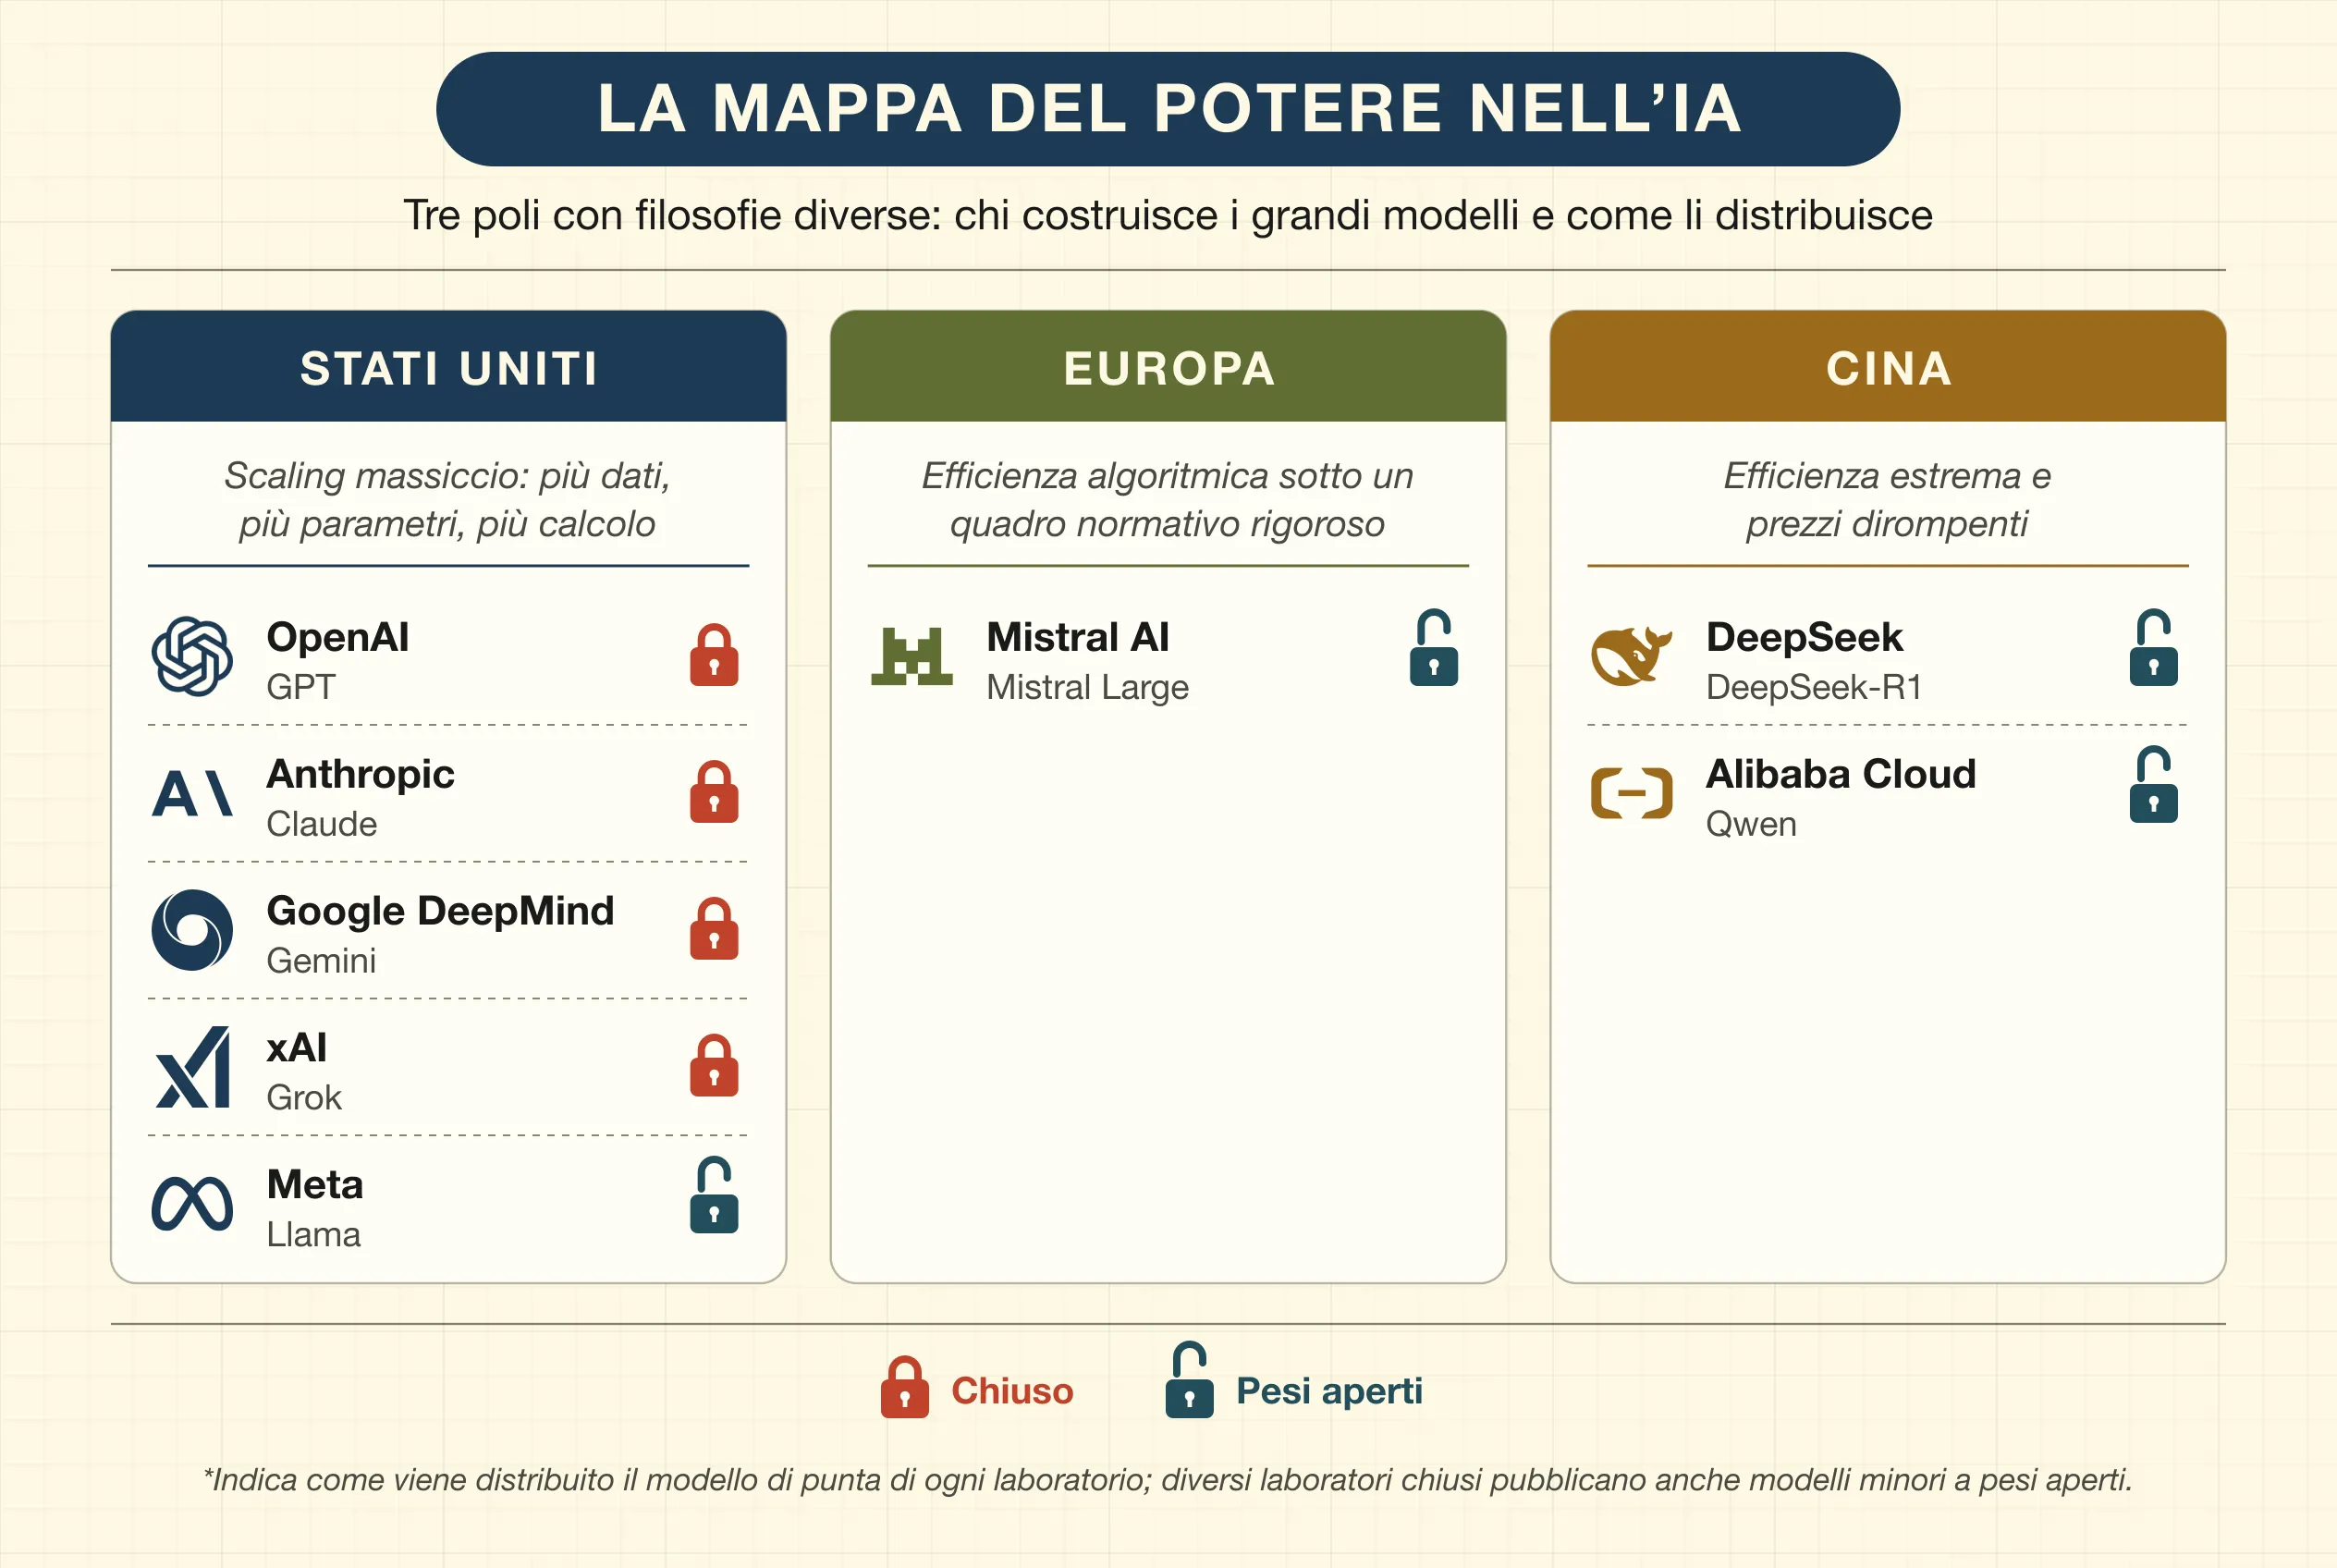
Così come la geopolitica del Novecento è stata segnata dal controllo del petrolio e delle rotte marittime, il XXI secolo si definisce per la sovranità sul silicio avanzato, sui dati e sul talento algoritmico. Oggi l’ecosistema globale dell’IA si articola attorno a tre grandi poli con filosofie, incentivi e modelli di business radicalmente diversi.
L’asse della Silicon Valley
Gli Stati Uniti continuano a ospitare i giganti commerciali che spingono oltre i limiti delle prestazioni pure, in genere con modelli chiusi.
- Filosofia: puntare sullo scaling massiccio (le cosiddette leggi di scala o scaling laws). La premessa è semplice: più dati, più parametri e più potenza di calcolo (GPU), più il modello diventa capace.
- Modello di business: vicino al monopolio di piattaforma. Investimenti miliardari provenienti dal capitale di rischio e dalle grandi aziende tecnologiche (Big Tech), messi a reddito tramite abbonamenti per i consumatori e API proprietarie per le imprese.
Attori chiave
- OpenAI: il grande catalizzatore commerciale dell’era moderna, grazie alla sua saga GPT e alla sua alleanza strategica con Microsoft.
- Anthropic: fondata da ex dipendenti di OpenAI, si distingue per la sua famiglia di modelli Claude e per aver messo la sicurezza e l’allineamento etico al centro del proprio sviluppo.
- Google DeepMind: la potenza scientifica per eccellenza. Artefice di traguardi come AlphaFold, che predice la struttura tridimensionale delle proteine a partire dalla loro sequenza e ha valso ai suoi creatori il Nobel per la Chimica 2024, riversa la sua forza di ricerca nell’ecosistema Gemini.
- xAI: la scommessa di Elon Musk con il modello Grok, caratterizzata dall’integrazione diretta con dati in tempo reale e da filtri sui contenuti meno restrittivi.
Europa
L’Europa compete da una posizione atipica: con un investimento in capacità di calcolo molto inferiore a quello di Stati Uniti o Cina, ha scelto l’eccellenza nella ricerca e l’efficienza algoritmica.
- Filosofia: massimizzare le prestazioni per parametro, privilegiando modelli che possano girare su infrastrutture locali o europee, sotto l’ombrello di un quadro normativo rigoroso (il Regolamento sull’intelligenza artificiale o AI Act).
- Modello di business: nell’impossibilità finanziaria di competere con i giganti statunitensi nella costruzione dei più grandi supercomputer del mondo, l’ecosistema europeo si specializza nell’ottimizzazione. Sviluppa architetture leggere, flessibili e multilingue che offrono prestazioni eccellenti con una frazione del costo computazionale ed energetico.
Attore chiave
- Mistral AI: il grande portabandiera europeo. Con sede a Parigi, ha dimostrato che è possibile competere nell’élite mondiale con modelli efficienti, molti dei quali a pesi aperti, che rivaleggiano con quelli statunitensi consumando una frazione delle loro risorse di calcolo.
Asia (soprattutto la Cina)
L’Asia ha ridisegnato la scacchiera con progressi dirompenti che sfidano l’idea che si possa avanzare solo a colpi di budget miliardari.
- Filosofia: efficienza estrema, reinvenzione dei metodi di addestramento per ridurre drasticamente il consumo di risorse e agilità nell’adozione di massa.
- Modello di business: modelli aperti o a bassissimo costo che rompono i prezzi dei monopoli occidentali e avvicinano capacità di frontiera alle economie emergenti.
Attori chiave
- DeepSeek: il grande disgregatore. All’inizio del 2025 ha scosso il settore con R1, un modello di ragionamento a pesi aperti che rendeva al livello dei migliori laboratori occidentali con un investimento in addestramento drasticamente inferiore.
- Alibaba Cloud: sviluppa la famiglia Qwen, una delle opzioni a pesi aperti più potenti, multilingue e versatili al mondo, con capacità di elaborazione del testo, visione artificiale e programmazione avanzata.
Modelli chiusi e modelli a pesi aperti
All’interno dell’ecosistema del software esiste un dibattito tecnico e filosofico intenso quanto quello geopolitico: la tensione tra i modelli chiusi e quelli a pesi aperti (open weights).
Questa dicotomia definisce il vero campo di battaglia del presente: un braccio di ferro tra la concentrazione del potere cognitivo nelle mani di una manciata di multinazionali e la sua decentralizzazione come bene pubblico digitale.
Modelli proprietari (chiusi)
Sono quelli le cui viscere tecniche, il cui codice sorgente e i cui pesi neurali restano sotto stretto segreto commerciale. L’utente interagisce con essi esclusivamente tramite applicazioni o interfacce di programmazione (API).
- Vantaggi: massimo livello di sicurezza gestito dal fornitore, assistenza tecnica diretta, ottimizzazione estrema per il consumatore finale e grandi investimenti nell’allineamento etico.
- Svantaggi: dipendenza assoluta da un fornitore esterno (vendor lock-in), opacità su come sono stati trattati i dati di addestramento e vulnerabilità di fronte a modifiche unilaterali delle condizioni di servizio o delle tariffe.
Modelli a pesi aperti
Sono quelli i cui file dei pesi neurali vengono pubblicati perché qualsiasi ricercatore, azienda o cittadino possa scaricarli, verificarli, modificarli ed eseguirli sul proprio hardware. Il portabandiera più noto di questa filosofia è stata la famiglia Llama di Meta.
- Vantaggi: sovranità assoluta sui dati, possibilità di personalizzazione locale (fine-tuning) senza che le informazioni riservate escano dai server dell’organizzazione, verificabilità scientifica e resistenza alla censura aziendale o governativa.
- Svantaggi: richiedono competenze tecniche avanzate per la messa in produzione e la manutenzione, e le loro barriere di sicurezza possono essere rimosse, il che facilita usi malevoli se non vengono gestiti con responsabilità.
Conviene non confondere pesi aperti con open source. Ciò che viene pubblicato sono i parametri del modello già addestrato, ma quasi mai i dati né il codice con cui è stato addestrato, e le licenze spesso limitano certi usi. Un modello a pesi aperti si può eseguire e adattare, ma non ricostruire da zero. Esistono anche modelli totalmente aperti, come OLMo dell’Allen Institute for AI, che pubblicano anche i dati e il codice di addestramento, ma sono l’eccezione.
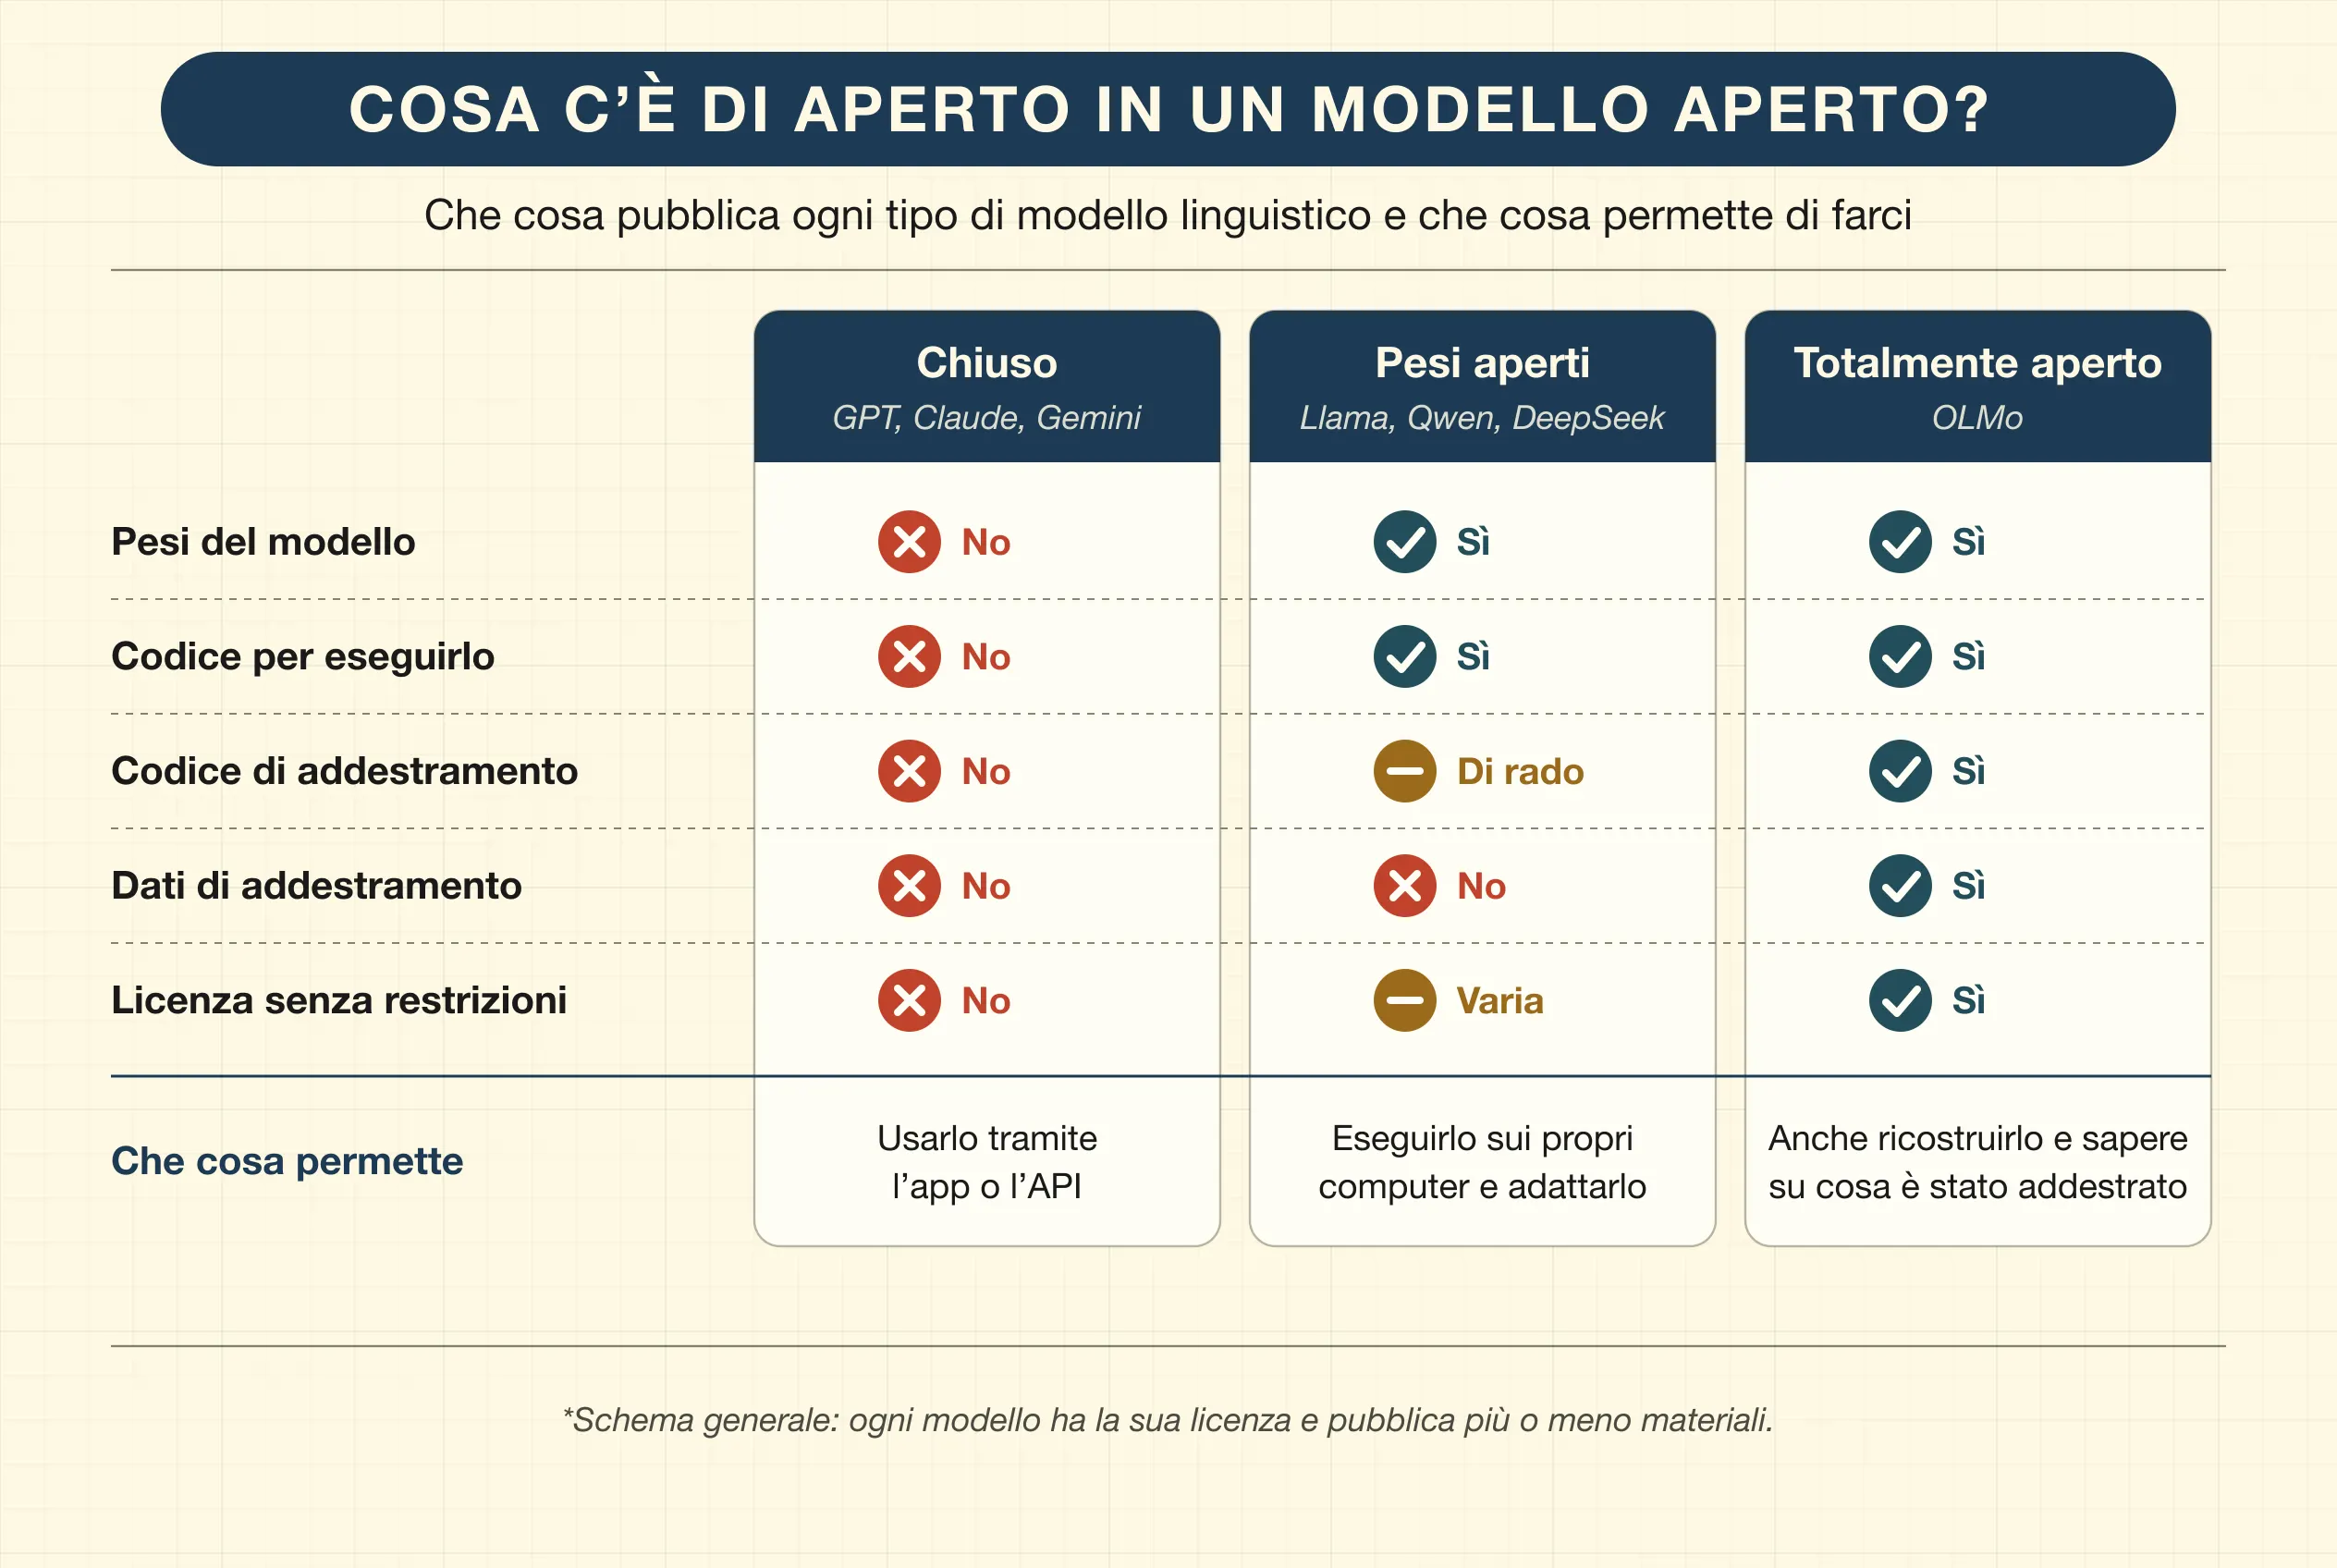
Tabella riassuntiva
| Caratteristica | Modelli proprietari (chiusi) | Modelli a pesi aperti (open weights) |
|---|---|---|
| Accesso all’interno | Nascosto dietro un’applicazione o un’API commerciale. L’utente si limita a usare il servizio. | I pesi neurali (weights) si scaricano liberamente per studiarli o modificarli. |
| Controllo e privacy | I dati viaggiano verso server di terzi, soggetti alle loro politiche di conservazione. | Si eseguono in locale o su server propri: sovranità assoluta sui dati. |
| Sicurezza e moderazione | Filtri rigidi integrati dal produttore (allineamento commerciale). | Si possono personalizzare e persino privare dell’allineamento; l’utente si assume la responsabilità dell’uso etico. |
| Costi operativi | Pagamento a consumo (token elaborati tramite l’API del fornitore). | Costo dell’infrastruttura propria (hardware, GPU) o noleggio di server nel cloud. |
| Esempi di rilievo | GPT-6.1 Terra (OpenAI), Claude Opus 5.5 (Anthropic), Gemini 4 Carbon (Google). | Llama 4 (Meta), Qwen (Alibaba), Mistral Large (Mistral AI). |
Una breve riflessione
L’ascesa dei modelli a pesi aperti rappresenta un contrappeso fondamentale ai monopoli, a favore della democrazia tecnologica. Se la conoscenza scientifica dell’intelligenza artificiale restasse confinata nei server ermetici di tre o quattro multinazionali, la società perderebbe la capacità di verificare, regolamentare e adattare questi strumenti a esigenze locali, scientifiche o sociali specifiche.
I modelli aperti agiscono come un bene pubblico digitale: permettono a università, ospedali, piccole imprese e sviluppatori indipendenti di sperimentare, verificare i pregiudizi e costruire soluzioni su misura senza dipendere dal benestare di un unico fornitore commerciale.
Riferimenti e supporto scientifico
- La distinzione classica tra i due approcci: un modello discriminativo impara a separare le classi; uno generativo, come si distribuiscono i dati di ciascuna. Ng, A. Y., & Jordan, M. I. (2001). On discriminative vs. generative classifiers: A comparison of logistic regression and naive Bayes. Advances in Neural Information Processing Systems, 14, 841-848. Consultare lo studio su NeurIPS
- Come funziona dall’interno il sistema di raccomandazione di Netflix, raccontato dai suoi responsabili, e quanto vale per l’azienda. Gomez-Uribe, C. A., & Hunt, N. (2015). The Netflix recommender system: Algorithms, business value, and innovation. ACM Transactions on Management Information Systems, 6(4), 13. Consultare l’articolo (DOI)
- Il rapporto che ha coniato il termine «modelli fondazionali»: sistemi generali addestrati su vasta scala e poi adattati a compiti specifici. Bommasani, R., Hudson, D. A., Adeli, E., Altman, R., Arora, S., … & Liang, P. (2021). On the opportunities and risks of foundation models. arXiv, 2108.07258. Consultare lo studio su arXiv
- La diffusione latente: generare un’immagine eliminando il rumore passo dopo passo, in uno spazio compresso che rende il calcolo più economico. Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-resolution image synthesis with latent diffusion models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 10674-10685. Consultare lo studio (DOI)
- Lo schema seguito da molti agenti: alternare il ragionamento ad azioni con strumenti e correggere il piano in base a ciò che restituiscono. Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2023). ReAct: Synergizing reasoning and acting in language models. International Conference on Learning Representations (ICLR). Consultare lo studio su arXiv
- Una rassegna degli agenti basati su modelli linguistici: pianificazione, memoria, uso di strumenti e loro limiti. Wang, L., Ma, C., Feng, X., Zhang, Z., Yang, H., Zhang, J., Chen, Z., Tang, J., Chen, X., Lin, Y., Zhao, W. X., Wei, Z., & Wen, J. (2024). A survey on large language model based autonomous agents. Frontiers of Computer Science, 18(6), 186345. Consultare l’articolo (DOI)
- Le leggi di scala: le prestazioni di un modello linguistico migliorano in modo prevedibile all’aumentare di parametri, dati e calcolo. Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., … & Amodei, D. (2020). Scaling laws for neural language models. arXiv, 2001.08361. Consultare lo studio su arXiv
- La correzione a quelle leggi: a parità di budget di calcolo, conviene addestrare modelli più piccoli con molti più dati. Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., … & Sifre, L. (2022). Training compute-optimal large language models. Advances in Neural Information Processing Systems, 35, 30016-30030. Consultare lo studio su arXiv
- AlphaFold: la previsione della struttura delle proteine con una precisione vicina a quella sperimentale. Jumper, J., Evans, R., Pritzel, A., Green, T., Figurnov, M., … & Hassabis, D. (2021). Highly accurate protein structure prediction with AlphaFold. Nature, 596(7873), 583-589. Consultare l’articolo (DOI)
- I dati della ripartizione globale: quanti modelli di rilievo escono da Stati Uniti, Cina ed Europa, e come si riduce la distanza tra loro. Maslej, N., Fattorini, L., Perrault, R., Gil, Y., Parli, V., … & Oak, S. (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence. Consultare il rapporto su arXiv
- Il regolamento europeo sull’intelligenza artificiale, che classifica i sistemi in base al rischio e fissa obblighi per i modelli per finalità generali. Parlamento europeo e Consiglio dell’Unione europea. (2024). Regolamento (UE) 2024/1689 che stabilisce regole armonizzate sull’intelligenza artificiale. Gazzetta ufficiale dell’Unione europea, L 2024/1689. Consultare il testo su EUR-Lex
- Il primo modello di Mistral: con 7 miliardi di parametri, superava modelli aperti di quasi il doppio delle dimensioni. Jiang, A. Q., Sablayrolles, A., Mensch, A., Bamford, C., Chaplot, D. S., … & El Sayed, W. (2023). Mistral 7B. arXiv, 2310.06825. Consultare lo studio su arXiv
- Come DeepSeek ha addestrato un modello di frontiera con una frazione del calcolo abituale. DeepSeek-AI. (2024). DeepSeek-V3 technical report. arXiv, 2412.19437. Consultare il rapporto su arXiv
- DeepSeek-R1: la capacità di ragionare passo dopo passo, ottenuta con l’apprendimento per rinforzo e pubblicata a pesi aperti. Guo, D., Yang, D., Zhang, H., Song, J., Wang, P., Zhu, Q., … & Zhang, Z. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645(8081), 633-638. Consultare l’articolo (DOI)
- La famiglia Qwen3 di Alibaba: modelli a pesi aperti, dai piccoli ai molto grandi, in più di un centinaio di lingue. Yang, A., Li, A., Yang, B., Zhang, B., Hui, B., … & Qiu, Z. (2025). Qwen3 technical report. arXiv, 2505.09388. Consultare il rapporto su arXiv
- Il primo Llama: modelli competitivi addestrati solo su dati pubblici e messi a disposizione della comunità scientifica. Touvron, H., Lavril, T., Izacard, G., Martinet, X., Lachaux, M.-A., … & Lample, G. (2023). LLaMA: Open and efficient foundation language models. arXiv, 2302.13971. Consultare lo studio su arXiv
- Che cosa pubblica davvero ogni modello «aperto»: la maggior parte condivide i pesi, ma non i dati né il codice di addestramento. Liesenfeld, A., & Dingemanse, M. (2024). Rethinking open source generative AI: Open washing and the EU AI Act. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency, 1774-1787. Consultare lo studio (DOI)
- OLMo: un modello totalmente aperto, pubblicato con i suoi dati, il codice di addestramento e i registri perché chiunque possa studiarlo e riprodurlo. Groeneveld, D., Beltagy, I., Walsh, E., Bhagia, A., Kinney, R., Tafjord, O., … & Hajishirzi, H. (2024). OLMo: Accelerating the science of language models. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics, 15789-15809. Consultare lo studio (DOI)
- Perché l’apertura non basta a decentralizzare l’IA finché calcolo, dati e talento restano concentrati in poche aziende. Widder, D. G., Whittaker, M., & West, S. M. (2024). Why ‘open’ AI systems are actually closed, and why this matters. Nature, 635(8040), 827-833. Consultare l’articolo (DOI)
- Benefici e rischi dei modelli aperti, misurati rispetto a ciò che già consentono i modelli chiusi e altre tecnologie. Kapoor, S., Bommasani, R., Klyman, K., Longpre, S., Ramaswami, A., … & Narayanan, A. (2024). On the societal impact of open foundation models. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 23082-23104. Consultare lo studio su PMLR
Scrive di salute, nutrizione e delle certezze che nessuno rimette in discussione.
Stiamo preparando lo spazio per commentare gli articoli.
Continua a leggere
Il cuore nella pelle
Come la radiazione ultravioletta libera l'ossido nitrico della pelle per regolare la pressione arteriosa e contrastare il rischio cardiovascolare
L'effetto Zeigarnik, o il prezzo delle idee brillanti
Il fenomeno psicologico che sabota il tuo riposo in nome della creatività
Acqua strutturata: il terreno della salute
La batteria liquida delle tue cellule e come proteggerla dall'ambiente moderno