El espectro de la IA y el mapa del poder
Tres tipos de sistemas, tres polos geopolíticos y la pugna entre los modelos abiertos y los gigantes cerrados
Cuando la opinión pública o los medios de comunicación pronuncian las siglas «IA», suelen hacerlo como si se refirieran a un monolito tecnológico, a una entidad omnisciente que opera bajo un único patrón. Sin embargo, en el panorama actual de la ingeniería informática, meter en el mismo saco a un algoritmo de recomendación de contenidos, a una herramienta de síntesis fotorrealista y a un sistema autónomo capaz de gestionar una cadena de suministro es un error analítico profundo.
La inteligencia artificial no es un producto acabado, sino un vasto espectro de disciplinas matemáticas y arquitecturas de software que han evolucionado de forma drástica. Para comprender el verdadero alcance de esta revolución, es imprescindible poner orden en este zoo tecnológico: entender qué categorías de sistemas existen, qué laboratorios e intereses geopolíticos impulsan su desarrollo y qué implicaciones tiene para la sociedad que su código se mantenga bajo llave o se abra al escrutinio público.
Tipos de inteligencia artificial
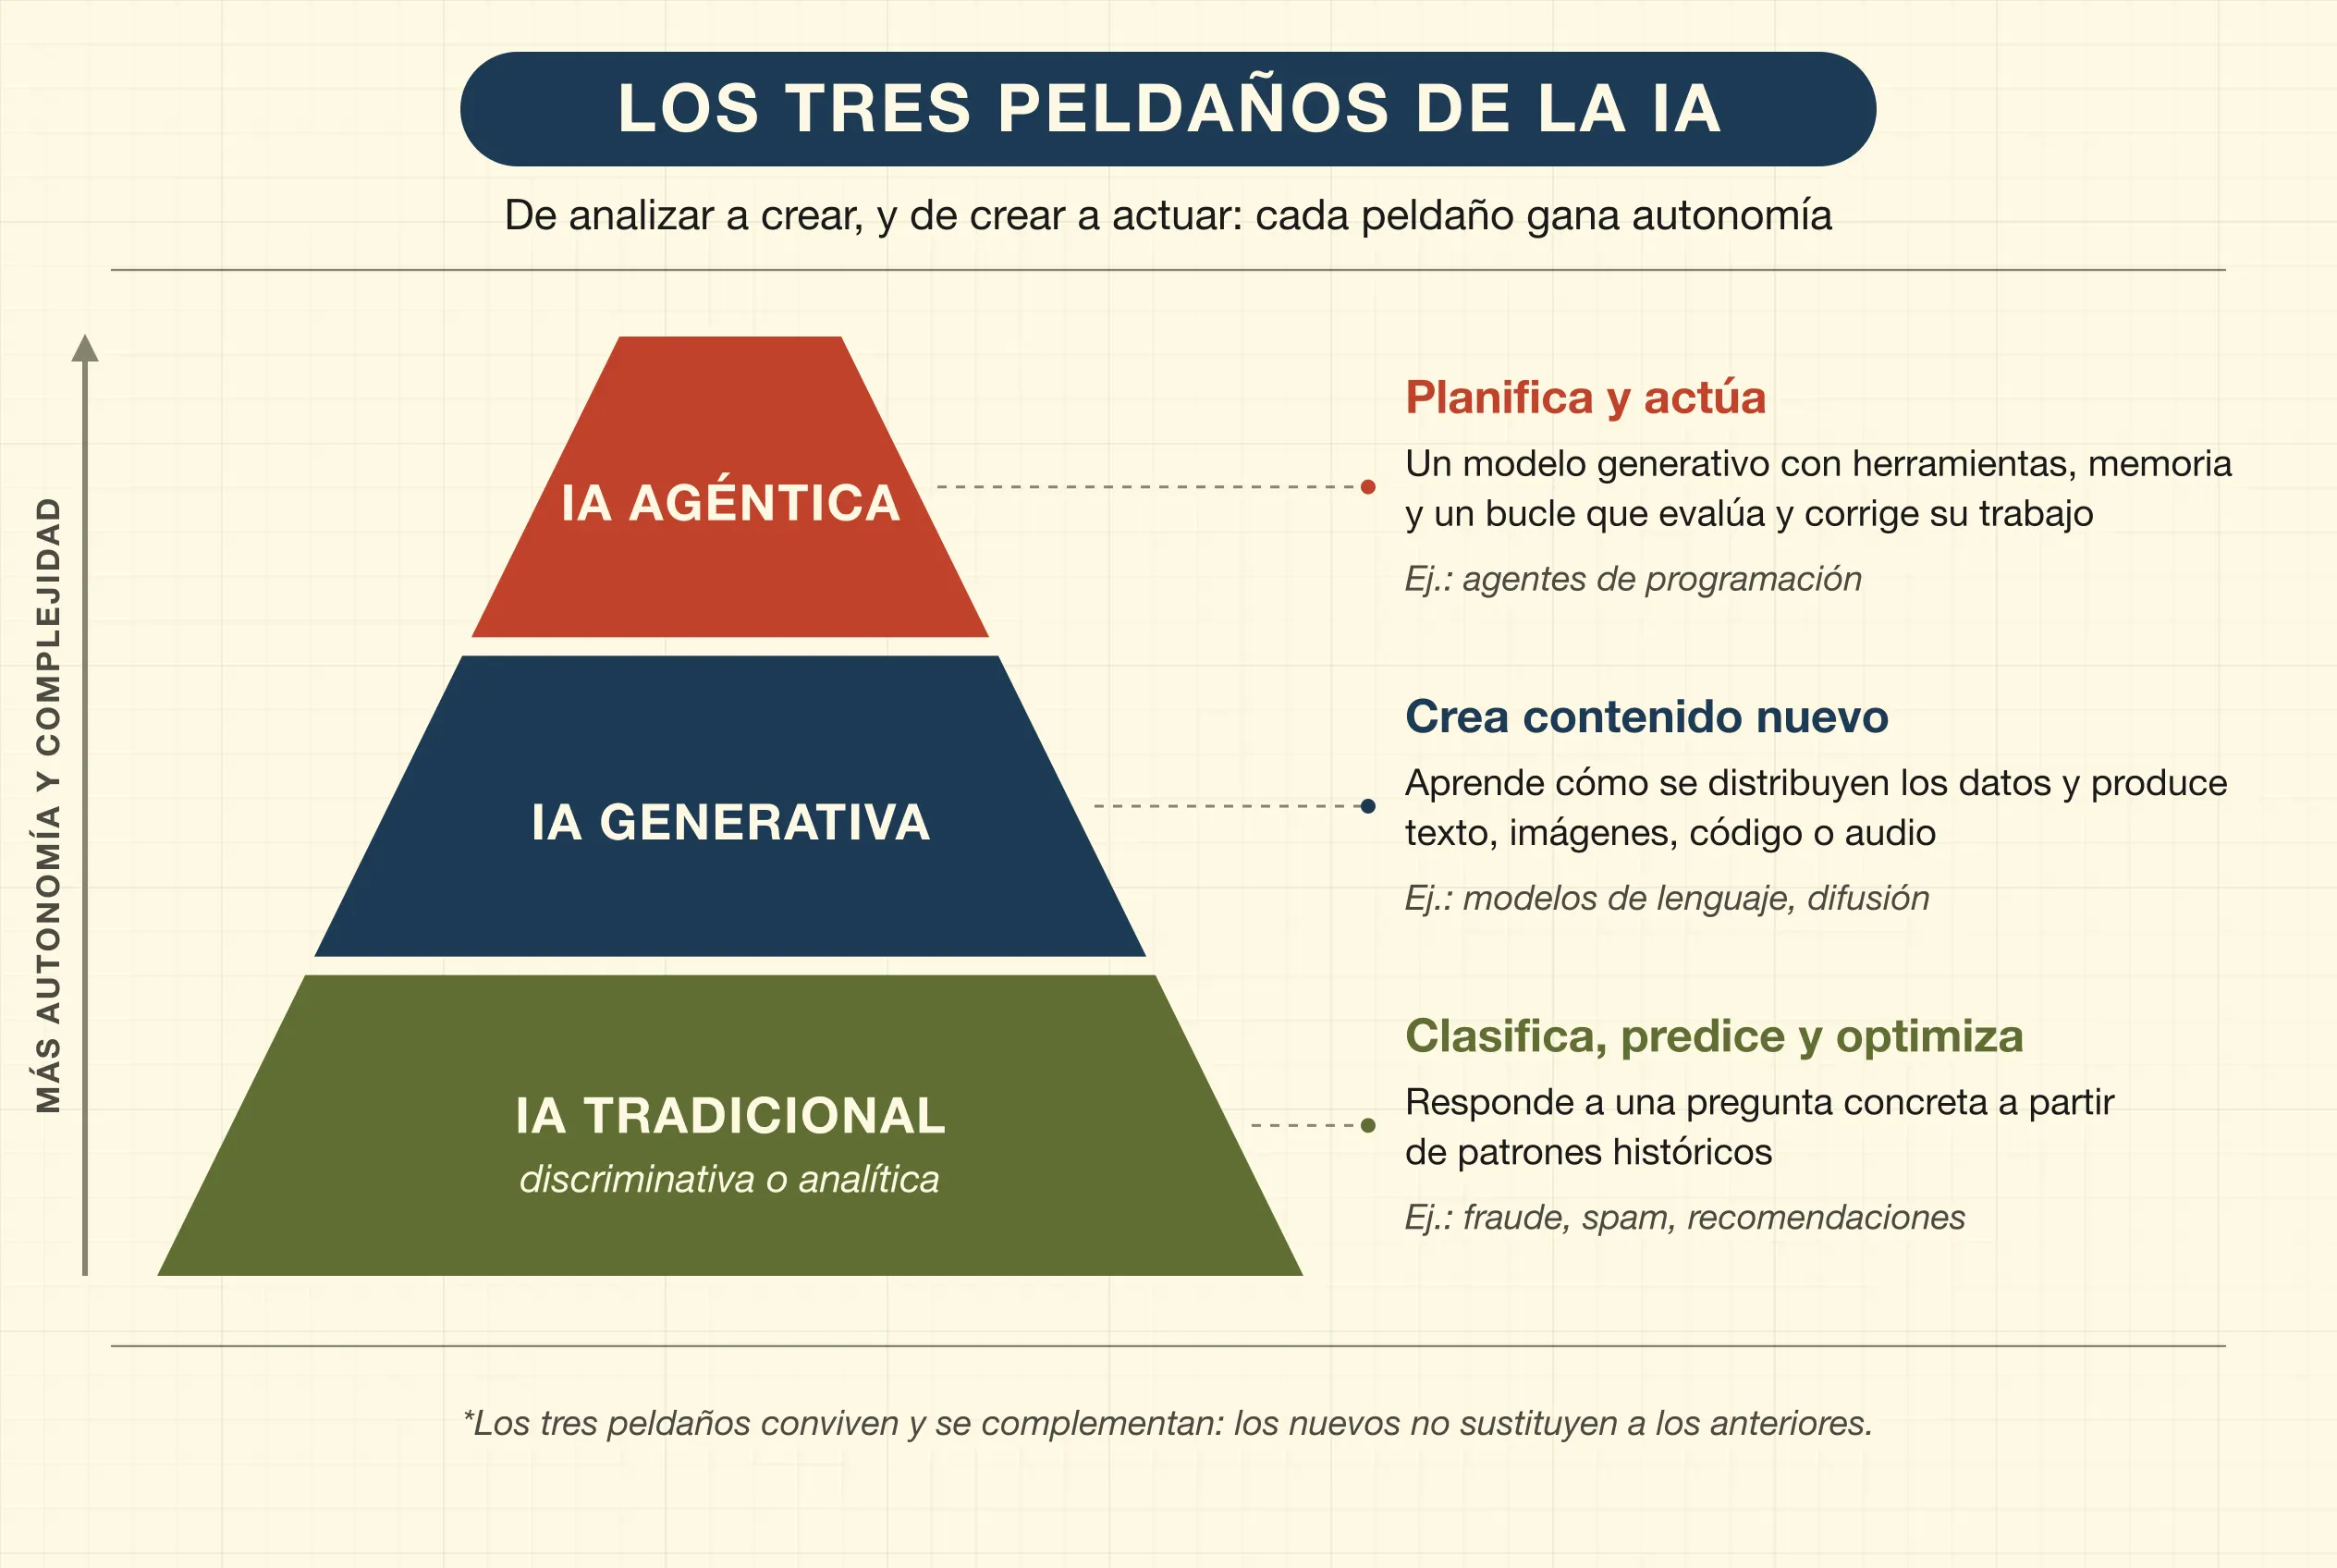
Detrás de la etiqueta hay una disciplina con más de setenta años de historia y en constante expansión. Para poner orden, podemos clasificar los sistemas actuales en tres grandes peldaños evolutivos según su grado de autonomía y su complejidad estructural. No se sustituyen entre sí: conviven y se complementan.
IA tradicional
La IA discriminativa o analítica es el cimiento histórico sobre el que se construyó la analítica de datos moderna. Estos sistemas no crean contenido original; su propósito es clasificar, predecir y optimizar a partir de patrones históricos estructurados.
- Cómo funciona: utiliza modelos estadísticos de regresión, árboles de decisión o redes neuronales clásicas para dar una respuesta determinista o probabilística a una pregunta concreta: ¿es fraudulenta esta operación?, ¿qué temperatura hará mañana?
- Ejemplos: los algoritmos que detectan transacciones fraudulentas en tu tarjeta de crédito, los sistemas de predicción meteorológica, los filtros de spam del correo electrónico o los motores de recomendación de Spotify y Netflix. Son herramientas muy eficientes, pero carecen por completo de flexibilidad fuera de su dominio específico.
- Metáfora: es como un inspector experto en una cadena de montaje que, tras ver miles de piezas, distingue de inmediato la defectuosa de la correcta según unas reglas estrictas.
IA generativa
El gran fenómeno cultural de esta década. A diferencia de la IA discriminativa, que analiza el mundo existente, la IA generativa aprende la distribución estadística subyacente de los datos para producir contenidos nuevos: texto, imágenes, código de programación o audio.
- Cómo funciona: ante una instrucción (el prompt), recurre a arquitecturas probabilísticas para construir una respuesta plausible. Un modelo de lenguaje calcula qué palabra es probable que venga a continuación, una y otra vez, hasta articular un discurso coherente; un modelo de imagen parte de ruido aleatorio y lo va depurando paso a paso hasta que emerge una imagen que encaja con la descripción.
- Ejemplos: la redacción de textos con modelos de lenguaje, la creación de imágenes mediante difusión latente o la generación de fragmentos de código.
- Metáfora: un músico de jazz virtuoso que domina todas las escalas y los géneros del pasado, capaz de improvisar una melodía nueva y coherente cada vez que se lo piden, aunque no comprenda emocionalmente el dolor o la alegría que evoca.
IA agéntica
Representa la frontera operativa del desarrollo tecnológico. Ya no se trata de que una IA responda a un estímulo puntual en una ventana de chat, sino de dotar al modelo de autonomía, memoria y capacidad de planificación.
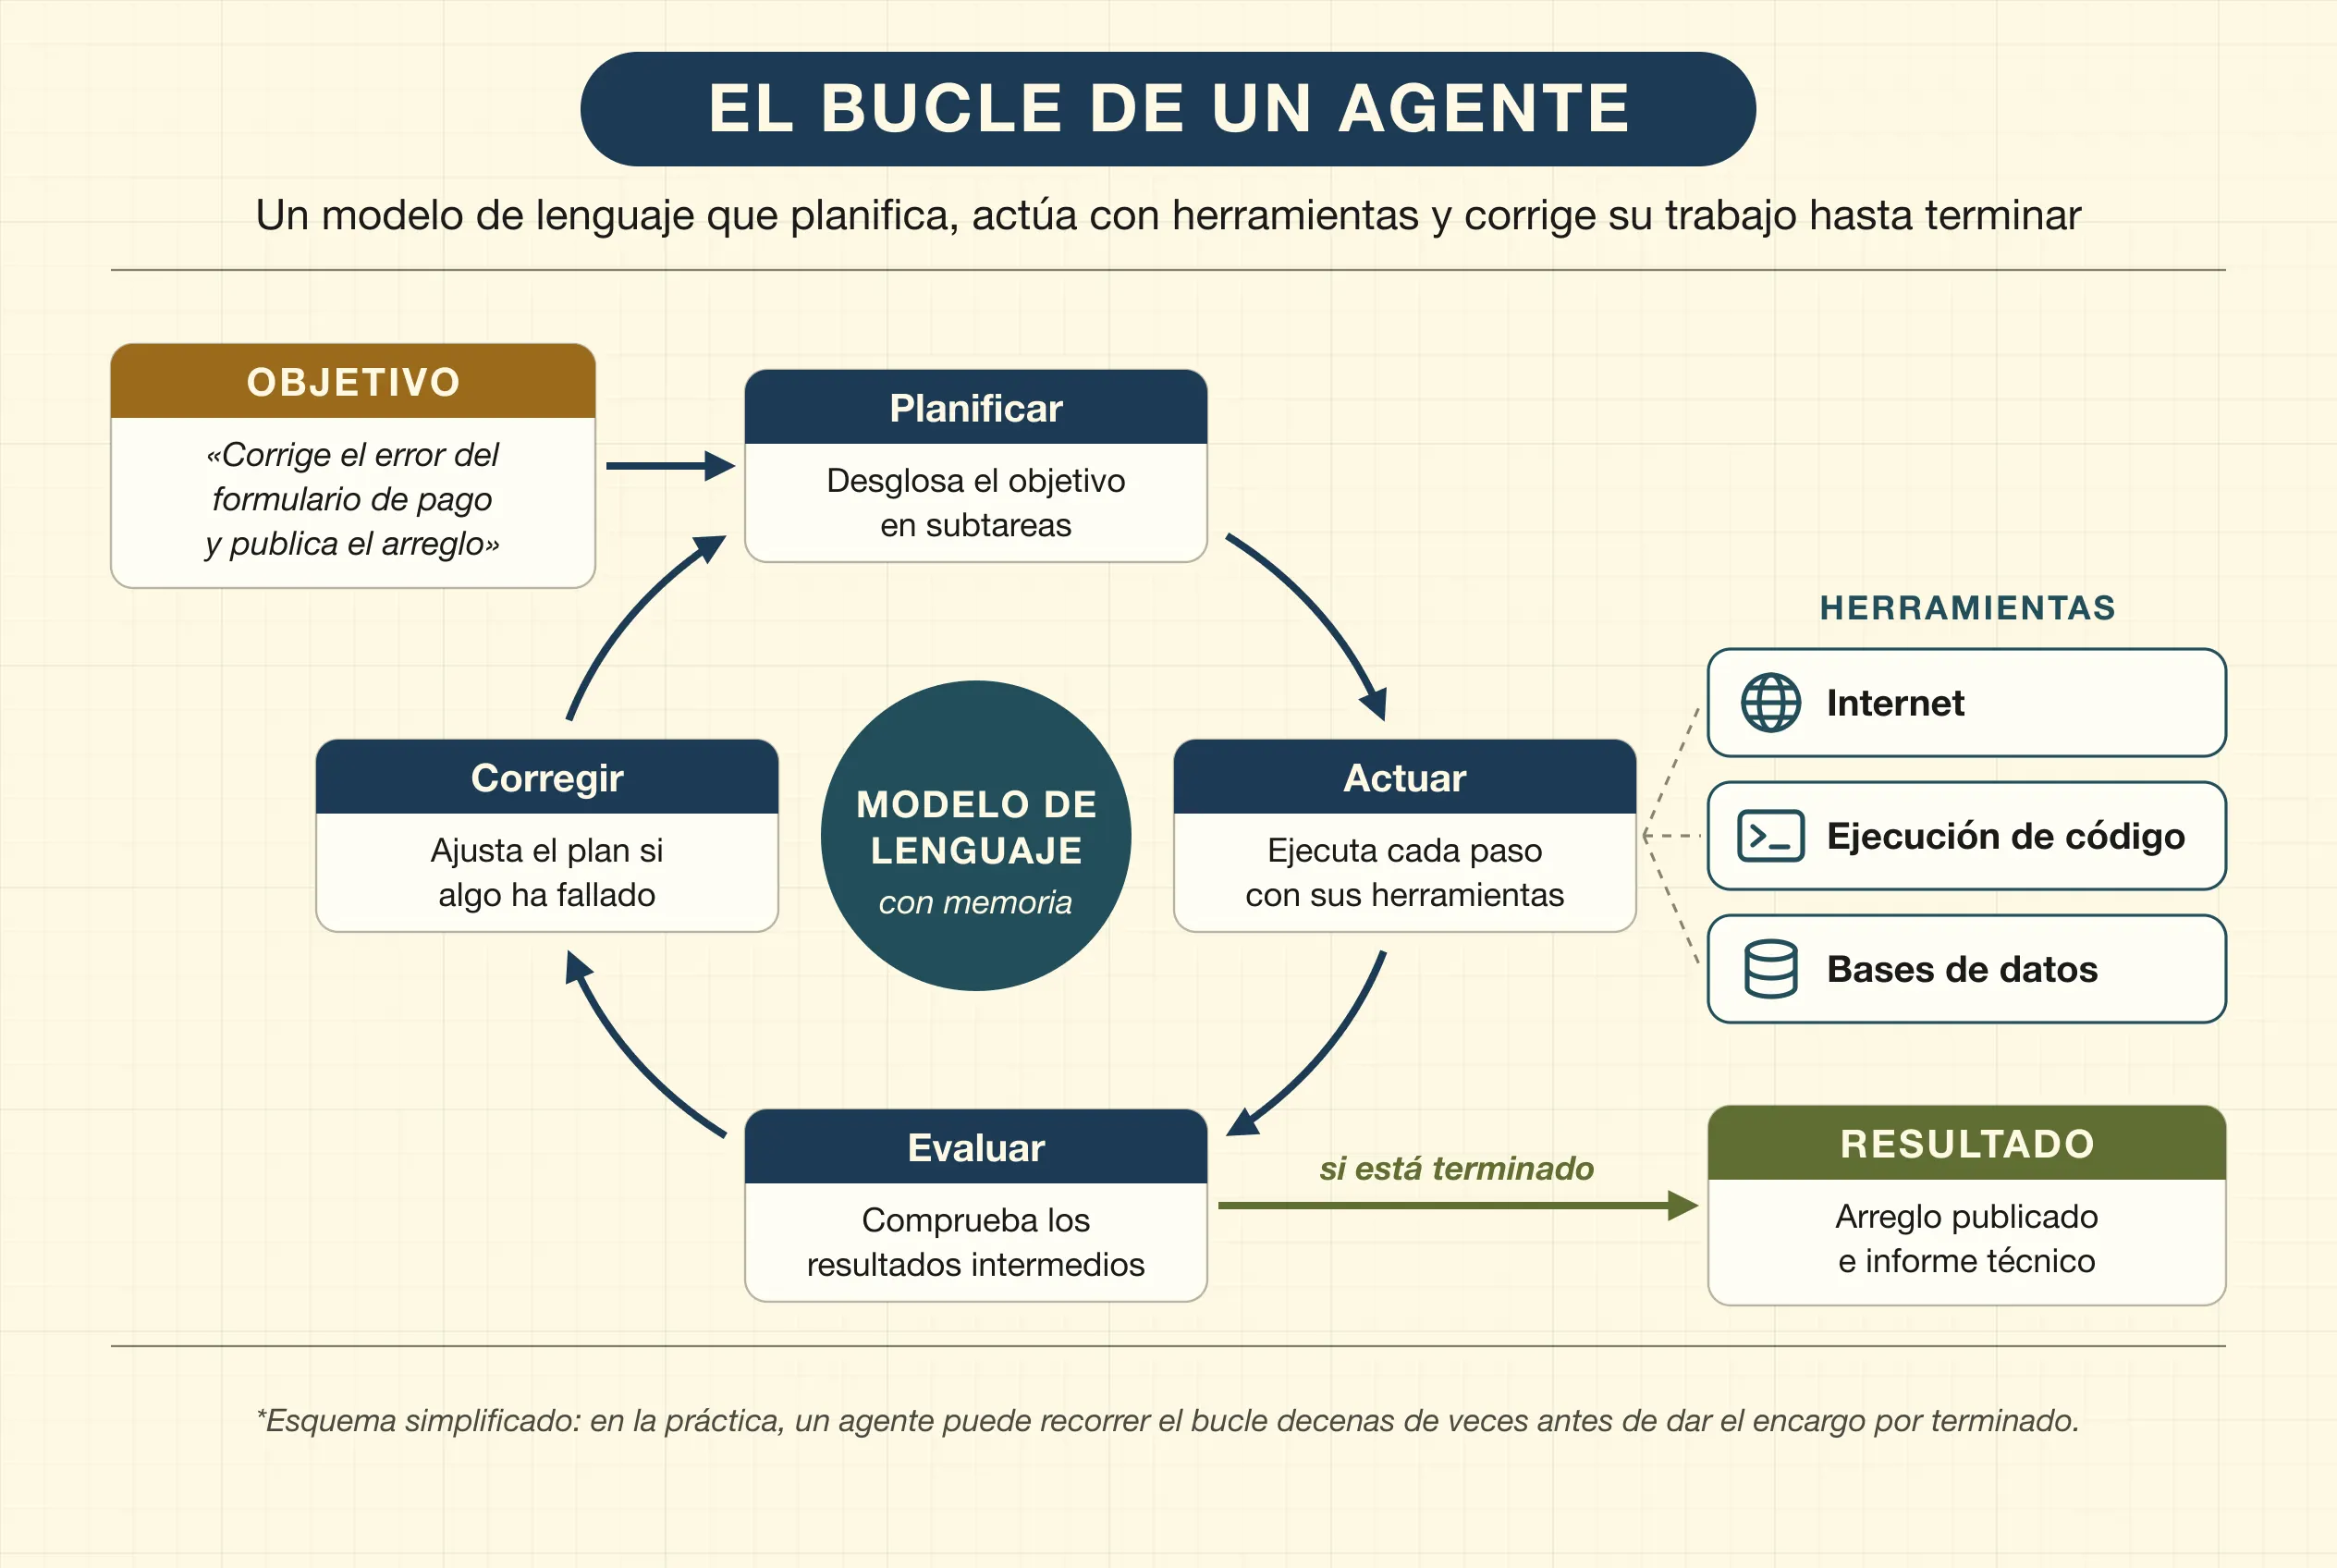
- Cómo funciona: combina un modelo de lenguaje generativo con un conjunto de herramientas externas (acceso a internet, ejecución de código, bases de datos) y un bucle de razonamiento iterativo. El agente recibe un objetivo de alto nivel, lo desglosa en subtareas, ejecuta acciones, evalúa los resultados intermedios y corrige sus propios errores hasta completar el encargo.
- Ejemplos: asistentes de programación capaces de auditar bases de código completas, corregir errores, desplegar el resultado en servidores y redactar el informe técnico sin intervención humana constante.
- Límite fundamental: la fiabilidad a largo plazo y la gestión de la incertidumbre cuando se enfrentan a escenarios del mundo real que no estaban previstos en su diseño.
Mientras que la IA discriminativa busca la precisión en el análisis y la generativa la verosimilitud en la síntesis, la IA agéntica introduce la agencia funcional: cierra el bucle entre el pensamiento computacional y la acción en el mundo real.
El mapa del poder global
Del mismo modo que la geopolítica del siglo XX estuvo marcada por el control del petróleo y de las rutas marítimas, el siglo XXI se define por la soberanía sobre el silicio avanzado, los datos y el talento algorítmico. Hoy, el ecosistema global de la IA se articula en torno a tres grandes polos con filosofías, incentivos y modelos de negocio radicalmente distintos.
El eje de Silicon Valley
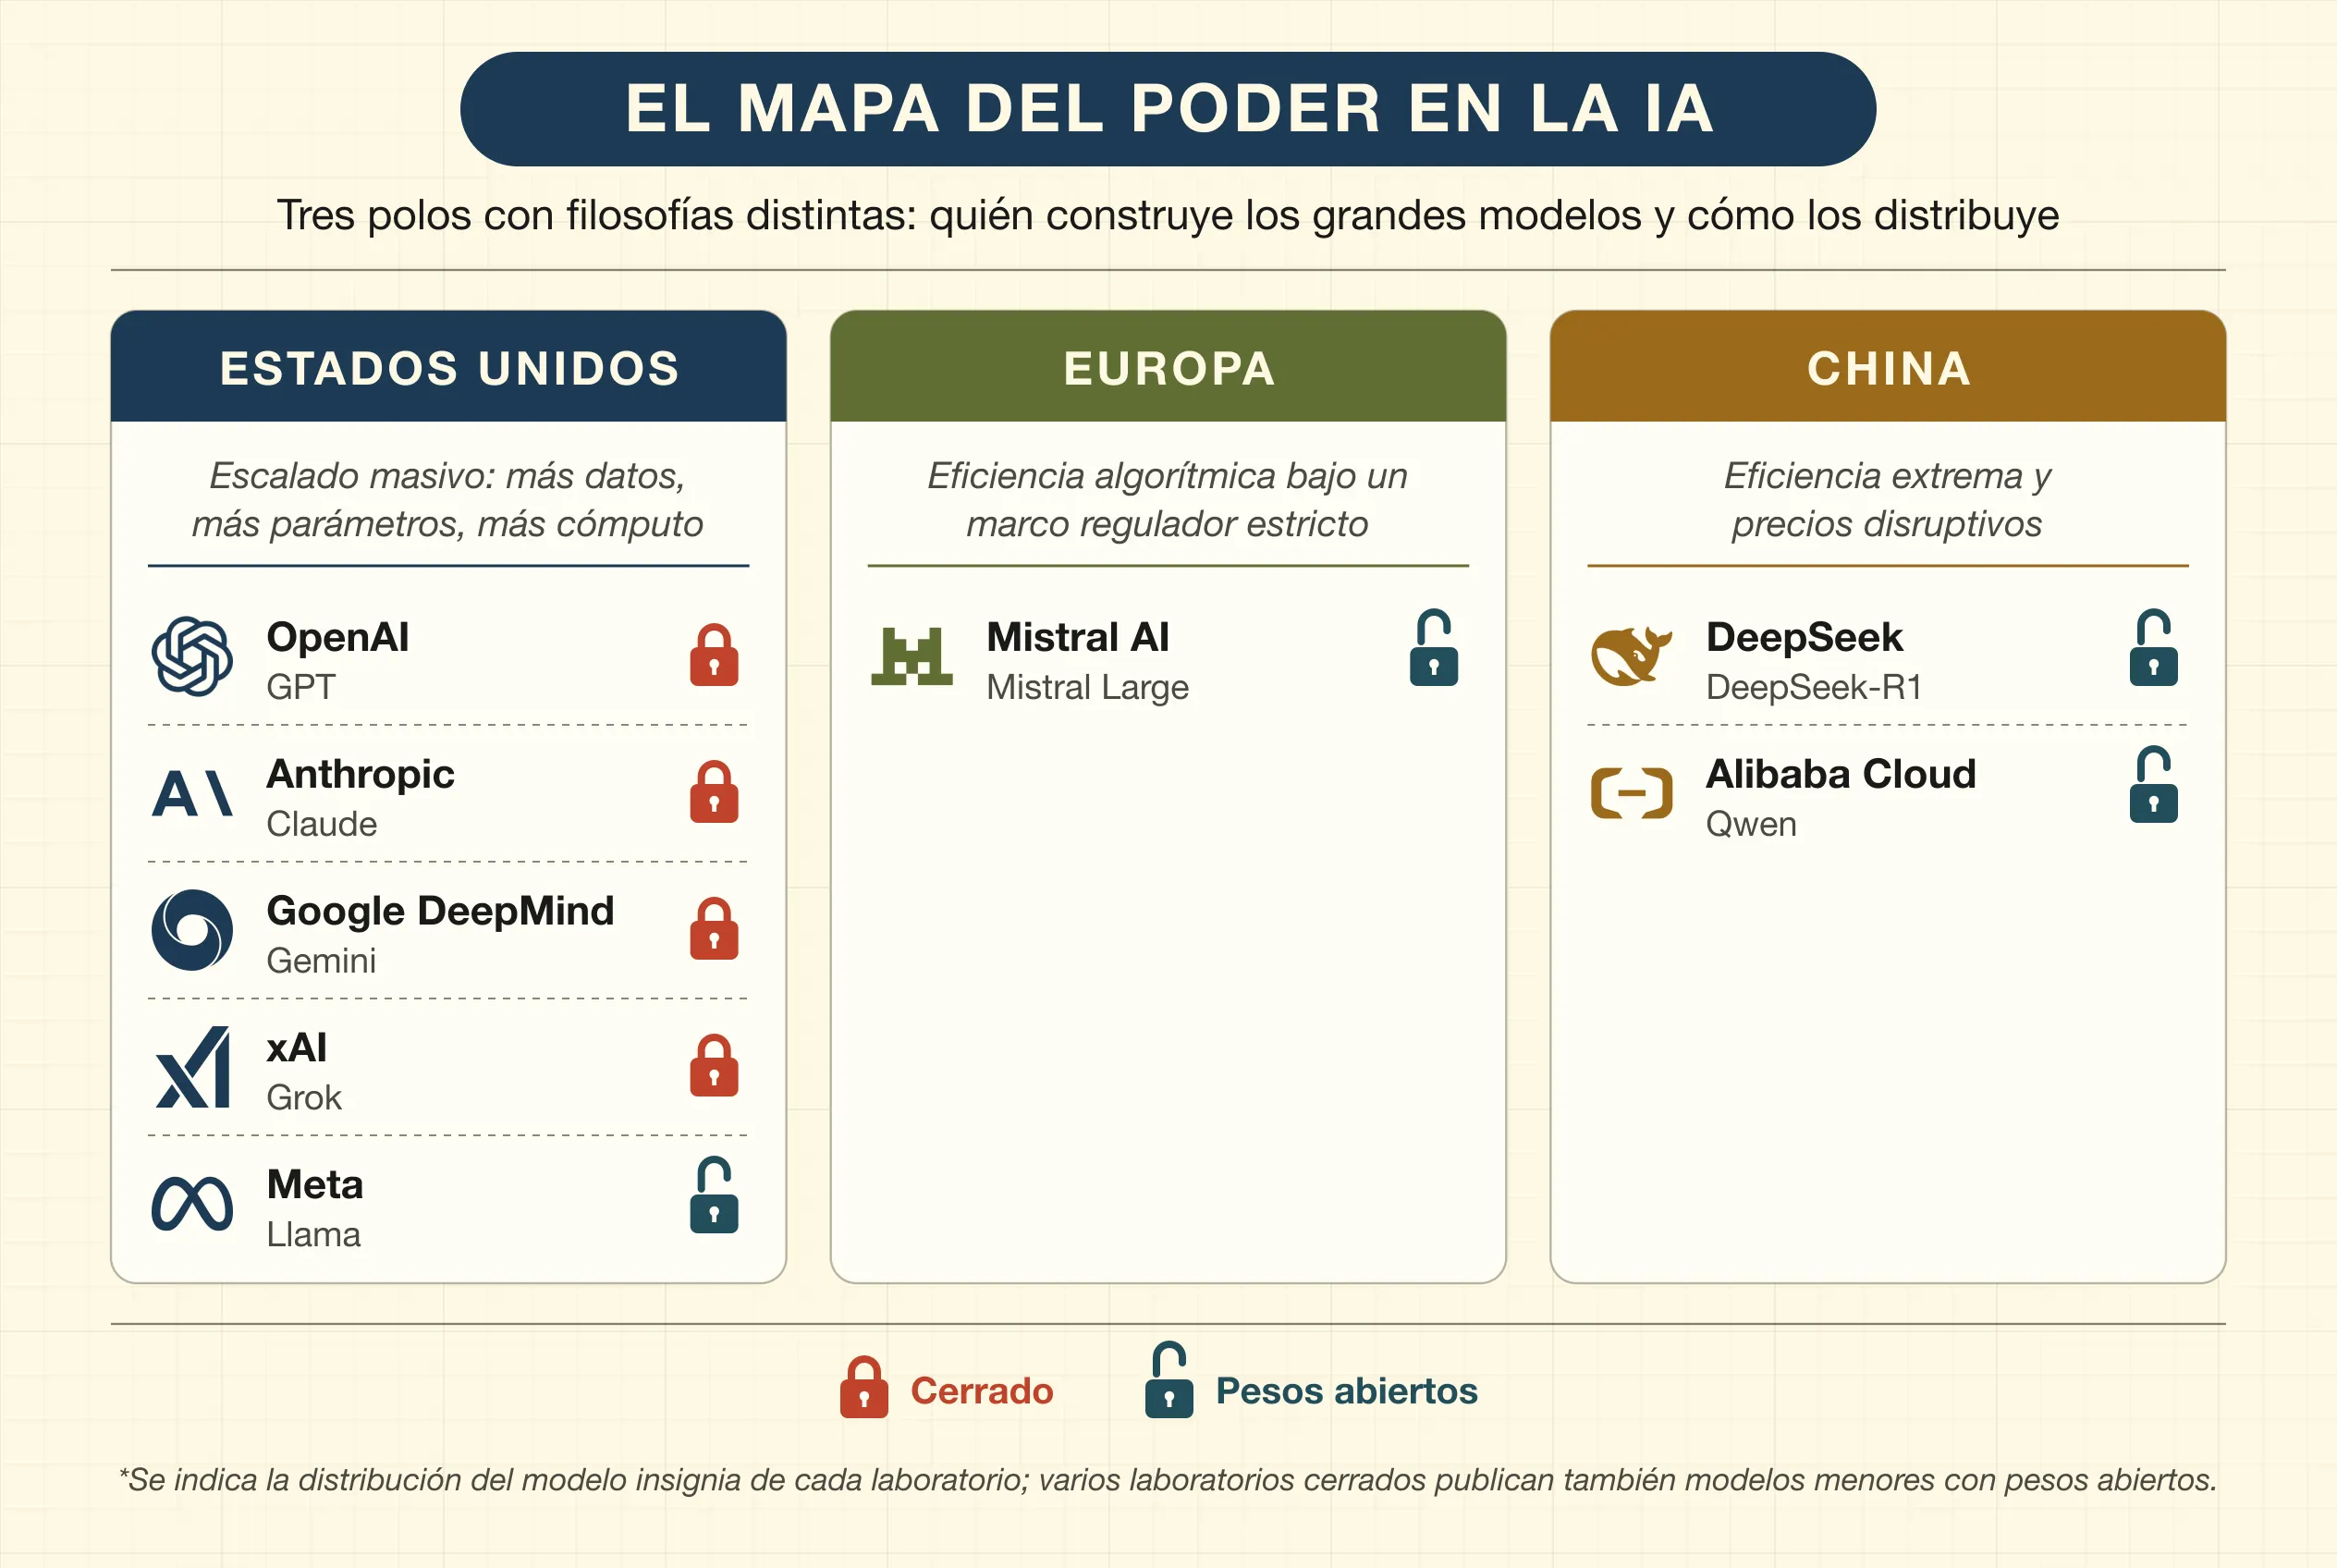
Estados Unidos sigue albergando a los gigantes comerciales que empujan los límites del rendimiento bruto, por lo general con modelos cerrados.
- Filosofía: apuesta por el escalado masivo (las llamadas leyes de escalado o scaling laws). La premisa es simple: cuantos más datos, más parámetros y más potencia de cálculo (GPU), más capaz se vuelve el modelo.
- Modelo de negocio: cercano al monopolio de plataforma. Inversiones milmillonarias procedentes del capital riesgo y de las grandes tecnológicas (Big Tech), que se rentabilizan mediante suscripciones de consumo y APIs propietarias para empresas.
Actores clave
- OpenAI: el gran catalizador comercial de la era moderna, gracias a su saga GPT y a su alianza estratégica con Microsoft.
- Anthropic: fundada por antiguos empleados de OpenAI, destaca por su familia de modelos Claude y por situar la seguridad y la alineación ética en el centro de su desarrollo.
- Google DeepMind: la potencia científica por excelencia. Responsable de hitos como AlphaFold, que predice la estructura tridimensional de las proteínas a partir de su secuencia y valió a sus creadores el Nobel de Química de 2024, vuelca su músculo investigador en el ecosistema Gemini.
- xAI: la apuesta de Elon Musk con su modelo Grok, caracterizada por su integración directa con datos en tiempo real y por unos filtros de contenido menos restrictivos.
Europa
Europa compite desde una posición atípica: con una inversión en capacidad de cómputo muy inferior a la de Estados Unidos o China, ha optado por la excelencia investigadora y la eficiencia algorítmica.
- Filosofía: maximizar el rendimiento por parámetro, priorizando modelos que puedan ejecutarse en infraestructuras locales o europeas, bajo el paraguas de un marco regulador estricto (el Reglamento de Inteligencia Artificial o AI Act).
- Modelo de negocio: ante la imposibilidad financiera de competir con los gigantes estadounidenses en la construcción de los mayores supercomputadores del mundo, el ecosistema europeo se especializa en la optimización. Desarrolla arquitecturas ligeras, flexibles y multilingües que ofrecen un rendimiento excelente con una fracción del coste computacional y energético.
Actor clave
- Mistral AI: el gran estandarte europeo. Con sede en París, ha demostrado que es posible competir en la élite mundial con modelos eficientes, muchos de ellos con pesos abiertos, que rivalizan con los estadounidenses consumiendo una fracción de sus recursos de cómputo.
Asia (principalmente China)
Asia ha reconfigurado el tablero con avances disruptivos que desafían la idea de que solo se puede progresar a base de presupuestos milmillonarios.
- Filosofía: eficiencia extrema, reinvención de los métodos de entrenamiento para reducir drásticamente el consumo de recursos y agilidad en la adopción masiva.
- Modelo de negocio: modelos abiertos o de muy bajo coste que rompen los precios de los monopolios occidentales y acercan capacidades de frontera a economías emergentes.
Actores clave
- DeepSeek: el gran disruptor. A principios de 2025 sacudió la industria con R1, un modelo de razonamiento con pesos abiertos que rendía al nivel de los mejores laboratorios occidentales con una inversión en entrenamiento drásticamente inferior.
- Alibaba Cloud: desarrolla la familia Qwen, una de las opciones de pesos abiertos más potentes, multilingües y versátiles del mundo, con capacidades de procesamiento de texto, visión artificial y programación avanzada.
Modelos cerrados frente a modelos de pesos abiertos
Dentro del ecosistema del software existe un debate técnico y filosófico tan intenso como el geopolítico: la tensión entre los modelos cerrados y los de pesos abiertos (open weights).
Esta dicotomía define el verdadero campo de batalla del presente: un pulso entre la concentración del poder cognitivo en manos de un puñado de corporaciones transnacionales y su descentralización como bien público digital.
Modelos propietarios (cerrados)
Son aquellos cuyas entrañas técnicas, código fuente y pesos neuronales permanecen bajo estricto secreto comercial. El usuario interactúa con ellos exclusivamente a través de aplicaciones o de interfaces de programación (APIs).
- Ventajas: máximo nivel de seguridad gestionado por el proveedor, soporte técnico directo, optimización extrema para el consumidor final y grandes inversiones en alineamiento ético.
- Inconvenientes: dependencia absoluta de un proveedor externo (vendor lock-in), opacidad sobre cómo se han procesado los datos de entrenamiento y vulnerabilidad ante cambios unilaterales en las condiciones de servicio o las tarifas.
Modelos de pesos abiertos
Son aquellos cuyos archivos de pesos neuronales se publican para que cualquier investigador, empresa o ciudadano pueda descargarlos, auditarlos, modificarlos y ejecutarlos en su propio hardware. El estandarte más notable de esta filosofía ha sido la familia Llama, de Meta.
- Ventajas: soberanía absoluta sobre los datos, posibilidad de personalización local (fine-tuning) sin que la información privada salga de los servidores de la organización, auditabilidad científica y resistencia a la censura corporativa o gubernamental.
- Inconvenientes: requieren conocimientos técnicos avanzados para su despliegue y mantenimiento, y sus barreras de seguridad pueden eliminarse, lo que facilita usos maliciosos si no se manejan con responsabilidad.
Conviene no confundir pesos abiertos con código abierto. Lo que se publica son los parámetros del modelo ya entrenado, pero casi nunca los datos ni el código con que se entrenó, y las licencias a menudo restringen ciertos usos. Un modelo de pesos abiertos se puede ejecutar y adaptar, pero no reconstruir desde cero. Existen también modelos totalmente abiertos, como OLMo, del Allen Institute for AI, que publican además los datos y el código de entrenamiento, pero son la excepción.
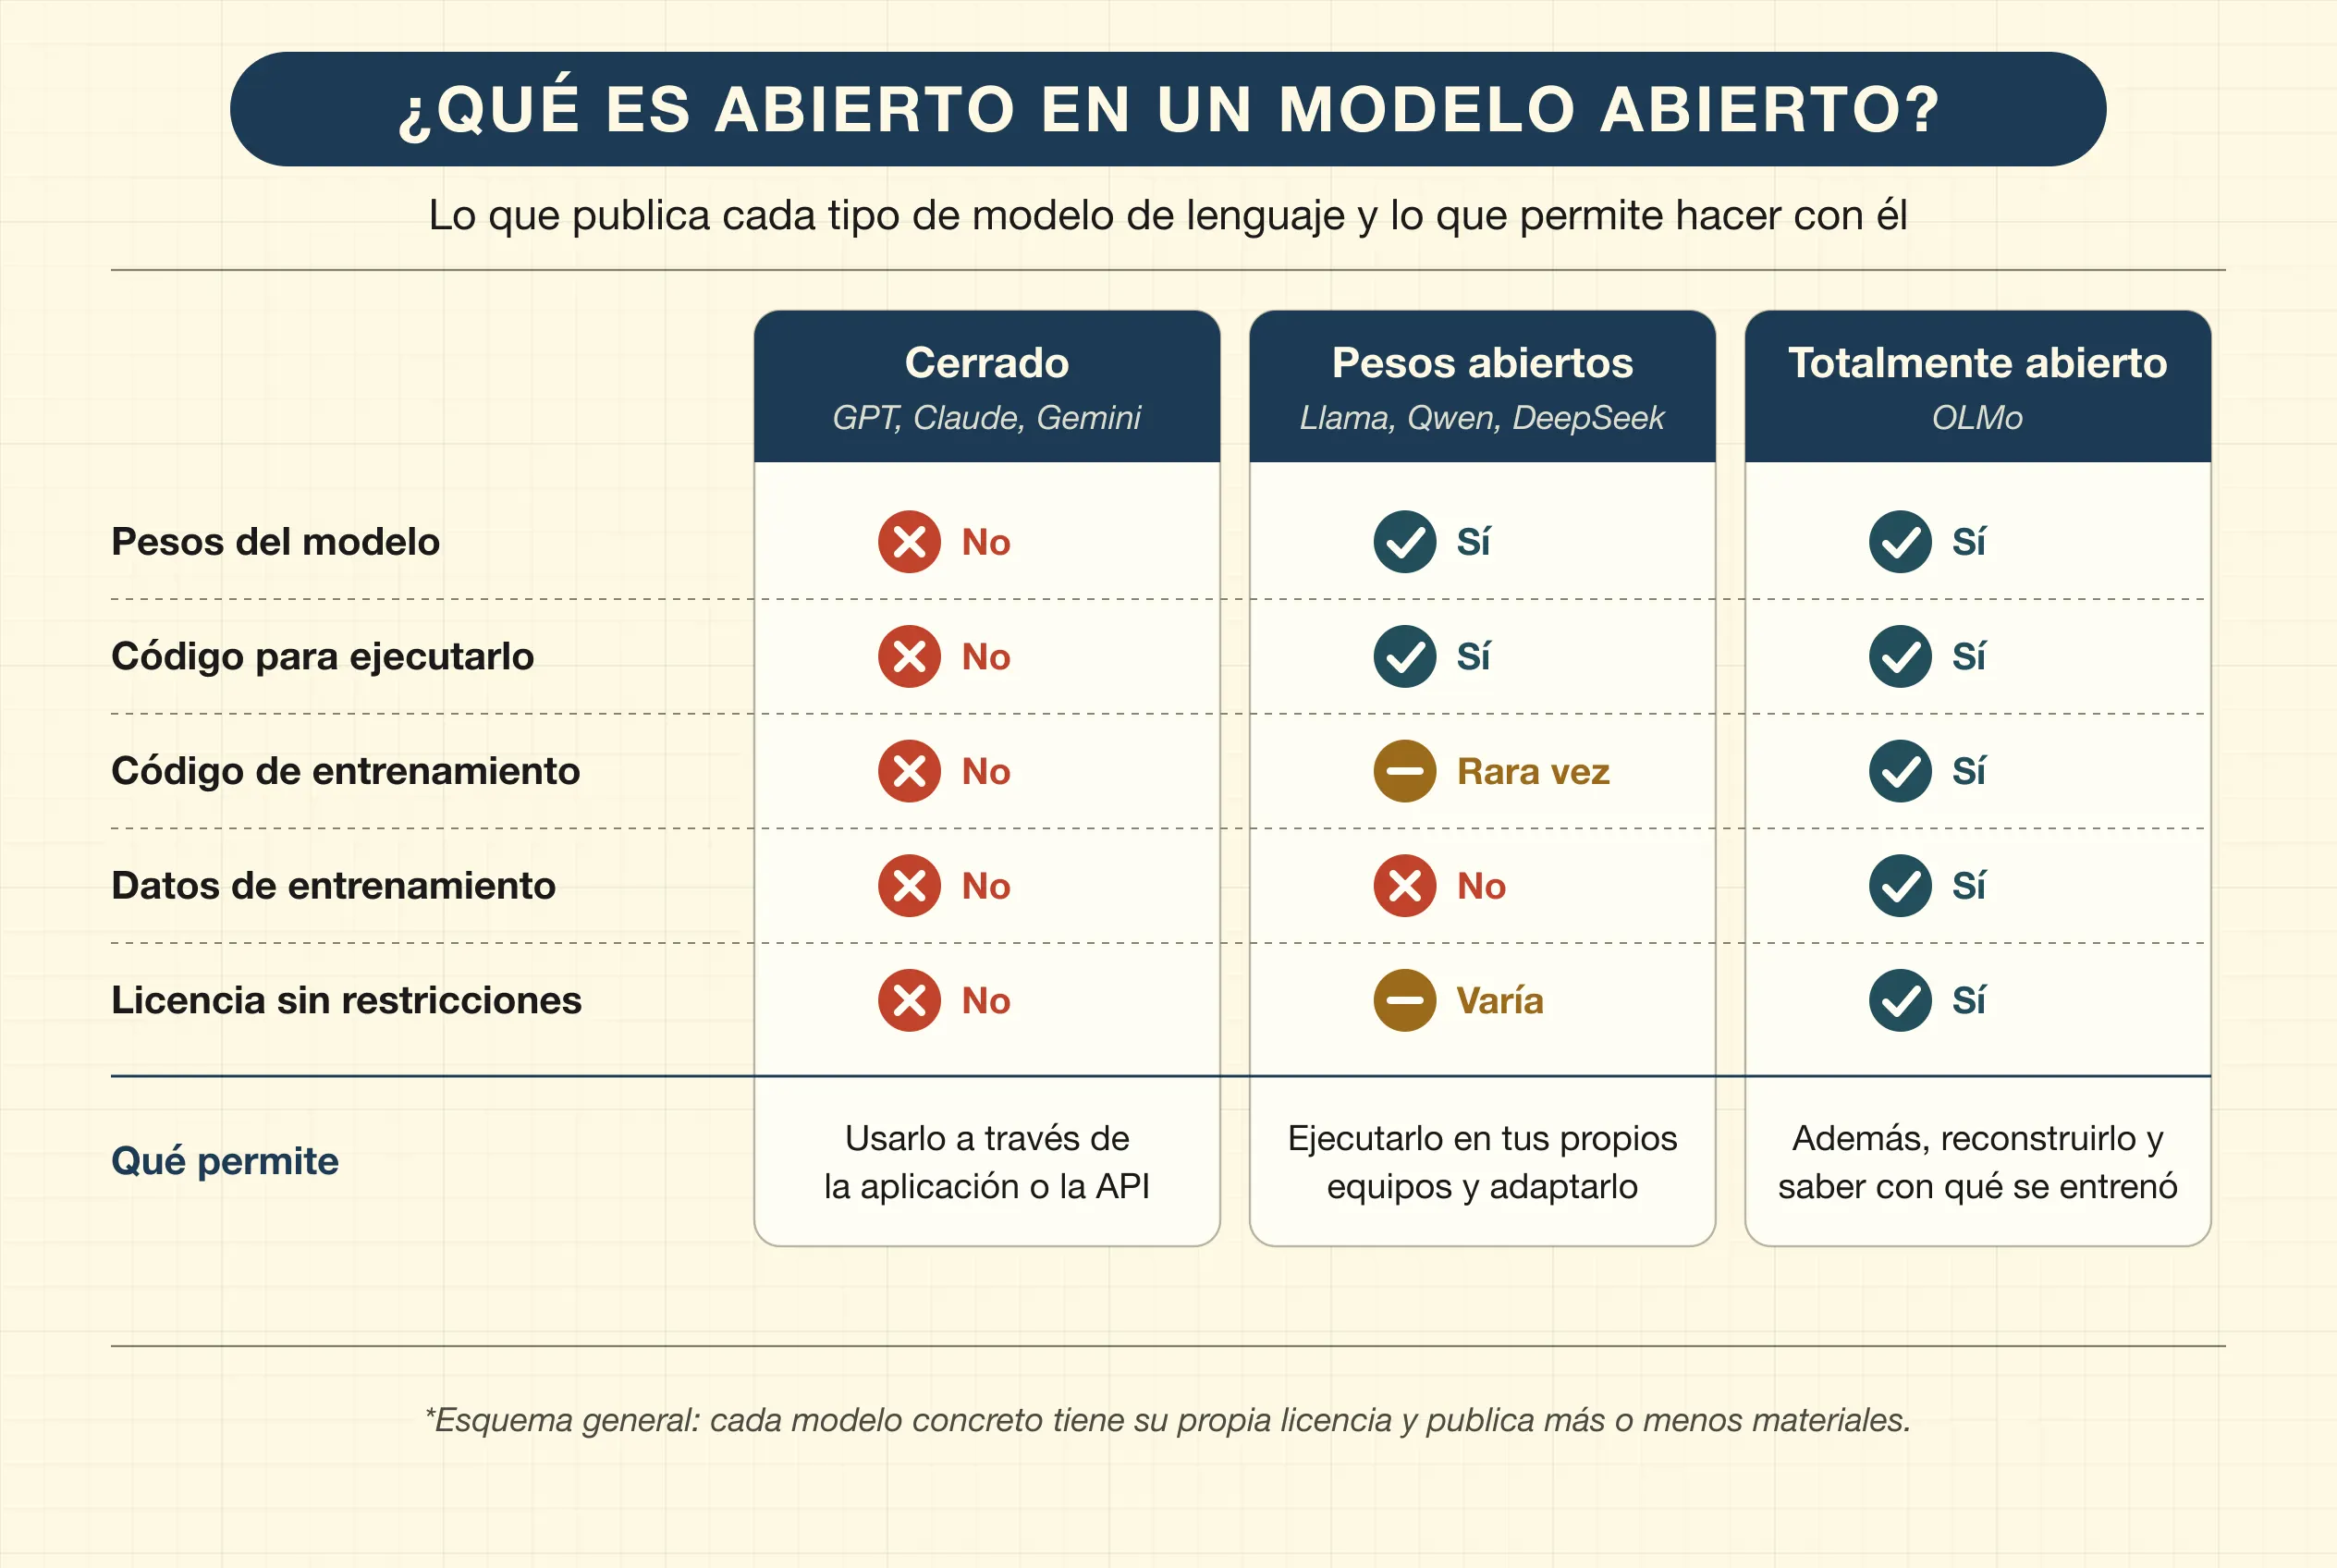
Tabla resumen
| Característica | Modelos propietarios (cerrados) | Modelos de pesos abiertos (open weights) |
|---|---|---|
| Acceso al interior | Oculto tras una aplicación o una API comercial. El usuario solo consume el servicio. | Los pesos neuronales (weights) se descargan libremente para estudiarlos o modificarlos. |
| Control y privacidad | Los datos viajan a servidores de terceros, sujetos a sus políticas de retención. | Se ejecutan en local o en servidores propios: soberanía absoluta sobre los datos. |
| Seguridad y moderación | Filtros rígidos integrados por el fabricante (alineación comercial). | Permiten personalizar e incluso retirar la alineación; el usuario asume la responsabilidad del uso ético. |
| Coste operativo | Pago por uso (tokens procesados a través de la API del proveedor). | Coste de infraestructura propia (hardware, GPU) o alquiler de servidores en la nube. |
| Ejemplos destacados | GPT-6.1 Terra (OpenAI), Claude Opus 5.5 (Anthropic), Gemini 4 Carbon (Google). | Llama 4 (Meta), Qwen (Alibaba), Mistral Large (Mistral AI). |
Una pequeña reflexión
El auge de los modelos de pesos abiertos representa un contrapeso fundamental a los monopolios, en favor de la democracia tecnológica. Si el conocimiento científico de la inteligencia artificial quedase confinado en los servidores herméticos de tres o cuatro corporaciones multinacionales, la sociedad perdería la capacidad de auditar, regular y adaptar estas herramientas a necesidades locales, científicas o sociales específicas.
Los modelos abiertos actúan como un bien público digital: permiten que universidades, hospitales, pequeñas empresas y desarrolladores independientes experimenten, auditen sesgos y construyan soluciones a medida sin depender de la venia de un único proveedor comercial.
Referencias y respaldo científico
- La distinción clásica entre los dos enfoques: un modelo discriminativo aprende a separar las clases; uno generativo, cómo se distribuyen los datos de cada una. Ng, A. Y., & Jordan, M. I. (2001). On discriminative vs. generative classifiers: A comparison of logistic regression and naive Bayes. Advances in Neural Information Processing Systems, 14, 841-848. Consultar estudio en NeurIPS
- Cómo funciona por dentro el recomendador de Netflix, contado por sus responsables, y cuánto vale para el negocio. Gomez-Uribe, C. A., & Hunt, N. (2015). The Netflix recommender system: Algorithms, business value, and innovation. ACM Transactions on Management Information Systems, 6(4), 13. Consultar artículo (DOI)
- El informe que acuñó el término «modelos fundacionales»: sistemas generales entrenados a gran escala que luego se adaptan a tareas concretas. Bommasani, R., Hudson, D. A., Adeli, E., Altman, R., Arora, S., … & Liang, P. (2021). On the opportunities and risks of foundation models. arXiv, 2108.07258. Consultar estudio en arXiv
- La difusión latente: generar una imagen eliminando ruido paso a paso, en un espacio comprimido que abarata el cálculo. Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-resolution image synthesis with latent diffusion models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 10674-10685. Consultar estudio (DOI)
- El patrón que siguen muchos agentes: alternar razonamiento y acciones con herramientas, y corregir el plan con lo que devuelven. Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2023). ReAct: Synergizing reasoning and acting in language models. International Conference on Learning Representations (ICLR). Consultar estudio en arXiv
- Una revisión de los agentes basados en modelos de lenguaje: planificación, memoria, uso de herramientas y sus límites. Wang, L., Ma, C., Feng, X., Zhang, Z., Yang, H., Zhang, J., Chen, Z., Tang, J., Chen, X., Lin, Y., Zhao, W. X., Wei, Z., & Wen, J. (2024). A survey on large language model based autonomous agents. Frontiers of Computer Science, 18(6), 186345. Consultar artículo (DOI)
- Las leyes de escalado: el rendimiento de un modelo de lenguaje mejora de forma predecible al aumentar parámetros, datos y cómputo. Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., … & Amodei, D. (2020). Scaling laws for neural language models. arXiv, 2001.08361. Consultar estudio en arXiv
- El matiz a esas leyes: para un mismo presupuesto de cómputo, conviene entrenar modelos más pequeños con muchos más datos. Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., … & Sifre, L. (2022). Training compute-optimal large language models. Advances in Neural Information Processing Systems, 35, 30016-30030. Consultar estudio en arXiv
- AlphaFold: la predicción de la estructura de las proteínas con una precisión cercana a la experimental. Jumper, J., Evans, R., Pritzel, A., Green, T., Figurnov, M., … & Hassabis, D. (2021). Highly accurate protein structure prediction with AlphaFold. Nature, 596(7873), 583-589. Consultar artículo (DOI)
- Los datos del reparto global: cuántos modelos destacados salen de Estados Unidos, de China y de Europa, y cómo se estrecha la distancia entre ellos. Maslej, N., Fattorini, L., Perrault, R., Gil, Y., Parli, V., … & Oak, S. (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence. Consultar informe en arXiv
- El Reglamento europeo de inteligencia artificial, que clasifica los sistemas según su riesgo y fija obligaciones para los modelos de uso general. Parlamento Europeo y Consejo de la Unión Europea. (2024). Reglamento (UE) 2024/1689, por el que se establecen normas armonizadas en materia de inteligencia artificial. Diario Oficial de la Unión Europea, L 2024/1689. Consultar el texto en EUR-Lex
- El primer modelo de Mistral: con 7.000 millones de parámetros, superaba a modelos abiertos de casi el doble de tamaño. Jiang, A. Q., Sablayrolles, A., Mensch, A., Bamford, C., Chaplot, D. S., … & El Sayed, W. (2023). Mistral 7B. arXiv, 2310.06825. Consultar estudio en arXiv
- Cómo entrenó DeepSeek un modelo de frontera con una fracción del cómputo habitual. DeepSeek-AI. (2024). DeepSeek-V3 technical report. arXiv, 2412.19437. Consultar informe en arXiv
- DeepSeek-R1: la capacidad de razonar paso a paso, obtenida con aprendizaje por refuerzo y publicada con pesos abiertos. Guo, D., Yang, D., Zhang, H., Song, J., Wang, P., Zhu, Q., … & Zhang, Z. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645(8081), 633-638. Consultar artículo (DOI)
- La familia Qwen3 de Alibaba: modelos de pesos abiertos, de pequeños a muy grandes, en más de un centenar de idiomas. Yang, A., Li, A., Yang, B., Zhang, B., Hui, B., … & Qiu, Z. (2025). Qwen3 technical report. arXiv, 2505.09388. Consultar informe en arXiv
- El primer Llama: modelos competitivos entrenados solo con datos públicos y puestos a disposición de la comunidad investigadora. Touvron, H., Lavril, T., Izacard, G., Martinet, X., Lachaux, M.-A., … & Lample, G. (2023). LLaMA: Open and efficient foundation language models. arXiv, 2302.13971. Consultar estudio en arXiv
- Qué publica realmente cada modelo «abierto»: la mayoría comparte los pesos, pero no los datos ni el código de entrenamiento. Liesenfeld, A., & Dingemanse, M. (2024). Rethinking open source generative AI: Open washing and the EU AI Act. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency, 1774-1787. Consultar estudio (DOI)
- OLMo: un modelo totalmente abierto, publicado con sus datos, su código de entrenamiento y sus registros para que cualquiera pueda estudiarlo y reproducirlo. Groeneveld, D., Beltagy, I., Walsh, E., Bhagia, A., Kinney, R., Tafjord, O., … & Hajishirzi, H. (2024). OLMo: Accelerating the science of language models. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics, 15789-15809. Consultar estudio (DOI)
- Por qué la apertura no basta para descentralizar la IA mientras el cómputo, los datos y el talento sigan concentrados en pocas empresas. Widder, D. G., Whittaker, M., & West, S. M. (2024). Why ‘open’ AI systems are actually closed, and why this matters. Nature, 635(8040), 827-833. Consultar artículo (DOI)
- Beneficios y riesgos de los modelos abiertos, medidos frente a lo que ya permiten los cerrados y otras tecnologías. Kapoor, S., Bommasani, R., Klyman, K., Longpre, S., Ramaswami, A., … & Narayanan, A. (2024). On the societal impact of open foundation models. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 23082-23104. Consultar estudio en PMLR
Estamos preparando el espacio para que puedas comentar los artículos.
Sigue leyendo
El corazón en la piel
Cómo la radiación ultravioleta libera el óxido nítrico de la piel para regular la presión arterial y combatir el riesgo cardiovascular
Efecto Zeigarnik o el coste de tener ideas brillantes
El fenómeno psicológico que sabotea tu descanso en nombre de la creatividad
Agua estructurada: el terreno de la salud
La batería líquida de tus células y cómo protegerla del entorno moderno