Origen y cimientos de la IA
De la enigmática prueba de Turing a las redes neuronales artificiales: cómo el ser humano lleva décadas intentando replicar su propia mente en silicio
Desde los autómatas mecánicos del siglo XVIII hasta los centros de datos actuales, que devoran gigavatios de energía, la humanidad ha albergado un anhelo constante: crear un reflejo artificial de su propia inteligencia. Esta ambición, que durante siglos habitó los dominios de la mitología y la ciencia ficción, encontró su primera formalización matemática y filosófica a mediados del siglo XX de la mano de Alan Turing.
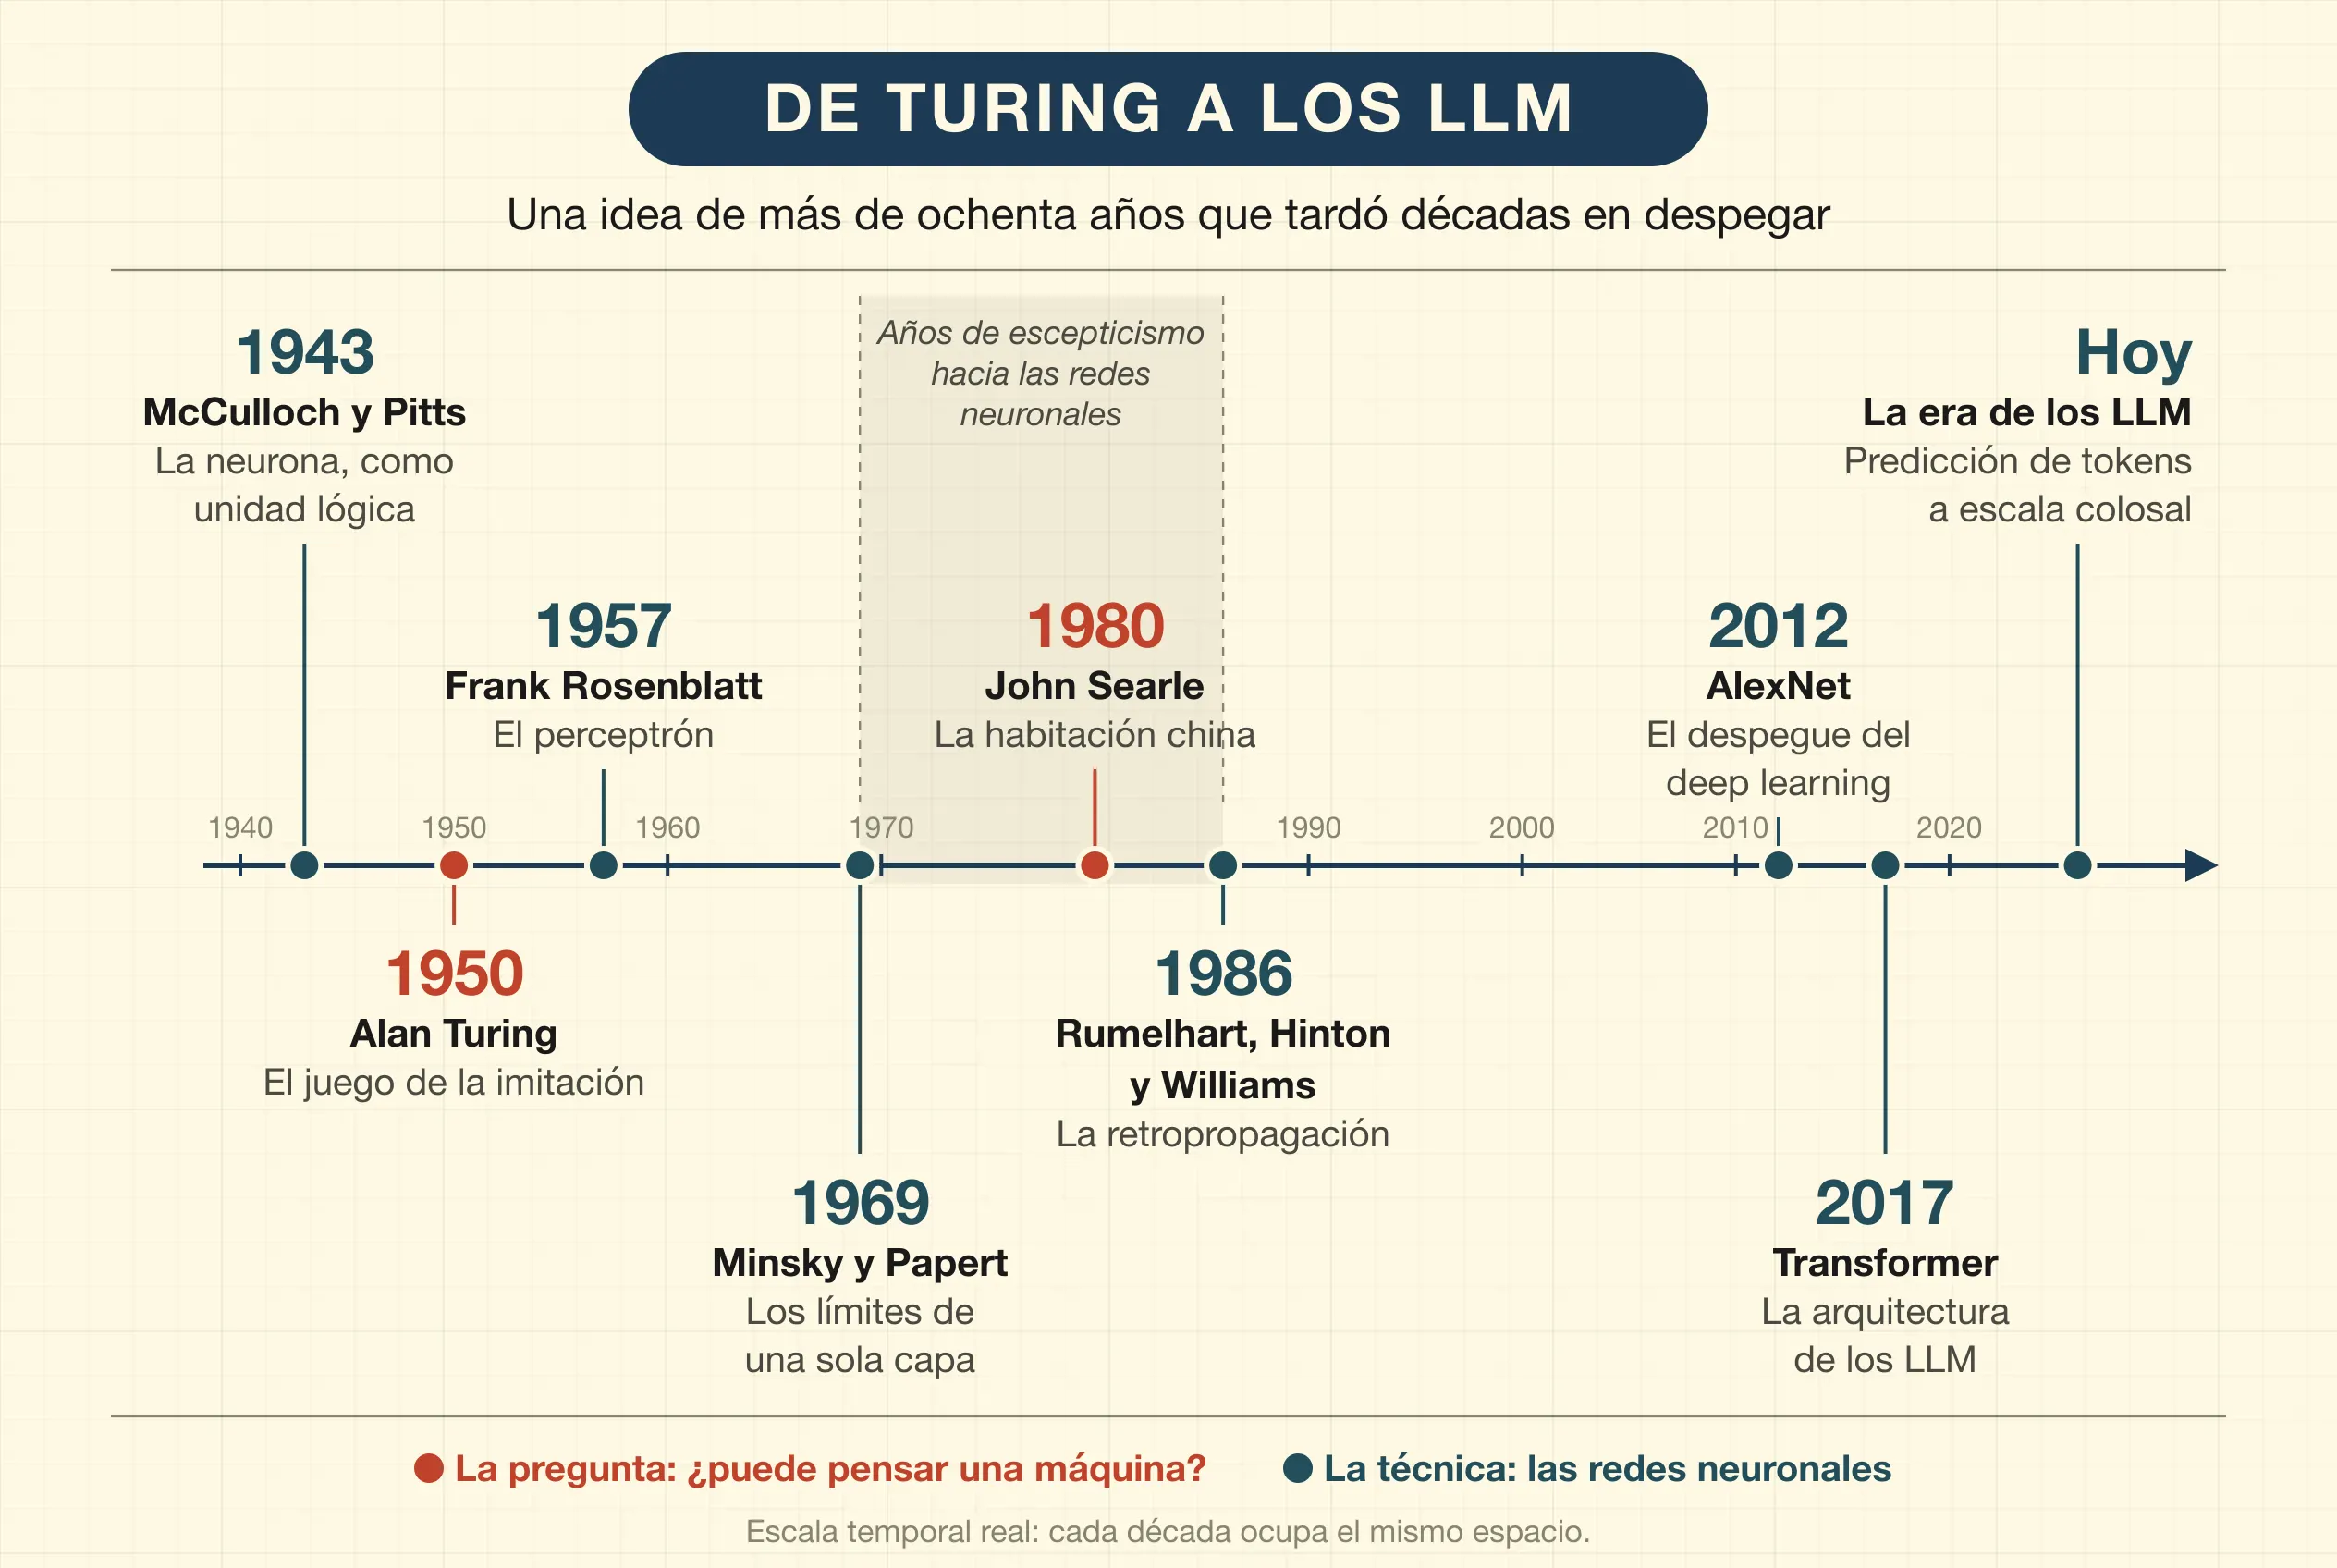
En 1950, Turing propuso un experimento mental que cambiaría para siempre el debate filosófico y científico: el juego de la imitación, conocido hoy universalmente como la prueba de Turing. Su propuesta eludía la espinosa pregunta metafísica —¿puede pensar una máquina?— para centrarse en un criterio observable: ¿puede un evaluador humano distinguir si conversa con una persona o con una máquina a través de un canal de texto? Si las respuestas del sistema resultan indistinguibles de las humanas, la máquina habrá superado la prueba.
Tres décadas más tarde, en 1980, el filósofo John Searle respondió con un célebre contraejemplo: la habitación china. Imaginemos a una persona encerrada en una habitación que no sabe una palabra de chino, pero que dispone de un gigantesco manual de reglas en español que le indica cómo manipular los símbolos chinos que recibe por debajo de la puerta («si recibes el símbolo X, responde con el símbolo Y»). Para alguien situado fuera, las respuestas son perfectas y el sistema parece entender el chino con fluidez. Sin embargo, dentro de la habitación nadie comprende el significado de los caracteres.
Este experimento mental anticipó el gran dilema que arrastramos hasta hoy: la diferencia abismal entre la simulación sintáctica —manipular símbolos con eficacia— y la comprensión semántica.
Del cerebro humano a la neurona artificial
Frente al camino de las reglas rígidas, que acabaría estancándose, los pioneros de la cibernética decidieron mirar al modelo de computación más eficiente que existe: el cerebro humano. Un órgano que, con apenas 20 vatios de potencia —menos que una bombilla convencional—, es capaz de procesar emociones, resolver ecuaciones y componer sinfonías. Ya en 1943, el neurofisiólogo Warren McCulloch y el lógico Walter Pitts habían descrito la neurona como una pequeña unidad lógica que, según las señales que recibe, se activa o permanece en reposo. Fue la semilla de todo lo que vino después.
Anatomía de la neurona biológica
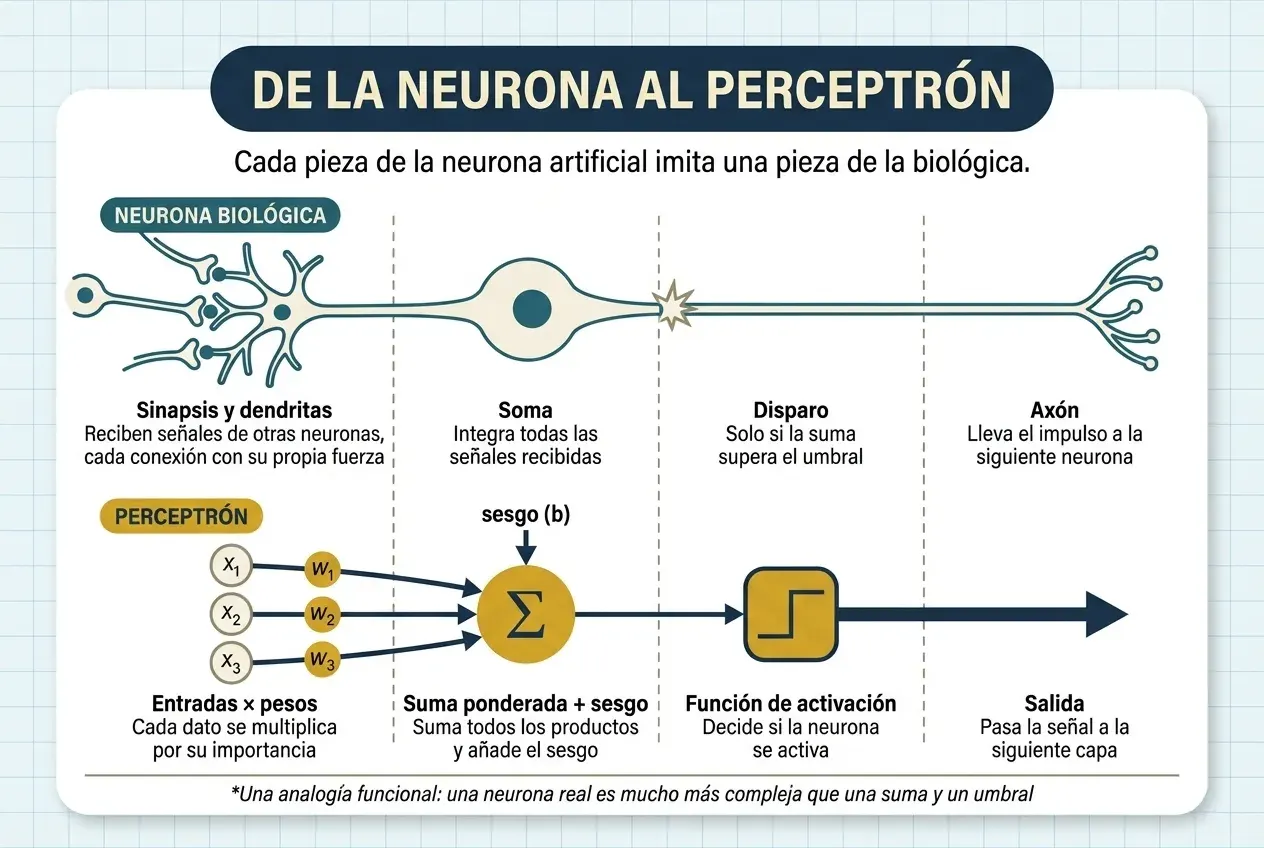
El sistema nervioso está formado por miles de millones de células interconectadas llamadas neuronas: solo el cerebro humano alberga unos 86.000 millones. Su arquitectura básica se divide en cuatro elementos funcionales:
- Dendritas: estructuras ramificadas que actúan como antenas receptoras de los impulsos eléctricos y químicos procedentes de otras neuronas.
- Soma o cuerpo celular: el centro de procesamiento, que integra todas las señales recibidas. Si su suma supera un determinado umbral eléctrico, la neurona se «dispara».
- Axón: una prolongación larga por la que el impulso eléctrico generado en el soma viaja hacia otras células.
- Sinapsis: el punto de conexión bioquímica entre el axón de una neurona y las dendritas de otra. Su plasticidad —la capacidad de fortalecerse o debilitarse con el uso— es, como intuyó el psicólogo Donald Hebb en 1949, el soporte físico del aprendizaje y la memoria.
El perceptrón: la neurona artificial
En 1957, el psicólogo Frank Rosenblatt tradujo esta arquitectura biológica al lenguaje de las matemáticas al inventar el perceptrón, el antepasado directo de las redes neuronales actuales.
Matemáticamente, una neurona artificial es una función que recibe varias entradas numéricas (x₁, x₂, …, xₙ). Cada una se multiplica por un peso (w₁, w₂, …, wₙ), el equivalente matemático de la fuerza sináptica: un número que indica cuánto influye esa entrada concreta en la decisión final.
A estos valores ponderados se les suma un término corrector llamado sesgo (bias), que desplaza la función para que a la neurona le cueste más o menos dispararse. El resultado pasa por una función de activación —un filtro matemático, como una función escalón o una sigmoide— que determina el valor de salida de la neurona.
La analogía con la neurona humana es directa:
- Entradas: equivalen a las señales que llegan por las dendritas.
- Pesos: representan la fuerza de la sinapsis biológica. Multiplican cada entrada para indicar su importancia: unos datos pesan más que otros en la decisión.
- Suma ponderada: como el soma, acumula los productos de cada entrada por su peso y añade el sesgo, que actúa como la tendencia natural de la neurona a dispararse o a callar.
- Función de activación: el disparador final. Si el resultado supera un umbral, la neurona artificial «se activa» y transmite la señal a la siguiente capa; si no, permanece inerte.
El proceso de entrenamiento
Una sola neurona artificial apenas sirve para resolver problemas triviales. Pero cuando apilamos millones —o miles de millones— de ellas en capas interconectadas, obtenemos una red neuronal artificial.
¿Cómo aprende esta red? Al principio, los pesos (w) se inicializan con números aleatorios, de modo que los resultados son absurdos. Durante el entrenamiento, el sistema compara su predicción con la respuesta correcta mediante una función de pérdida (loss function), que mide cuánto se ha equivocado. Un algoritmo fundamental, la retropropagación (backpropagation), reparte ese error desde la última capa hacia atrás, y un optimizador —como el descenso de gradiente— ajusta milimétricamente cada peso en la dirección que lo reduce. Repetido este ciclo millones de veces sobre cantidades masivas de datos, la red aprende a reconocer patrones complejos de forma autónoma.
Machine learning frente a deep learning
Durante décadas, las redes neuronales fueron una promesa frustrada por la escasez de potencia de cálculo y por sus limitaciones matemáticas: en 1969, Marvin Minsky y Seymour Papert demostraron que un perceptrón de una sola capa no puede resolver siquiera un problema tan sencillo como el «o exclusivo» (responder «sí» cuando se cumple una de dos condiciones, pero no las dos), y el interés por estas redes se desplomó durante años. Mientras tanto, la informática tradicional funcionaba mediante programación explícita: había que escribir reglas rígidas («si ocurre A, entonces haz B»). Las máquinas eran excelentes en cadenas lógicas de montaje, pero ciegas ante tareas ambiguas como reconocer un rostro en una fotografía.
La revolución llegó con el machine learning (aprendizaje automático) y, más tarde, con su evolución profunda, el deep learning (aprendizaje profundo), impulsado por tres factores: el abaratamiento de los procesadores gráficos (GPU), internet como océano de datos y arquitecturas de redes neuronales con múltiples capas ocultas. Su momento simbólico llegó en 2012, cuando AlexNet, una red profunda entrenada con GPU, arrasó en el concurso de reconocimiento de imágenes ImageNet.
En el deep learning desaparece la ingeniería manual de características. Si alimentas una red profunda con millones de imágenes de vehículos sin explicarle qué es una rueda o un manillar, sus primeras capas aprenderán a detectar patrones elementales (líneas, bordes, contrastes); las intermedias combinarán esas líneas para reconocer formas geométricas (círculos, ángulos), y las finales ensamblarán el puzle para determinar si el objeto es un coche, una bicicleta o un camión. La máquina extrae sus propias representaciones abstractas del mundo a partir de los datos en bruto.
| Característica | Machine learning tradicional | Deep learning (redes profundas) |
|---|---|---|
| Intervención humana | Requiere ingeniería de características manual (feature engineering): un experto debe decidir de antemano qué rasgos o medidas buscar (por ejemplo, bordes o texturas). | Las características se aprenden de forma autónoma a partir de los datos en bruto, a través de sucesivas capas ocultas. |
| Volumen de datos | Funciona bien con conjuntos de datos pequeños o moderados. | Exige volúmenes masivos de datos para evitar el sobreajuste (overfitting) y generalizar correctamente. |
| Capacidad de abstracción | Limitada a los rasgos que le proporciona el experto y a relaciones relativamente sencillas entre ellos. | Construye jerarquías de conceptos complejos: las capas inferiores detectan líneas; las intermedias, formas; las superiores, rostros u objetos completos. |
La gran diferencia entre ambas corrientes radica en la profundidad: mientras que el machine learning tradicional opera con una o dos capas de transformación matemática, el deep learning encadena decenas o cientos de capas ocultas, lo que le permite modelar realidades fuertemente no lineales, como la voz humana, la estructura de las proteínas o el lenguaje natural.
¿Qué es realmente un LLM?
Cuando llegamos a los modelos de lenguaje de gran escala (large language models o LLM), como los que sustentan la actual revolución de la IA generativa, el principio matemático sigue siendo el mismo —redes neuronales profundas ajustadas mediante retropropagación—, pero aplicado al tejido de la comunicación humana: el texto.
La soltura con la que los LLM actuales redactan ensayos, programan o mantienen conversaciones ha popularizado la falsa impresión de que las máquinas razonan como personas, pero nada más lejos de la realidad. Para comprender su funcionamiento real hay que despojar al lenguaje de su mística y observar sus engranajes matemáticos. El motor de un LLM descansa sobre dos pilares: el token y la predicción estocástica.
¿Qué es un token?
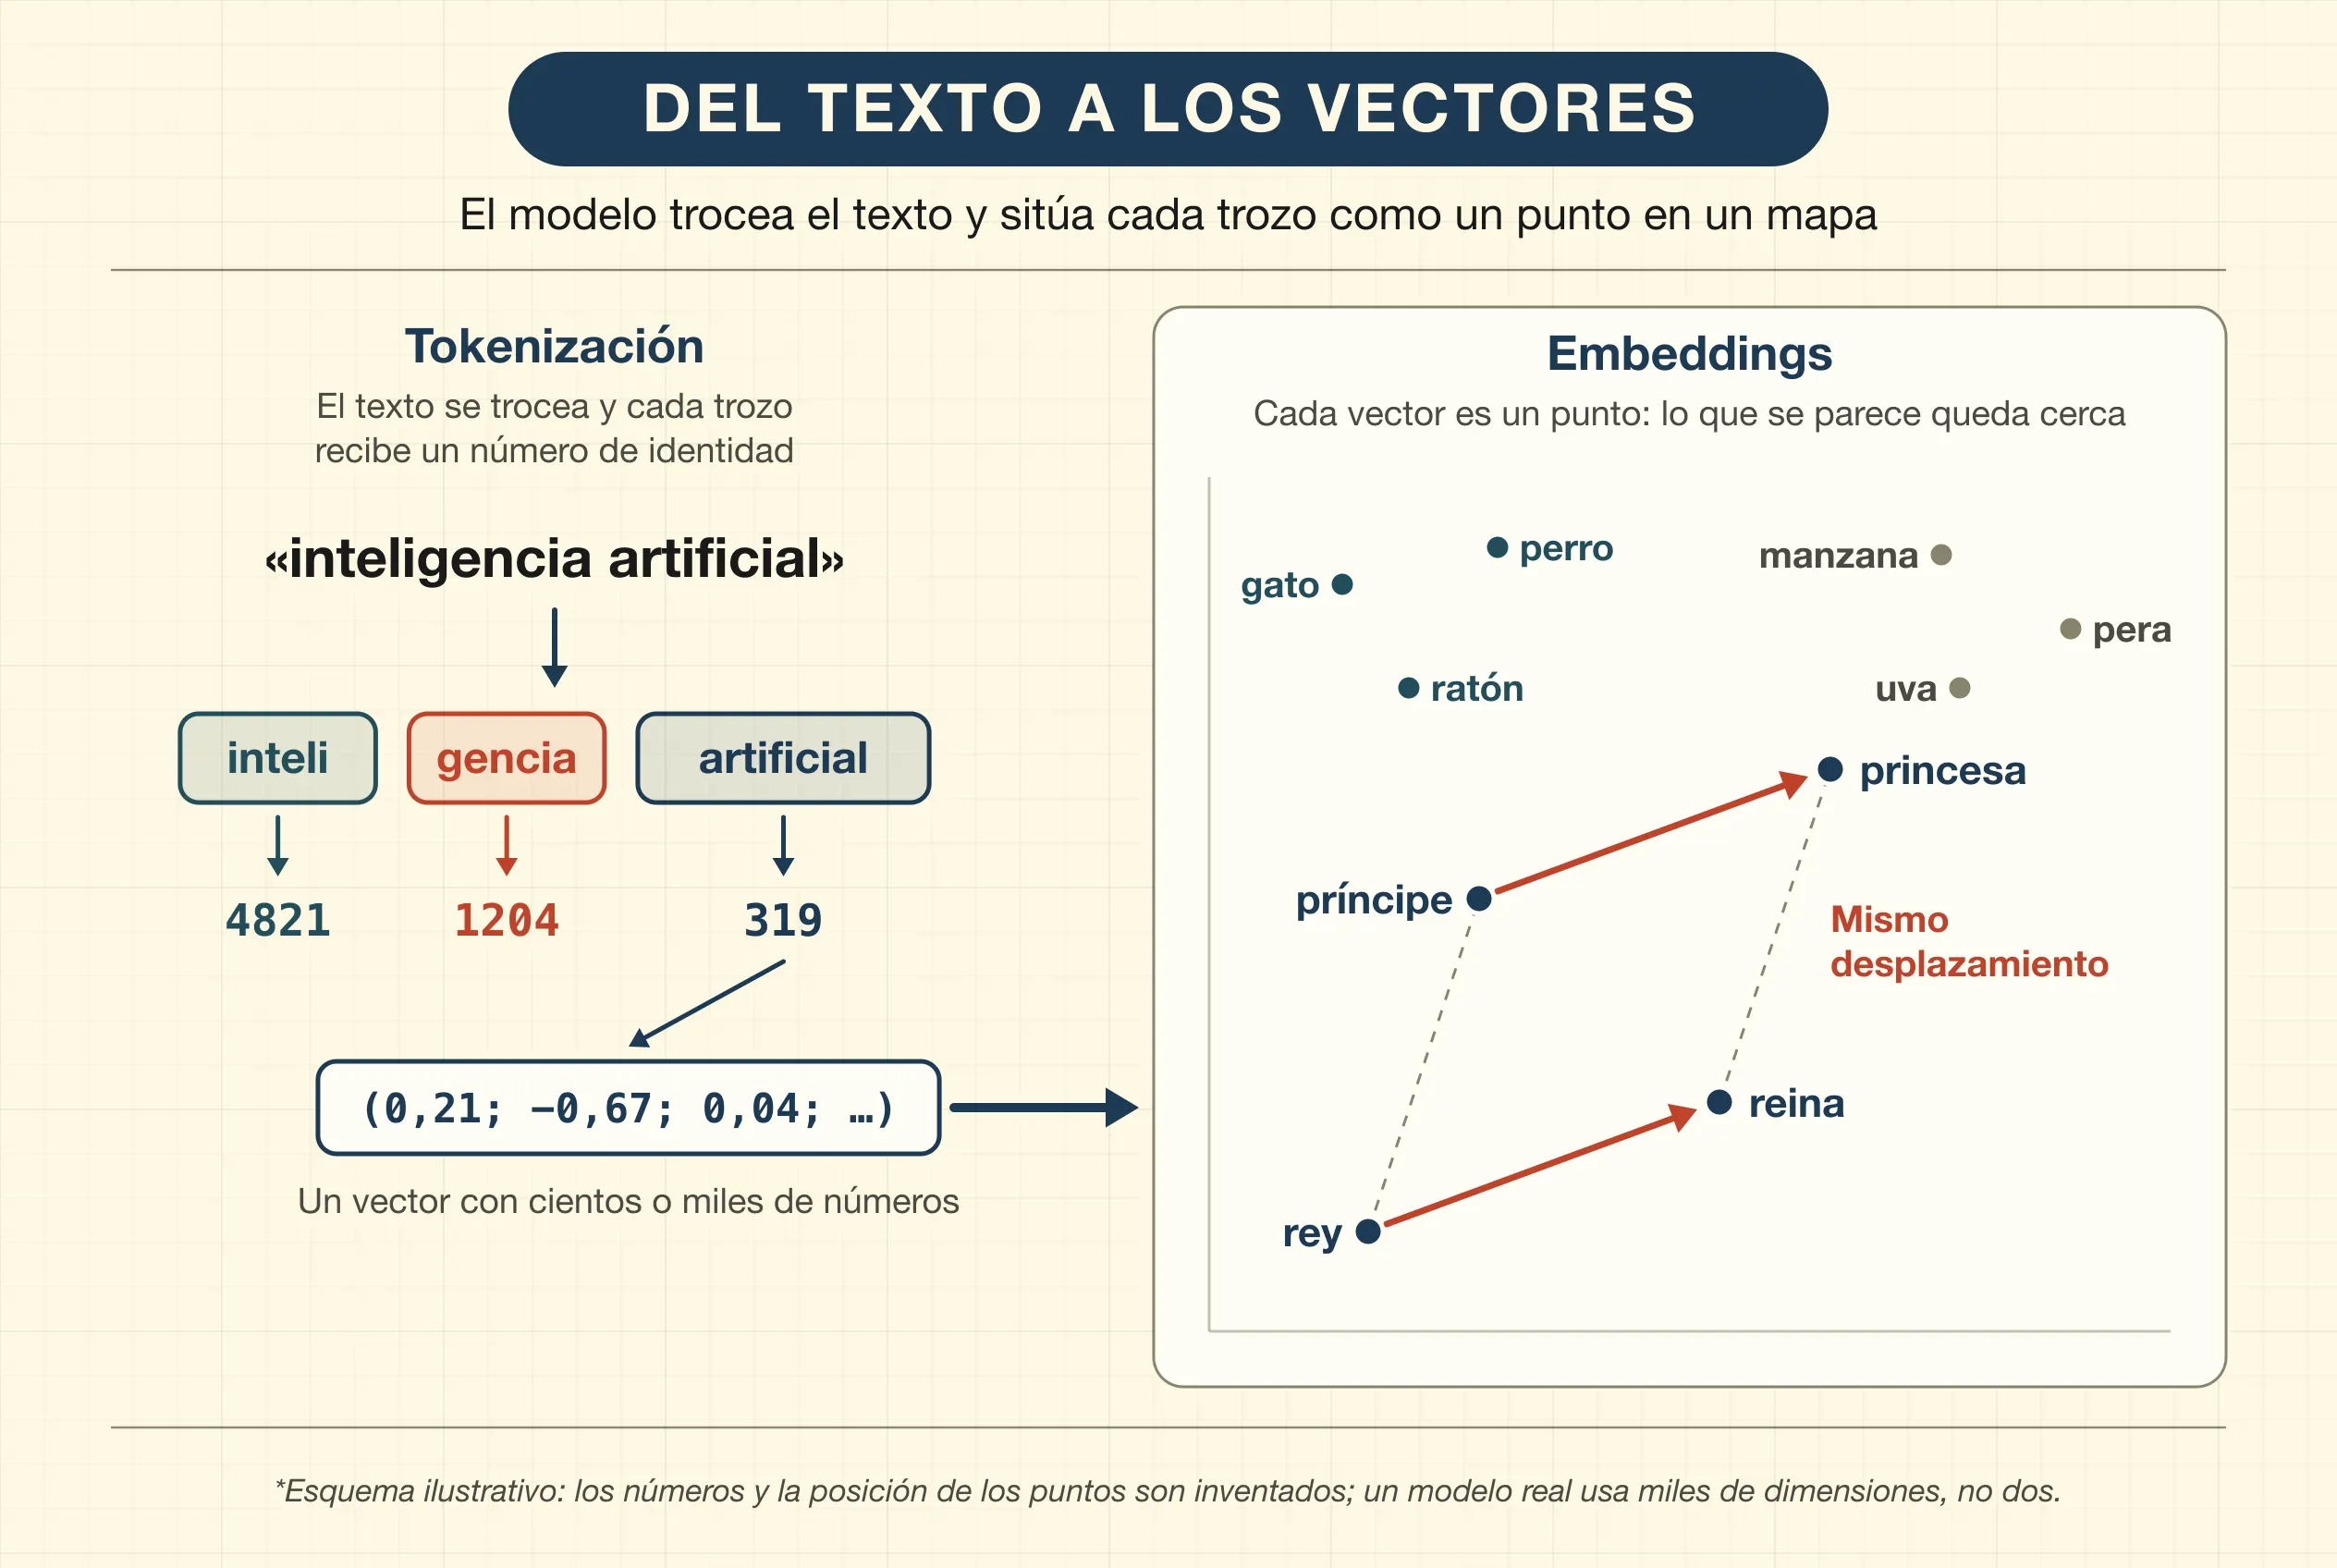
Un ordenador no comprende las palabras como un ser humano. No lee letras ni sílabas: procesa números. Para hacerlo posible, antes de procesar un texto, un LLM lo fragmenta mediante un algoritmo de tokenización.
Un token no es necesariamente una palabra completa: puede ser una palabra entera, una sílaba, un sufijo o incluso un carácter suelto (en inglés, un token equivale de media a unas tres cuartas partes de una palabra, o a unos cuatro caracteres). Por ejemplo, el tokenizador podría descomponer la expresión «inteligencia artificial» en [inteli], [gencia] y [ artificial], y asignar a cada fragmento un identificador numérico único (por ejemplo, [4821, 1204, 319]) dentro de un vocabulario que suele rondar entre los 32.000 y los 250.000 tokens distintos.
Cada token se proyecta después en un espacio matemático de muchísimas dimensiones mediante vectores de incrustación (embeddings), donde las palabras con significados o contextos parecidos quedan cerca unas de otras, como en un mapa. Y las relaciones entre ellas se conservan: el desplazamiento que lleva de «rey» a «reina» es muy parecido al que lleva de «príncipe» a «princesa».
La predicción estocástica
Una vez convertido el texto en una secuencia de números y vectores, el corazón del LLM —una arquitectura basada en el mecanismo de atención, el Transformer— realiza una tarea aparentemente sencilla, pero de una potencia colosal: predecir el siguiente token.
Un LLM no es una base de datos enciclopédica que busca una respuesta fija en un archivo. Es un motor probabilístico de altísima dimensión. Ante una secuencia de entrada (un prompt), la red neuronal aplica las regularidades estadísticas que aprendió de miles de millones de textos y calcula una distribución de probabilidad sobre cuál debe ser el siguiente token más coherente.
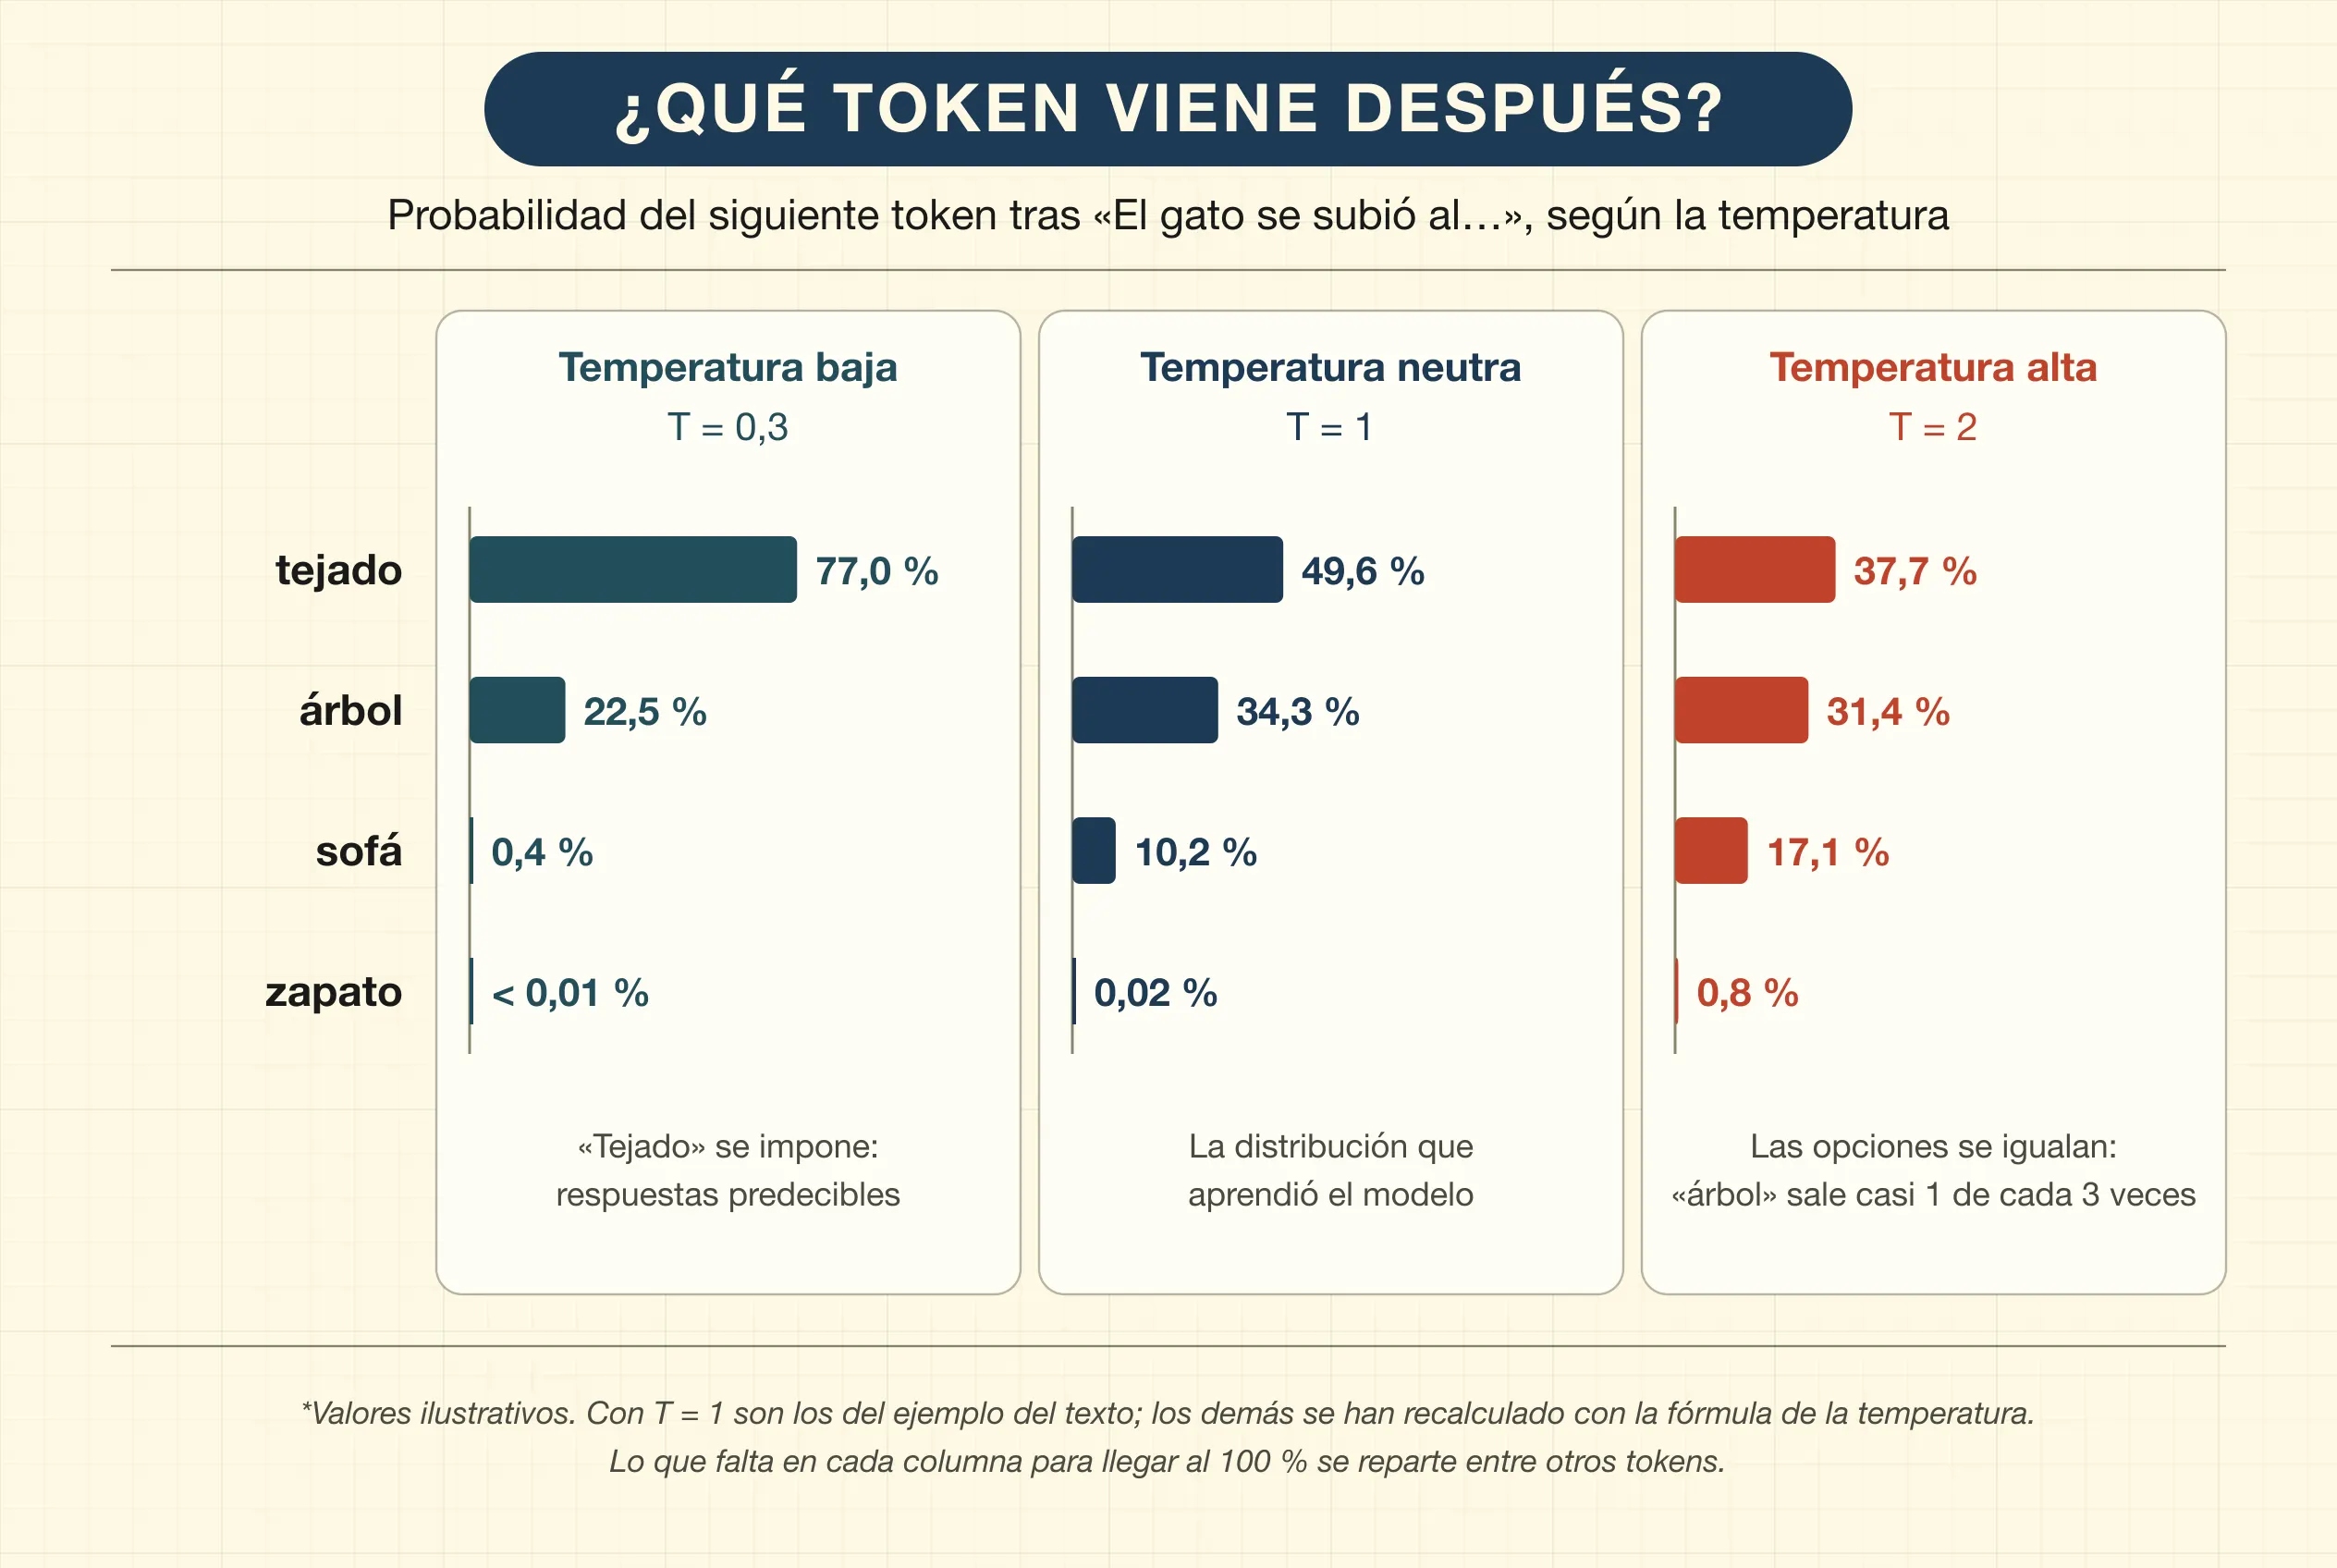
Si le damos la frase incompleta «El gato se subió al…», el motor neuronal no «piensa» en felinos, en tejados ni en la física de la gravedad. Lo que hace es un cálculo probabilístico masivo a través de sus pesos sinápticos, moldeados por los miles de millones de textos que analizó durante su preentrenamiento. El modelo devuelve una distribución de probabilidades para el siguiente token:
- tejado: 49,6 %
- árbol: 34,3 %
- sofá: 10,2 %
- …
- zapato: 0,02 %
Mediante un parámetro de control, la temperatura, el sistema elige al azar uno de estos tokens —con clara preferencia por los más probables, aunque con cierto margen para la variación creativa— y repite el proceso, token a token, de forma recursiva.
¿Qué es la temperatura? En los modelos de lenguaje, la temperatura es un parámetro numérico que controla el grado de aleatoriedad y creatividad del texto generado. Actúa sobre las probabilidades con las que el modelo elige el siguiente token: a menor temperatura, más determinista y predecible es la respuesta; a mayor temperatura, más creativa y variada.
Del mismo modo, si escribimos «El gato se comió el…», el modelo calculará que la probabilidad de que el siguiente token sea «pescado» o «pienso» es altísima, mientras que la de «nebulosa» o «violín» es prácticamente nula. Al encadenar a gran velocidad miles de estas predicciones, surge la ilusión de una conversación fluida, coherente y creativa.
Esta fluidez estocástica, ejecutada a escala colosal sobre miles de millones de parámetros, es lo que simula de manera tan convincente la competencia cognitiva humana, y difumina la frontera entre el cálculo numérico y el discurso racional.
Referencias y respaldo científico
- El artículo en el que Turing sustituyó la pregunta «¿pueden pensar las máquinas?» por el juego de la imitación. Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433-460. Consultar artículo (DOI)
- La habitación china: manipular símbolos siguiendo unas reglas no basta para entender lo que significan. Searle, J. R. (1980). Minds, brains, and programs. Behavioral and Brain Sciences, 3(3), 417-424. Consultar artículo (DOI)
- El primer modelo matemático de la neurona: una unidad lógica que se activa o no según las señales que recibe. McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115-133. Consultar artículo (DOI)
- Con un 2 % del peso corporal, el cerebro se lleva el 20 % del gasto metabólico y funciona con unos 20 vatios, menos que un portátil. Balasubramanian, V. (2021). Brain power. Proceedings of the National Academy of Sciences, 118(32), e2107022118. Consultar artículo (DOI)
- El recuento que fijó en unos 86.000 millones las neuronas del cerebro humano. Azevedo, F. A. C., Carvalho, L. R. B., Grinberg, L. T., Farfel, J. M., Ferretti, R. E. L., Leite, R. E. P., Jacob Filho, W., Lent, R., & Herculano-Houzel, S. (2009). Equal numbers of neuronal and nonneuronal cells make the human brain an isometrically scaled-up primate brain. The Journal of Comparative Neurology, 513(5), 532-541. Consultar estudio (DOI)
- La idea de que aprender consiste en reforzar las conexiones entre neuronas que se activan a la vez. Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley. Consultar libro (DOI)
- El perceptrón de Rosenblatt: una red que aprende a clasificar ajustando sus pesos a partir de ejemplos. Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. Consultar artículo (DOI)
- El límite de una sola capa: ningún perceptrón simple puede aprender el «o exclusivo». Minsky, M., & Papert, S. (1969). Perceptrons: An introduction to computational geometry. MIT Press. Consultar libro (reedición de 2017)
- La retropropagación: cómo repartir el error entre las capas ocultas para que una red de varias capas aprenda. Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533-536. Consultar estudio (DOI)
- AlexNet, la red profunda entrenada con GPU que en 2012 sacó diez puntos de ventaja a sus rivales en ImageNet. Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2017). ImageNet classification with deep convolutional neural networks. Communications of the ACM, 60(6), 84-90 (publicado originalmente en NeurIPS 2012). Consultar estudio (DOI)
- Lo que ve cada capa de una red de visión: bordes en las primeras, formas en las intermedias, objetos en las últimas. Zeiler, M. D., & Fergus, R. (2014). Visualizing and understanding convolutional networks. Computer Vision – ECCV 2014, Lecture Notes in Computer Science, 8689, 818-833. Consultar estudio (DOI)
- La revisión de los tres pioneros del deep learning: aprender las representaciones a partir de los datos en lugar de diseñarlas a mano. LeCun, Y., Bengio, Y., & Hinton, G. (2015). Deep learning. Nature, 521(7553), 436-444. Consultar artículo (DOI)
- La tokenización en subpalabras: trocear las palabras poco frecuentes en fragmentos que sí lo son. Sennrich, R., Haddow, B., & Birch, A. (2016). Neural machine translation of rare words with subword units. Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics, 1715-1725. Consultar estudio (DOI)
- Las analogías en el espacio de vectores: «rey» es a «reina» lo que «hombre» es a «mujer». Mikolov, T., Yih, W., & Zweig, G. (2013). Linguistic regularities in continuous space word representations. Proceedings of NAACL-HLT 2013, 746-751. Consultar estudio en ACL Anthology
- El artículo que presentó el Transformer, la arquitectura basada solo en el mecanismo de atención sobre la que se construyen los LLM actuales. Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998-6008. Consultar estudio en arXiv
- GPT-3: un modelo entrenado solo para predecir el siguiente token que, a gran escala, resuelve tareas nuevas a partir de unos pocos ejemplos. Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., … & Amodei, D. (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems, 33, 1877-1901. Consultar estudio en arXiv
- Cómo se elige cada token: la temperatura y otras estrategias de muestreo, y por qué quedarse siempre con el más probable produce textos repetitivos. Holtzman, A., Buys, J., Du, L., Forbes, M., & Choi, Y. (2020). The curious case of neural text degeneration. International Conference on Learning Representations (ICLR). Consultar estudio en arXiv
- La habitación china, cuarenta años después: los «loros estocásticos» que encadenan formas lingüísticas sin acceso a su significado. Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610-623. Consultar artículo (DOI)
Estamos preparando el espacio para que puedas comentar los artículos.
Sigue leyendo
Efecto Zeigarnik o el coste de tener ideas brillantes
El fenómeno psicológico que sabotea tu descanso en nombre de la creatividad
La procrastinación y el secuestro límbico
La neurociencia demuestra que la procrastinación no es falta de voluntad ni de organización, sino un mecanismo de defensa para regular la frustración