Límites, alucinaciones y el coste real
Por qué la inteligencia artificial no piensa, los atolladeros de la memoria sintética y la factura física, energética y legal
Cuando un usuario interactúa con un modelo de lenguaje avanzado y recibe una respuesta redactada con una fluidez impecable, un tono empático y una gramática perfecta, es casi inevitable que se active un sesgo cognitivo ancestral: la antropomorfización. Asumimos de manera intuitiva que detrás de esas palabras hay una mente que comprende, un sujeto que reflexiona y una conciencia que evalúa la verdad. El fenómeno es tan viejo como la informática conversacional: ya en 1966, Joseph Weizenbaum se sorprendió al ver que sus usuarios confiaban sus intimidades a ELIZA, un programa que se limitaba a devolverles sus propias frases reformuladas. Sin embargo, este espejo conversacional es una elegante ilusión matemática.
Confundir la fluidez verbal con el razonamiento real es el mayor equívoco del ecosistema tecnológico actual. Mientras que la cognición humana se fundamenta en la experiencia, la intencionalidad, el significado vivido y la comprensión de la causalidad física, los modelos de lenguaje procesan correlaciones estadísticas masivas entre símbolos (tokens) en espacios vectoriales de muy alta dimensión: calculan probabilidades sobre secuencias de texto. Hasta qué punto eso puede llegar a llamarse razonar es una pregunta abierta entre los investigadores, pero sus fallos dejan claro que no razonan como nosotros.
Desentrañar los límites, los fallos estructurales y la factura material de la IA exige abandonar el terreno de la magia y adentrarse en los engranajes de su propia arquitectura. El análisis riguroso revela que la inteligencia sintética no solo padece fallos de memoria y errores de invención, sino que arrastra una pesada hipoteca física, ambiental y legal que el brillo comercial de las interfaces suele ocultar.
Cuando la IA «miente» y se despista
En la jerga periodística y comercial se ha vuelto habitual decir que los modelos de lenguaje «alucinan» cuando ofrecen datos falsos. Sin embargo, desde el punto de vista de la ingeniería, el término es inexacto y engañoso: sugiere una desviación patológica de un estado normal de consciencia. En realidad, lo que llamamos alucinación no es una avería del sistema, sino su modo normal de funcionamiento: el mismo mecanismo que produce las respuestas correctas produce también las falsas.
Tres factores explican el comportamiento errático de las inteligencias artificiales.
El completado estocástico
Los grandes modelos de lenguaje (LLM) no consultan una enciclopedia interna ni sopesan conceptos abstractos antes de responder; lo que hacen es un completado estocástico. Ante una secuencia de tokens (palabras o fragmentos de palabras), el modelo calcula la probabilidad de cada posible token siguiente y elige uno, como vimos en la primera parte, basándose en los patrones estadísticos aprendidos durante su entrenamiento.
Esta naturaleza llevó a la lingüista Emily Bender y a sus coautoras a popularizar el concepto del «loro estocástico»: el sistema repite patrones formales del lenguaje con una perfección pasmosa, pero sin anclaje real en el significado del mundo físico. Cuando una IA «alucina» —es decir, inventa una cita histórica, un artículo científico inexistente o un dato financiero falso— no está mintiendo con malicia; simplemente completa la frase con lo estadísticamente probable, cosiendo palabras que suenan coherentes juntas, aunque no correspondan a ningún hecho real.
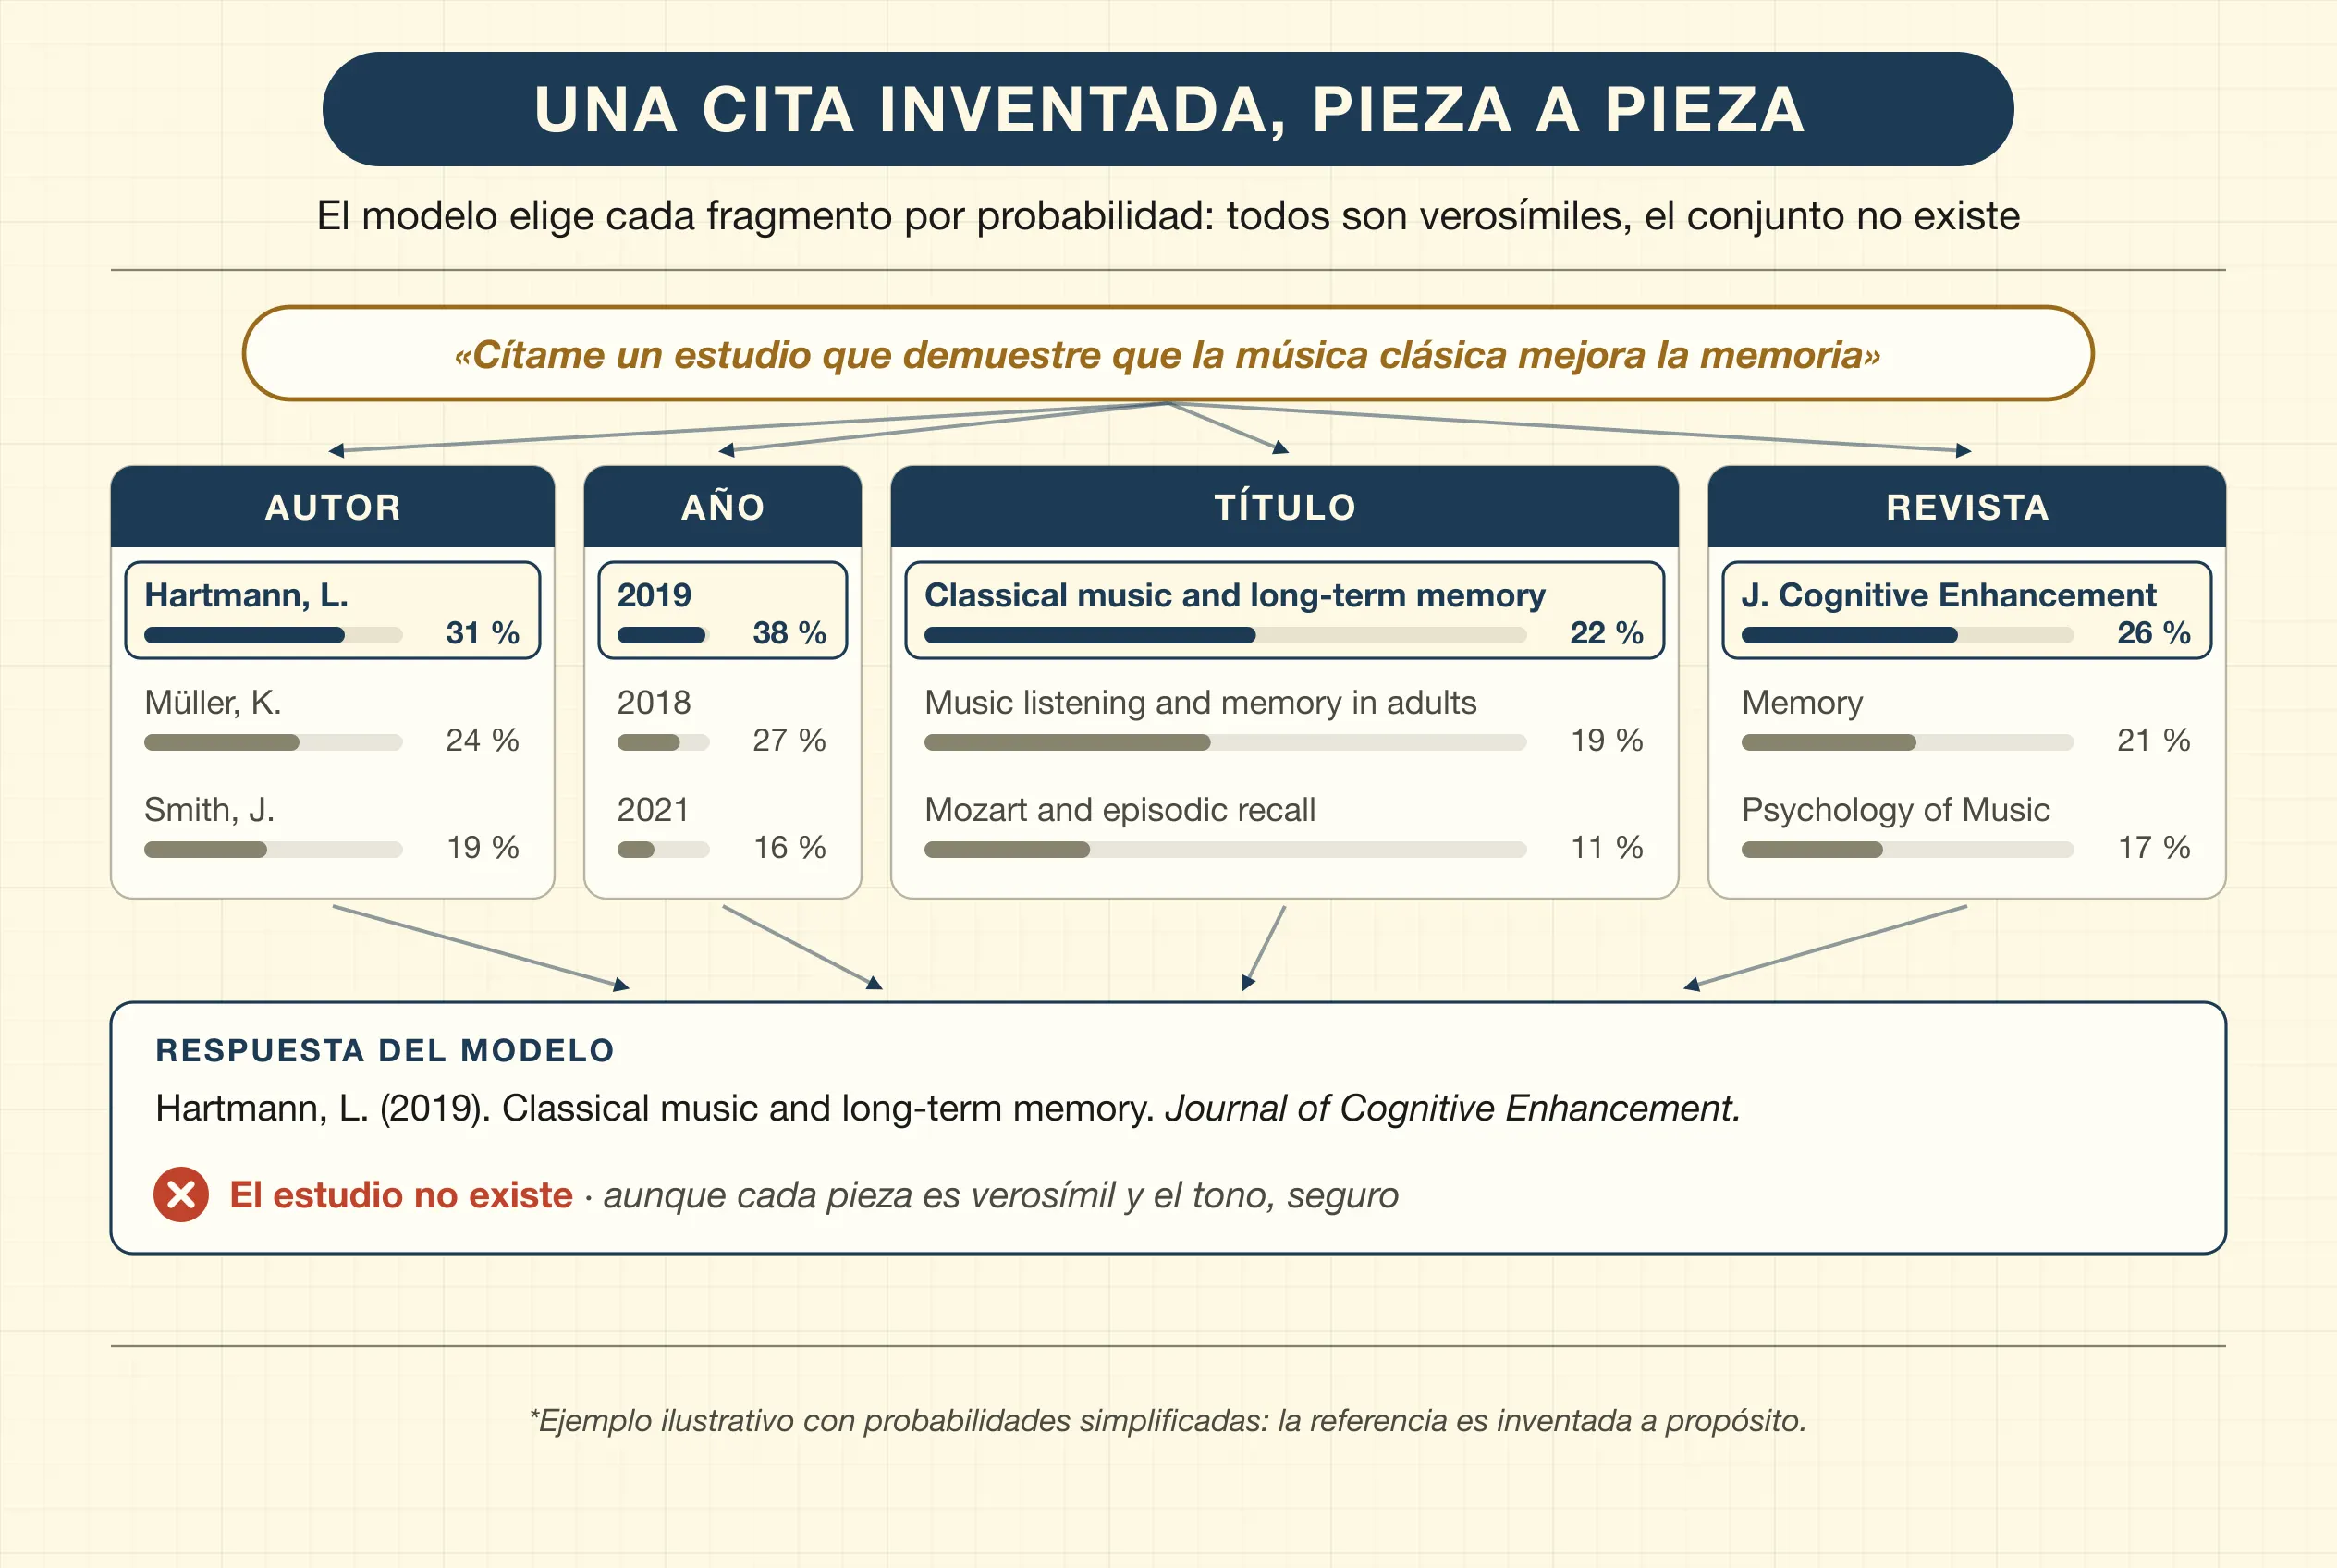
El propio entrenamiento empeora el problema. Las pruebas con que se evalúan los modelos suelen puntuar igual un «no lo sé» que una respuesta equivocada, de modo que a un modelo le compensa arriesgar, como a un estudiante en un examen tipo test que no resta por fallo. Por eso un modelo prefiere inventar con seguridad antes que reconocer que no sabe.
La ventana de contexto gigante
Las especificaciones técnicas de los modelos modernos presumen de «ventanas de contexto» descomunales, capaces de procesar desde 128.000 hasta más de un millón de tokens en una sola petición, el equivalente a varios libros enteros. No obstante, la capacidad de retener y usar con precisión la información contenida en esos textos no es uniforme.
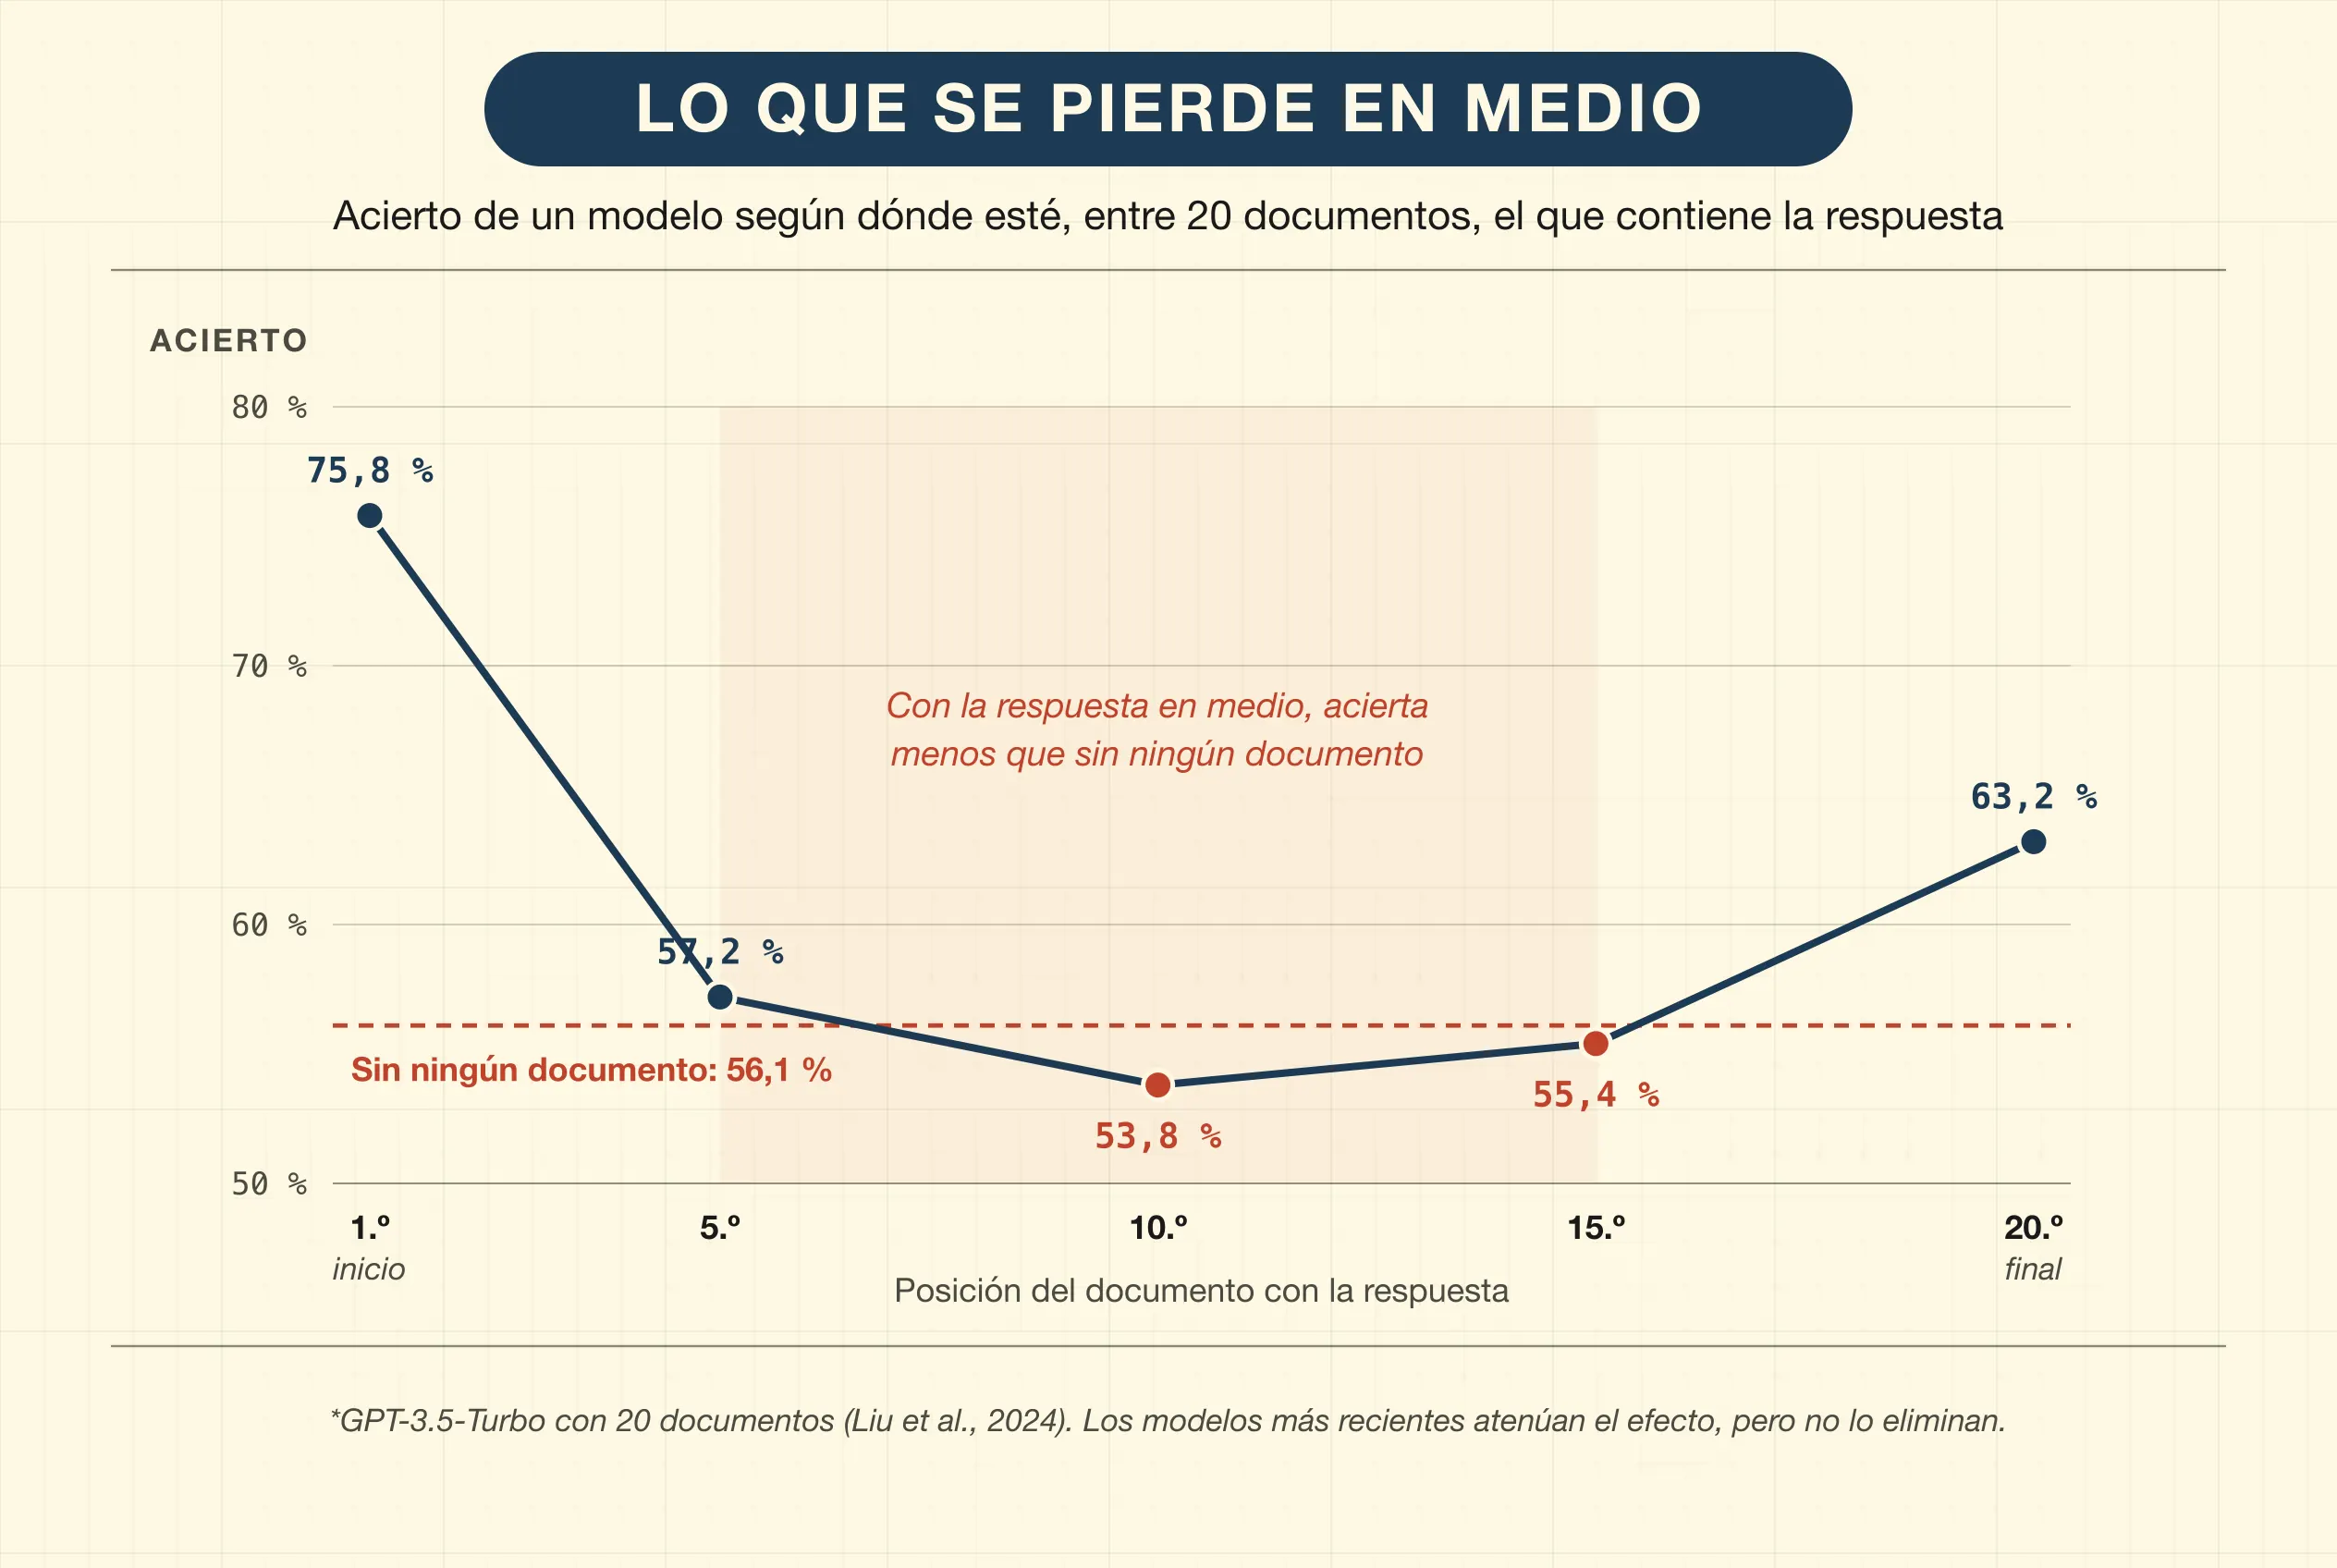
- El efecto lost in the middle: varios estudios han mostrado que el rendimiento de los modelos dibuja una curva en forma de U según dónde esté el dato que necesitan. Aprovechan muy bien la información situada al principio y al final del texto, pero su acierto cae notablemente con la que queda en medio: en uno de los primeros experimentos, más de 20 puntos. Los modelos más recientes han atenuado el efecto, pero no lo han eliminado.
- La aguja en el pajar: encontrar una frase concreta escondida en un documento enorme ya no es un reto para los modelos actuales. Lo difícil llega cuando hay que relacionar varios datos dispersos o razonar sobre ellos: ahí el rendimiento cae a medida que crece el texto, aunque el archivo entero «quepa» formalmente en su memoria operativa. En una evaluación de 2024, solo la mitad de los modelos que anunciaban ventanas de 32.000 tokens o más mantenían un rendimiento aceptable a esa longitud.
La falta de sentido común y de causalidad física
Los humanos poseemos un sentido común basado en la física, la causalidad y la experiencia corporal. Sabemos que si soltamos un vaso de cristal al suelo se romperá, o que no podemos meter un objeto grande dentro de uno más pequeño.
La IA carece de este marco de referencia empírico. Conoce la relación entre las palabras que describen el mundo, no el mundo en sí. Por ello, es propensa a cometer errores lógicos flagrantes en cuanto se la saca de los patrones que aparecen de forma explícita en sus datos de entrenamiento. En un experimento de 2024 bastó con cambiar los nombres y las cifras de problemas escolares de matemáticas para que el acierto de los modelos bajara, y con añadir una frase irrelevante al enunciado para que se desplomara hasta un 65 % en algunos de ellos. Operan en un universo puramente relacional de símbolos, desprovisto de fricción material.
El muro de los datos
Para entrenar los modelos de frontera actuales, los laboratorios tecnológicos han necesitado devorar volúmenes colosales de información: prácticamente la totalidad de los libros digitalizados, artículos científicos, prensa histórica, Wikipedia, repositorios de código y foros públicos generados por la humanidad a lo largo de décadas. Este modelo de desarrollo se acerca ahora a un límite muy concreto: el agotamiento del internet humano.
La escasez de materia prima original
Según las estimaciones más citadas, al ritmo actual la industria habrá consumido todo el texto humano público de calidad entre 2026 y 2032. Ante la perspectiva de ese desierto de datos frescos, las grandes corporaciones recurren cada vez más a los datos sintéticos: utilizar modelos de IA potentes para generar millones de textos e imágenes con los que entrenar a las siguientes generaciones de algoritmos.
El colapso del modelo
Esta práctica ha sacado a la luz un problema matemático conocido como el colapso del modelo o la «consanguinidad digital». ¿Qué ocurre cuando una inteligencia artificial se alimenta de los contenidos generados por otras inteligencias artificiales?
- Primera generación: el modelo aprende de datos humanos diversos, llenos de matices, excepciones y riqueza estilística.
- Segunda generación: se entrena con los textos que produjo la anterior. Como esta tiende a repetir lo más frecuente, el modelo empieza a perder los casos poco comunes, las colas de la distribución estadística. La diversidad se empobrece y desaparecen los matices más raros, minoritarios o creativos de la cultura humana.
- Generaciones avanzadas: la red se alimenta casi exclusivamente de datos sintéticos previsibles. Los errores, las alucinaciones residuales y la falta de variedad se amplifican en bucle. El modelo pierde la capacidad de representar la realidad, sufre una degradación irreversible y acaba convertido en un repertorio de respuestas hiperestereotipadas y vacías.
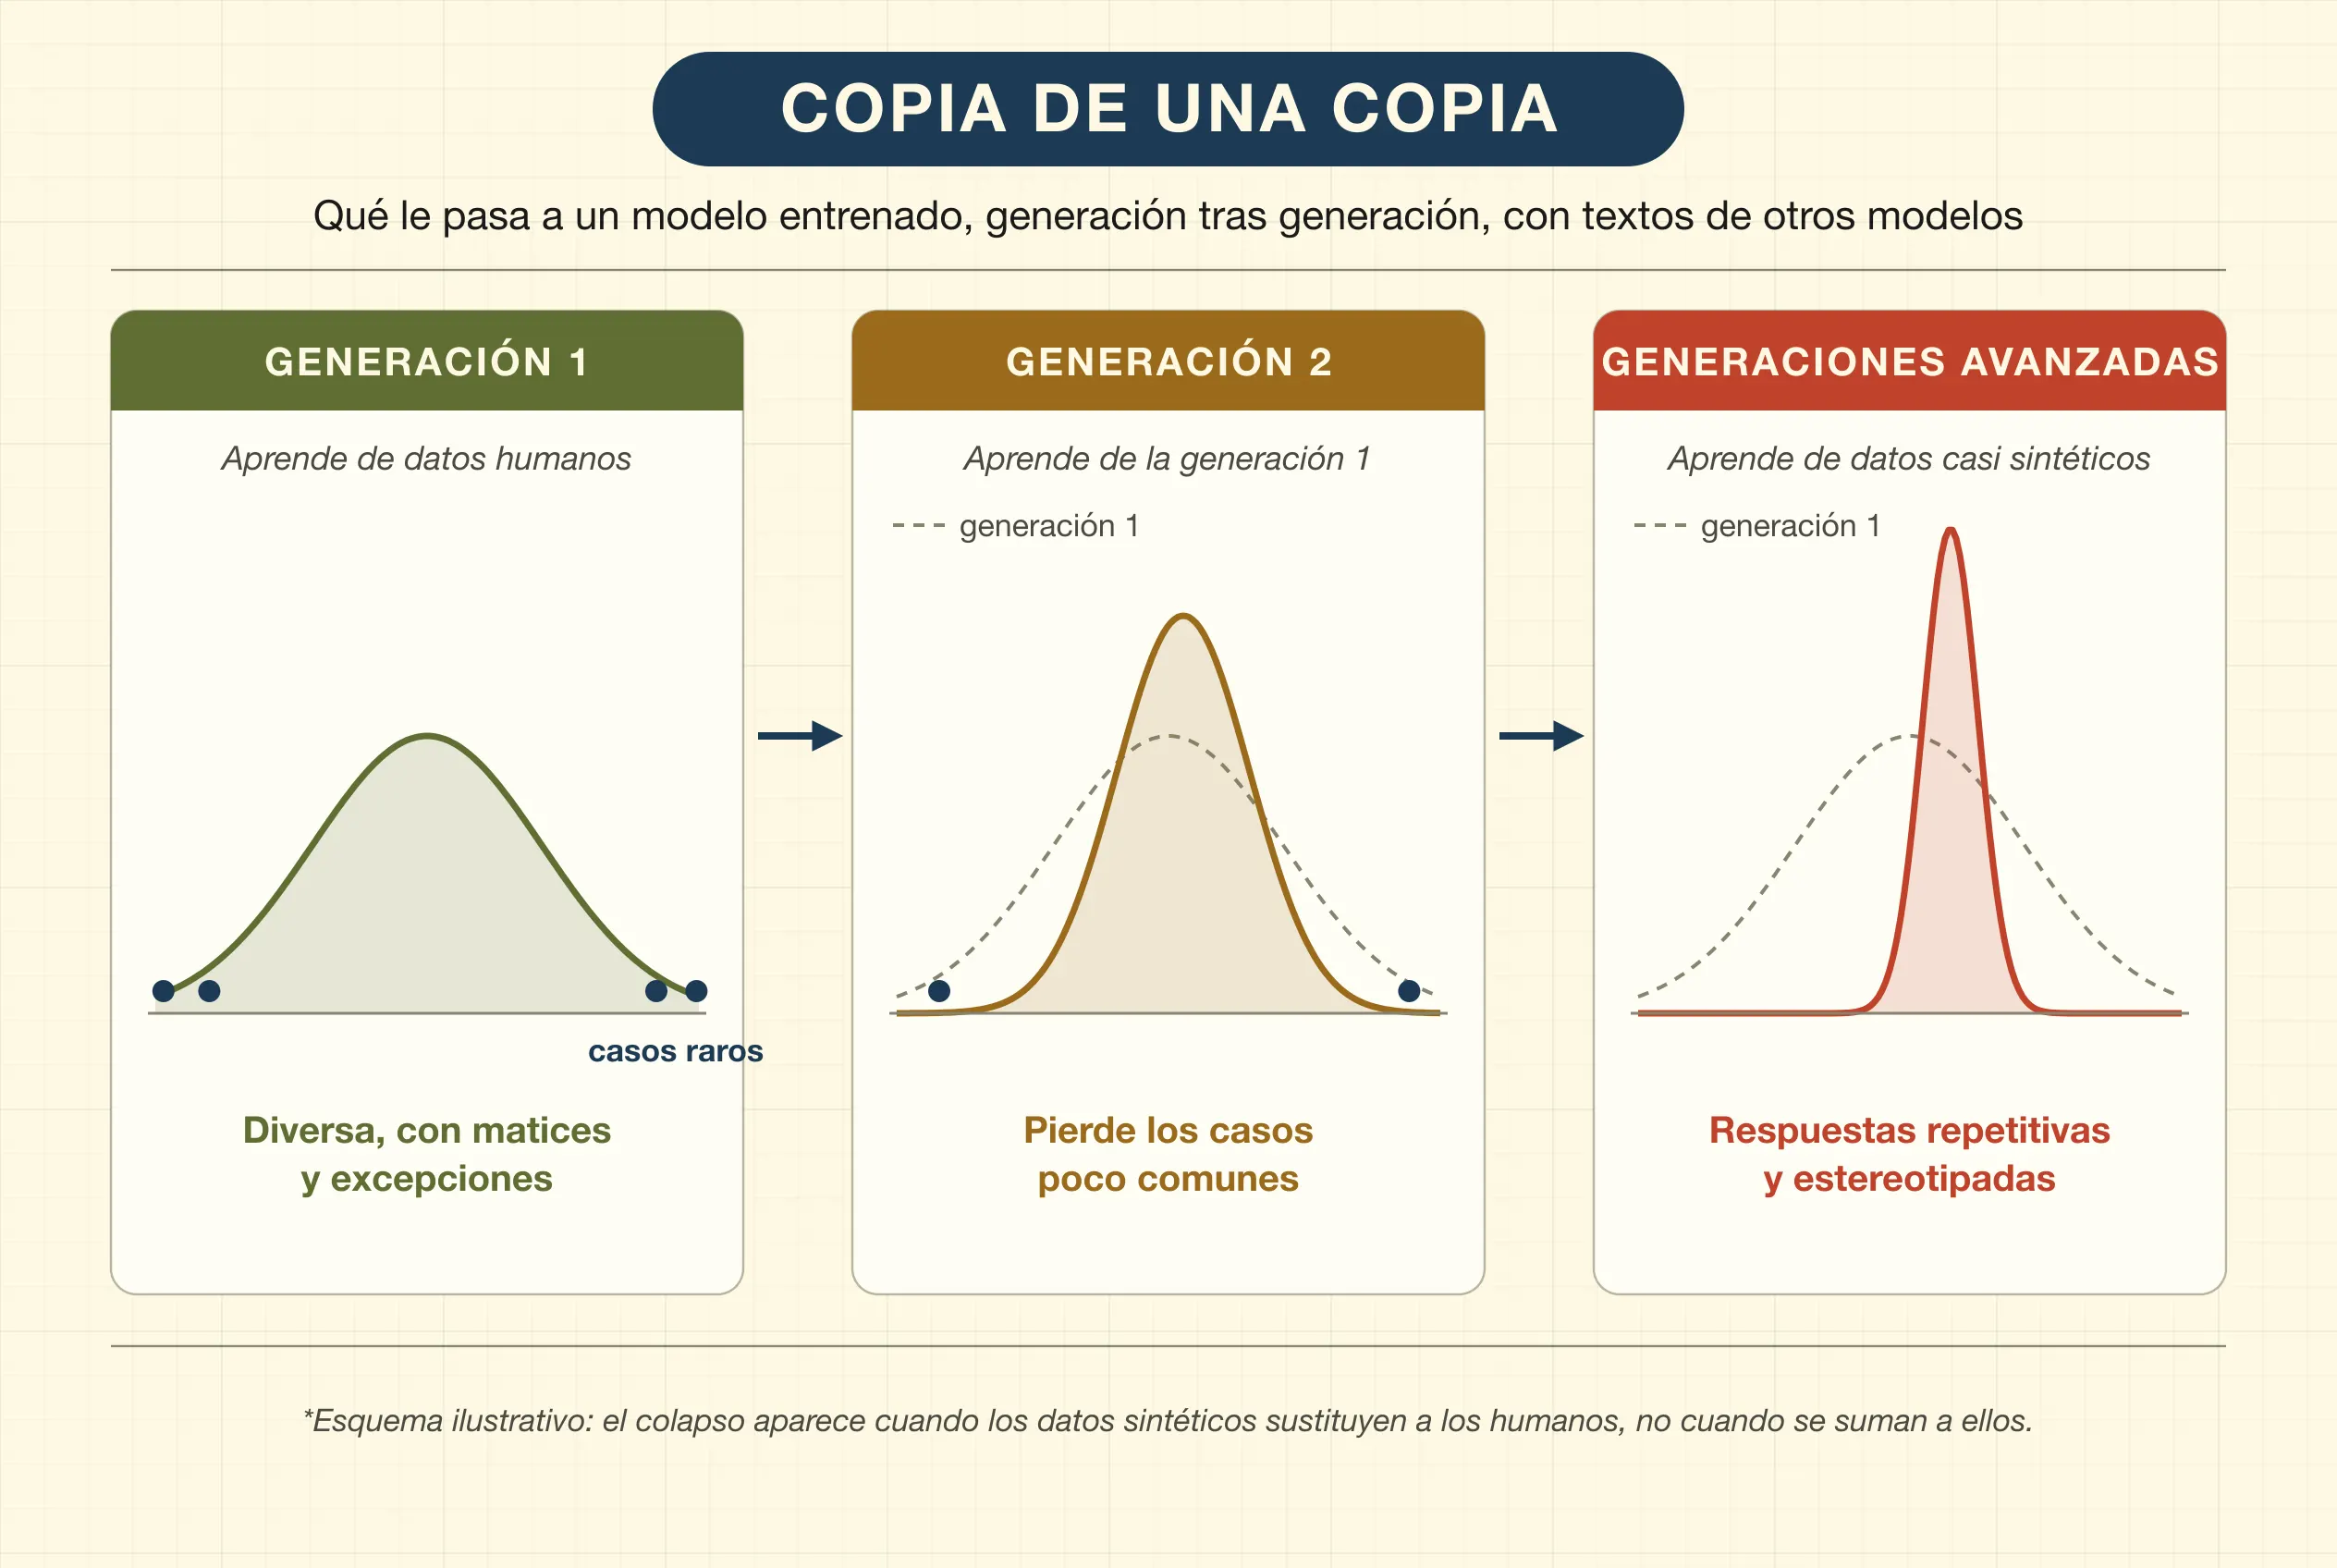
El colapso aparece sobre todo cuando los datos sintéticos sustituyen a los humanos. Si se acumulan junto a ellos y se filtran con cuidado, el riesgo se reduce mucho, y de hecho los laboratorios ya entrenan con datos sintéticos con buenos resultados. El problema es que internet se llena de textos generados por IA sin etiquetar, y separar unos de otros es cada vez más difícil.
Costes físicos y legales
La percepción popular de la inteligencia artificial como una tecnología etérea, alojada en una «nube» ingrávida e inmaterial, choca frontalmente con la cruda realidad de su infraestructura industrial, profundamente anclada en la física, la geografía y el consumo de recursos naturales. El silicio pesa, la electricidad contamina y los datos tienen propietarios.
La factura energética e hídrica
El entrenamiento y el funcionamiento de los grandes modelos de lenguaje exigen infraestructuras de supercomputación de escala colosal, equipadas con decenas de miles de tarjetas de procesamiento gráfico (GPU).
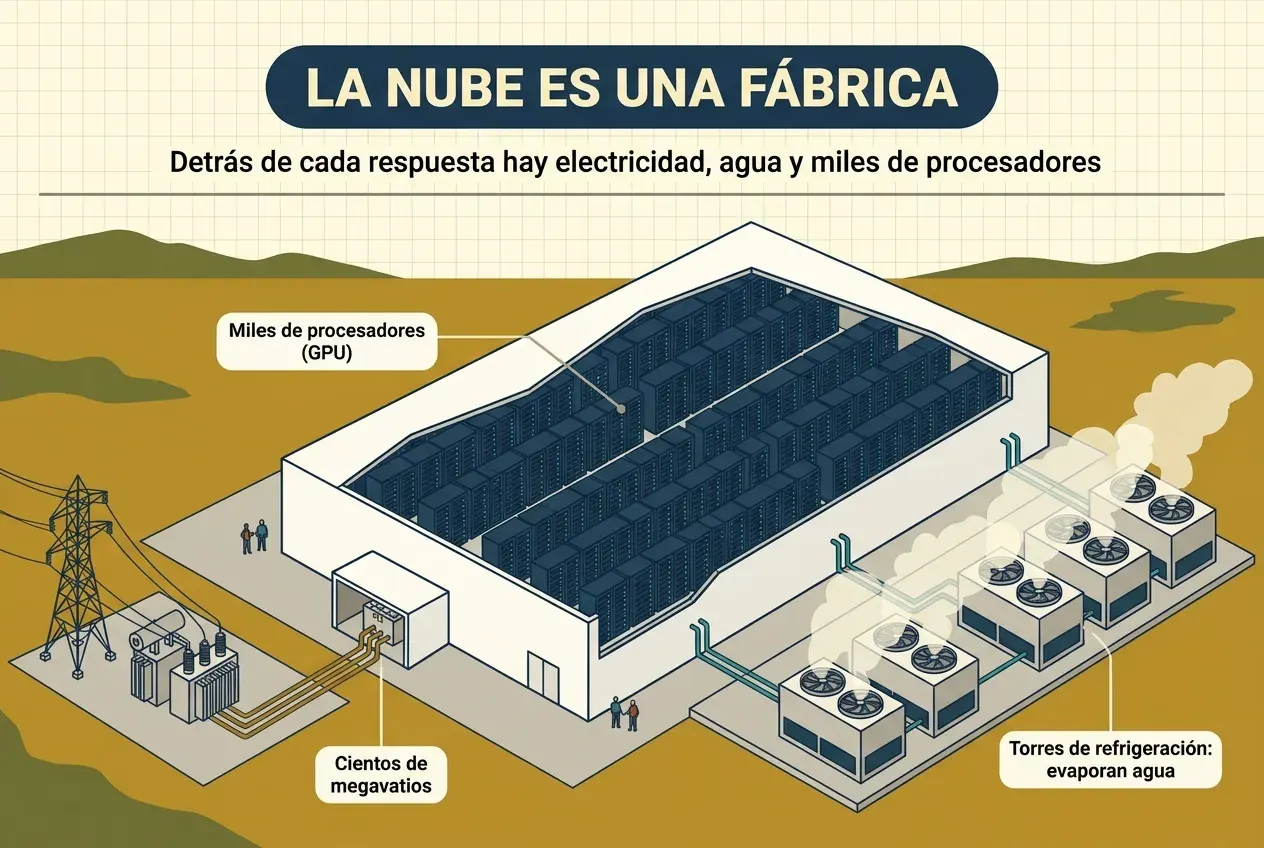
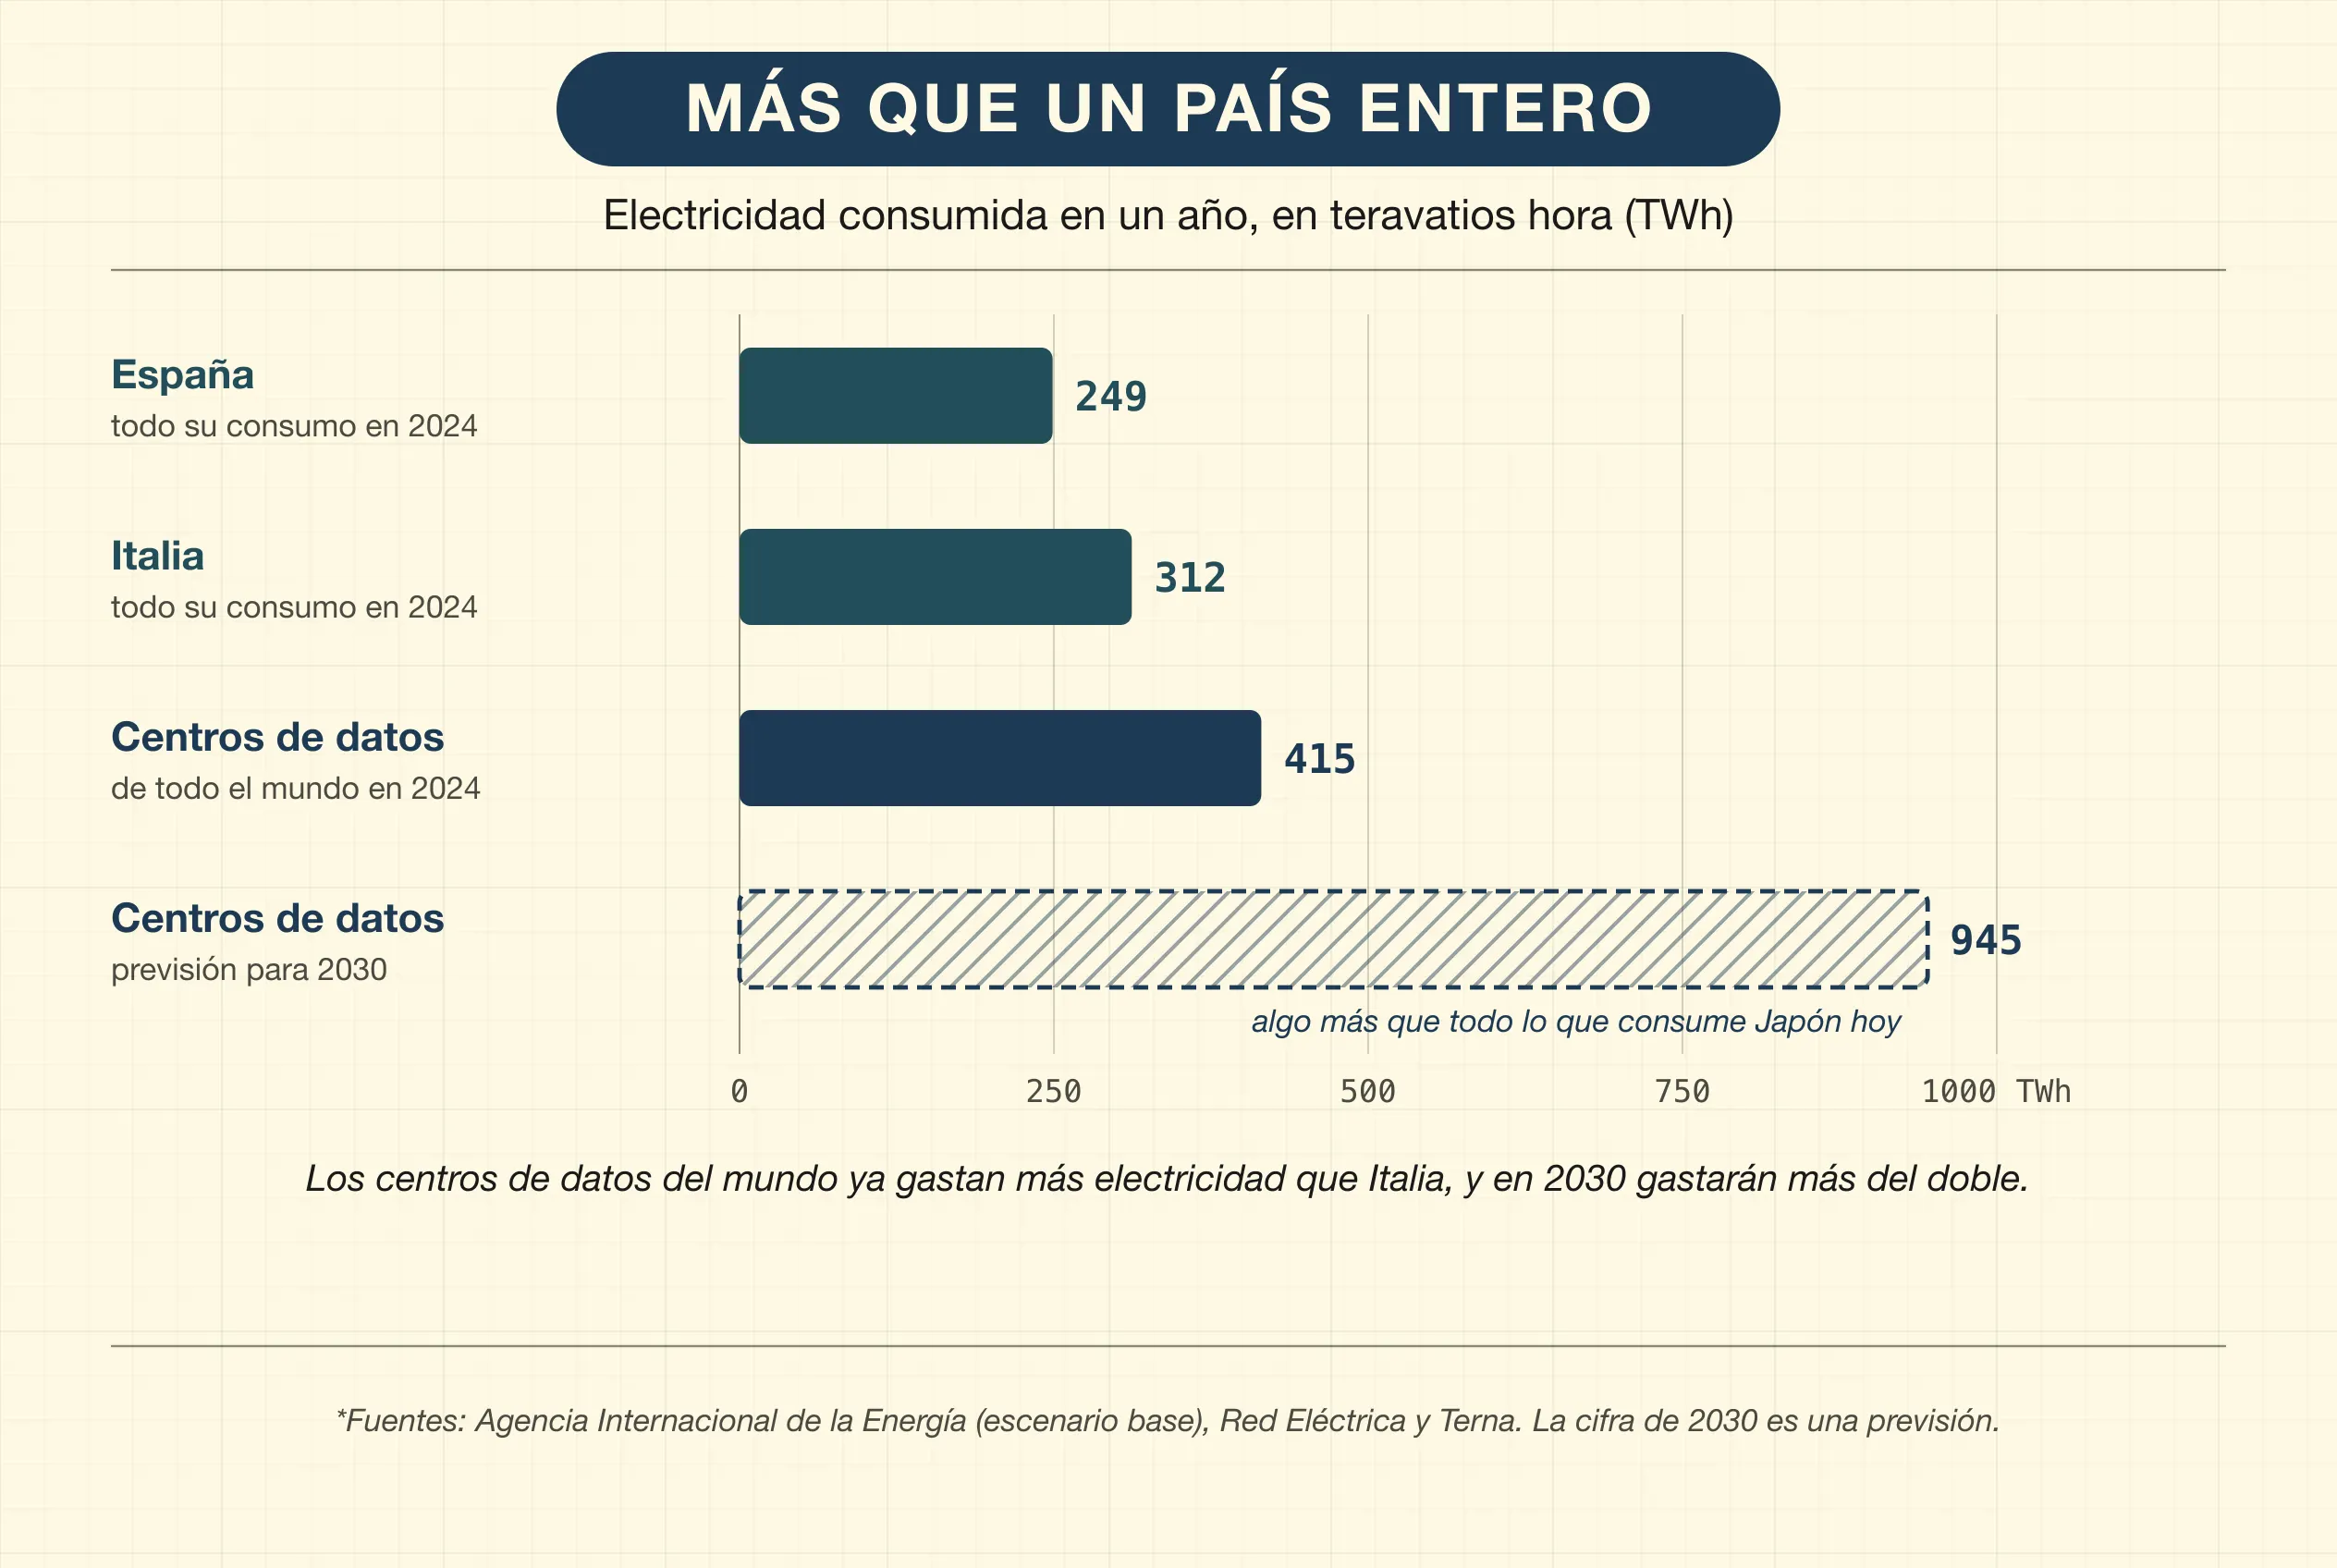
- Consumo eléctrico: los mayores centros de datos consumen cientos de megavatios de forma ininterrumpida, y entrenar un solo modelo de frontera puede requerir tanta electricidad como la que gastan en un año miles de hogares. En conjunto, los centros de datos del mundo consumieron unos 415 teravatios hora en 2024, alrededor del 1,5 % de la electricidad mundial, y la Agencia Internacional de la Energía prevé que la cifra se duplique de aquí a 2030, impulsada sobre todo por la IA.
- Coste computacional cuadrático: en las arquitecturas actuales, el cálculo del mecanismo de atención no crece en proporción a la longitud del texto, sino con su cuadrado. Duplicar el texto que le entregamos a una IA cuadruplica ese cálculo en el servidor, lo que dispara el gasto energético de las peticiones largas.
- Huella hídrica: las granjas de servidores generan un calor extremo. Para evitar el colapso térmico de los circuitos, muchas emplean torres de refrigeración por evaporación que consumen millones de litros de agua dulce, a menudo potable, y tensionan las reservas hídricas de las regiones donde se ubican. Solo el entrenamiento de GPT-3 pudo evaporar unos 700.000 litros.
La crisis de la propiedad intelectual
La recolección masiva de datos (web scraping) para alimentar a las IA se realizó durante años en una zona de penumbra legal, absorbiendo obras protegidas por derechos de autor sin el consentimiento, la atribución ni la compensación de sus creadores.
Hoy, tribunales de todo el mundo juzgan demandas de escritores, artistas visuales, fotógrafos y medios de comunicación. El debate jurídico contrapone la doctrina del «uso legítimo» (fair use) que defienden las tecnológicas, según las cuales el modelo solo «aprende» patrones abstractos, a las acusaciones de extractivismo de datos y competencia desleal, ya que los modelos comercializados compiten en el mercado con los mismos creadores de cuyas obras se nutrieron.
Las primeras sentencias dibujan un panorama matizado. En 2025, un juez estadounidense consideró uso legítimo entrenar un modelo con libros comprados, pero no descargar copias piratas para construir una biblioteca, y Anthropic pagó 1.500 millones de dólares para cerrar el caso. Ese mismo año, un tribunal británico dio la razón en lo esencial a Stability AI frente a Getty Images, mientras que la demanda de The New York Times contra OpenAI sigue abierta. En Europa, el Reglamento de IA obliga ya a los proveedores de modelos de uso general a publicar un resumen de sus datos de entrenamiento y a respetar a los autores que se oponen a que sus obras se usen.
Los sesgos algorítmicos y el espejo social
Dado que los modelos se alimentan del archivo histórico de la sociedad humana, heredan de forma inevitable sus inercias, prejuicios y discriminaciones sistémicas. Si los textos contienen sesgos de género, raciales o socioeconómicos, el modelo los codificará como correlaciones estadísticas válidas. Un estudio de 2024 lo mostró con crudeza: los modelos asignaban empleos menos prestigiosos y condenas más duras a personas que escribían en inglés afroamericano, aunque al preguntarles directamente expresaran opiniones favorables sobre ellas.
Sin una supervisión humana rigurosa que ajuste su ética, la IA actúa como un amplificador automatizado de los prejuicios del pasado, disfrazándolos de una pretendida objetividad matemática. Además, esto plantea una pregunta sin respuesta sencilla: ¿quién tiene capacidad para afinar la ética de una IA? ¿Quién es dueño de la moral?
Referencias y respaldo científico
- ELIZA, el primer programa conversacional, y la sorpresa de su autor al ver cuánto se encariñaban con él sus usuarios. Weizenbaum, J. (1966). ELIZA—A computer program for the study of natural language communication between man and machine. Communications of the ACM, 9(1), 36-45. Consultar artículo (DOI)
- El artículo de los «loros estocásticos»: modelos que encadenan formas lingüísticas sin acceso a su significado, y los riesgos de hacerlos cada vez más grandes. Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610-623. Consultar estudio (DOI)
- Por qué alucinan los modelos: las evaluaciones premian arriesgar una respuesta antes que reconocer que no se sabe. Kalai, A. T., Nachum, O., Vempala, S. S., & Zhang, E. (2025). Why language models hallucinate. arXiv, 2509.04664. Consultar estudio en arXiv
- El efecto lost in the middle: los modelos aprovechan peor la información situada en el centro de un texto largo. Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the middle: How language models use long contexts. Transactions of the Association for Computational Linguistics, 12, 157-173. Consultar artículo (DOI)
- La ventana de contexto real de un modelo suele ser mucho menor que la anunciada. Hsieh, C.-P., Sun, S., Kriman, S., Acharya, S., Rekesh, D., Jia, F., Zhang, Y., & Ginsburg, B. (2024). RULER: What’s the real context size of your long-context language models? arXiv, 2404.06654. Consultar estudio en arXiv
- Basta con cambiar las cifras de un problema de matemáticas, o añadirle una frase irrelevante, para que los modelos fallen mucho más. Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2025). GSM-Symbolic: Understanding the limitations of mathematical reasoning in large language models. International Conference on Learning Representations (ICLR). Consultar estudio en arXiv
- Cuándo se agotará el texto humano público disponible para entrenar modelos: entre 2026 y 2032, al ritmo actual. Villalobos, P., Ho, A., Sevilla, J., Besiroglu, T., Heim, L., & Hobbhahn, M. (2024). Position: Will we run out of data? Limits of LLM scaling based on human-generated data. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 49523-49544. Consultar estudio en arXiv
- El colapso del modelo: entrenar con datos generados por otros modelos borra los casos raros y degrada el resultado generación tras generación. Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631(8022), 755-759. Consultar artículo (DOI)
- El matiz: si los datos sintéticos se acumulan junto a los reales en lugar de sustituirlos, el colapso se evita. Gerstgrasser, M., Schaeffer, R., Dey, A., Rafailov, R., Sleight, H., … & Koyejo, S. (2024). Is model collapse inevitable? Breaking the curse of recursion by accumulating real and synthetic data. arXiv, 2404.01413. Consultar estudio en arXiv
- La arquitectura Transformer, cuyo mecanismo de atención tiene un coste que crece con el cuadrado de la longitud del texto. Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998-6008. Consultar estudio en arXiv
- Cuánta electricidad consumen los centros de datos y cuánto crecerá ese consumo con la IA. International Energy Agency. (2025). Energy and AI. IEA. Consultar informe de la IEA
- La huella hídrica de la IA: cuánta agua se evapora para refrigerar los servidores que entrenan y ejecutan los modelos. Li, P., Yang, J., Islam, M. A., & Ren, S. (2025). Making AI less ‘thirsty’. Communications of the ACM, 68(7), 54-61. Consultar artículo (DOI)
- La primera gran sentencia sobre entrenamiento y derechos de autor: uso legítimo con libros comprados, no con copias piratas. Tribunal de Distrito de los Estados Unidos para el Distrito Norte de California. (2025). Bartz v. Anthropic PBC, 787 F. Supp. 3d 1007. Consultar la sentencia
- El Reglamento europeo de inteligencia artificial, que obliga a los proveedores de modelos de uso general a resumir sus datos de entrenamiento y respetar los derechos de autor. Parlamento Europeo y Consejo de la Unión Europea. (2024). Reglamento (UE) 2024/1689, por el que se establecen normas armonizadas en materia de inteligencia artificial. Diario Oficial de la Unión Europea, L 2024/1689. Consultar el texto en EUR-Lex
- Los sesgos humanos quedan grabados en las representaciones que los modelos aprenden del lenguaje. Caliskan, A., Bryson, J. J., & Narayanan, A. (2017). Semantics derived automatically from language corpora contain human-like biases. Science, 356(6334), 183-186. Consultar artículo (DOI)
- Racismo encubierto: los modelos juzgan peor a quien escribe en inglés afroamericano, aunque digan no tener prejuicios. Hofmann, V., Kalluri, P. R., Jurafsky, D., & King, S. (2024). AI generates covertly racist decisions about people based on their dialect. Nature, 633(8028), 147-154. Consultar artículo (DOI)
Estamos preparando el espacio para que puedas comentar los artículos.
Sigue leyendo
El corazón en la piel
Cómo la radiación ultravioleta libera el óxido nítrico de la piel para regular la presión arterial y combatir el riesgo cardiovascular
Efecto Zeigarnik o el coste de tener ideas brillantes
El fenómeno psicológico que sabotea tu descanso en nombre de la creatividad
Agua estructurada: el terreno de la salud
La batería líquida de tus células y cómo protegerla del entorno moderno