El taller del creador
Modelos, herramientas y las llaves que permiten a la inteligencia artificial conectarse con el mundo real
En la cultura popular ha calado un fenómeno de metonimia tecnológica parecido al que ocurrió en su día con marcas como Kleenex o Danone: usamos el nombre de un producto comercial para referirnos a toda una disciplina científica. Para la mayoría de los usuarios, «ChatGPT» es sinónimo de inteligencia artificial, del mismo modo que «kleenex» sustituyó en el vocabulario cotidiano al pañuelo de papel.
En el ecosistema tecnológico actual es fundamental separar el modelo fundacional (la inteligencia matemática que procesa patrones) de la aplicación comercial (la interfaz amigable diseñada para el gran público). Comprender esta distinción no es un capricho académico: es el primer paso para recuperar el control sobre nuestros datos, entender cómo actúan las herramientas y saber qué ocurre realmente detrás de la pantalla.
Anatomía de una aplicación de IA
Para entender cómo funciona el ecosistema moderno de la IA, hay que distinguir dos conceptos que la mercadotecnia suele fundir en uno solo: el modelo y la herramienta (o interfaz).
El modelo
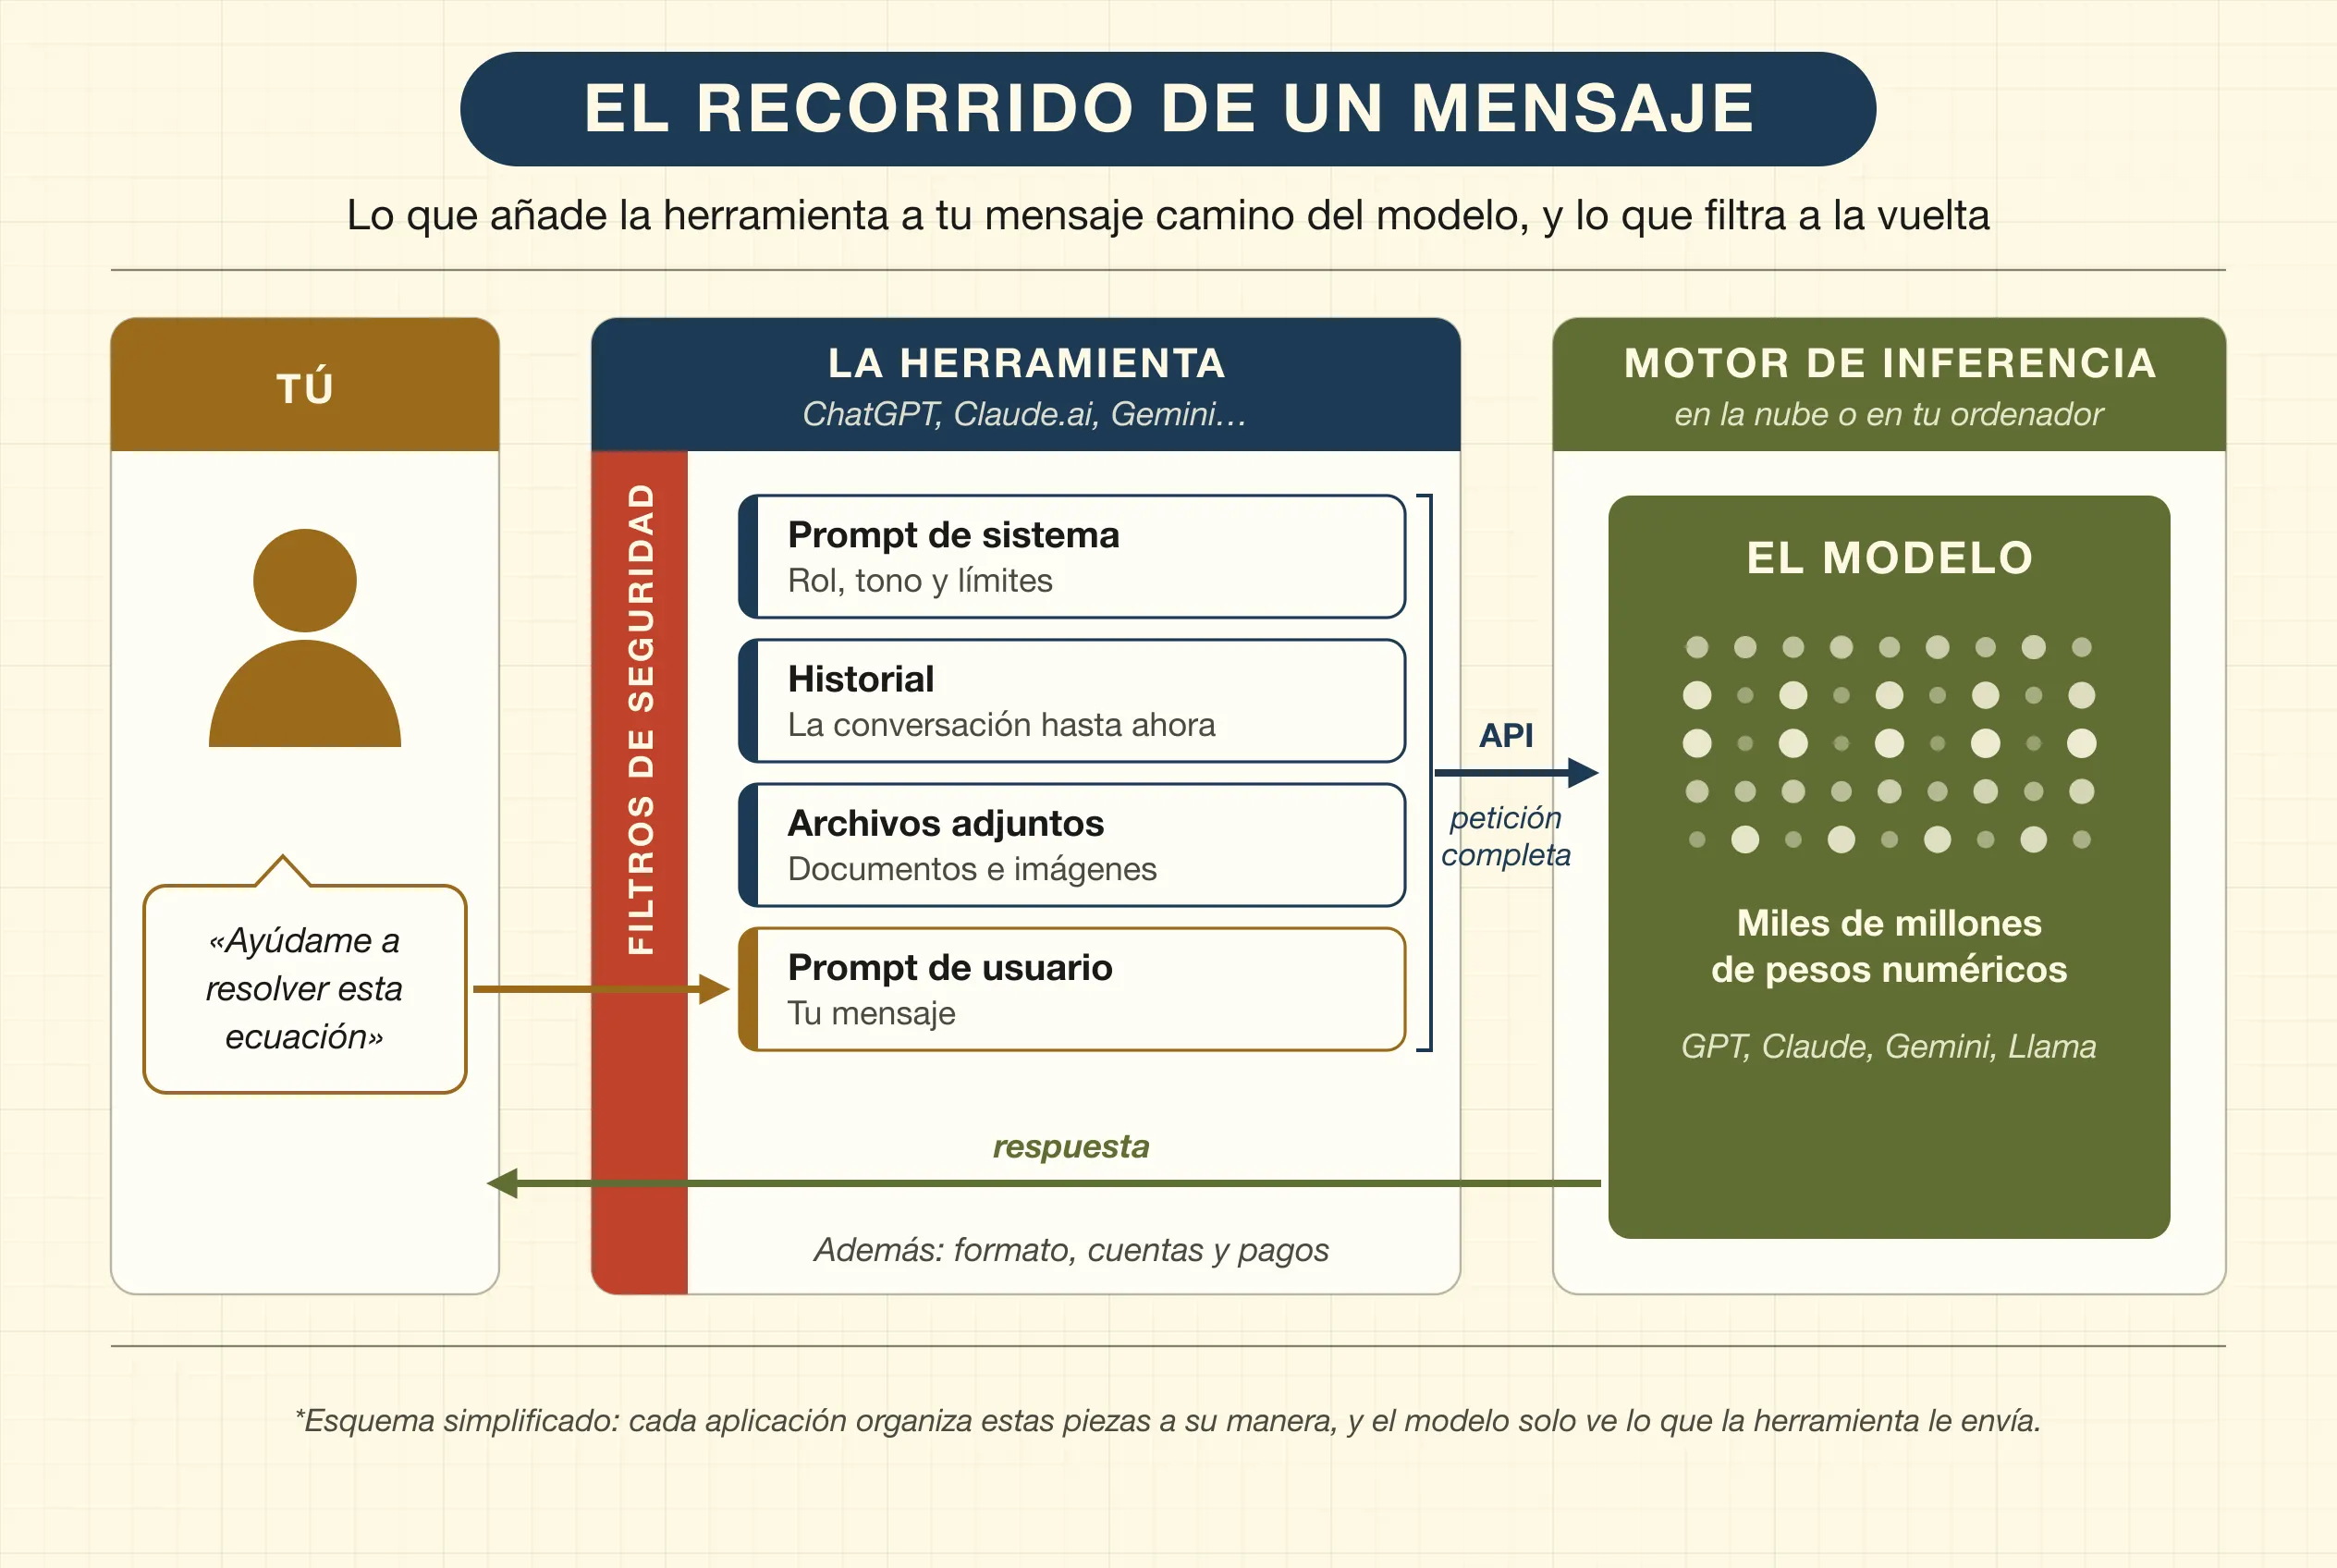
Es el núcleo matemático: miles de millones de parámetros numéricos (los pesos sinápticos) ajustados durante meses en supercomputadores. Por sí solo, un archivo de pesos es como un archivo comprimido lleno de estática organizada: no tiene botones, ni barra de chat, ni historial, ni los filtros de moderación que añaden las aplicaciones, aunque sí conserva el comportamiento que aprendió durante su entrenamiento, como negarse a ciertas peticiones. Para utilizarlo hace falta un motor de inferencia que lo ejecute y, normalmente, una interfaz de programación (API) a través de la cual otras aplicaciones le envían peticiones y reciben sus respuestas.
- Ejemplos de modelos son GPT-6.1 Terra, Claude Opus 5.5, Gemini 4 Carbon o Llama 4.
La herramienta
Son las aplicaciones que traducen nuestras pulsaciones de teclado en peticiones comprensibles para el modelo y presentan su respuesta como texto formateado, botones o gráficos agradables a la vista.
Esta capa de software se encarga de formatear el texto, guardar el historial de nuestras conversaciones, permitir la subida de archivos adjuntos, gestionar los pagos y, muy especialmente, aplicar los filtros de seguridad y moderación antes y después de que el modelo genere una respuesta.
- Ejemplos de herramientas son el portal web de ChatGPT, la aplicación Claude.ai o la interfaz de Gemini. El propio nombre lo delata: ChatGPT es la herramienta, y GPT, la familia de modelos que funciona por dentro.
El ciclo de vida de un modelo
Antes de poder integrarse en una aplicación, un modelo atraviesa un proceso riguroso en tres fases fundamentales:
-
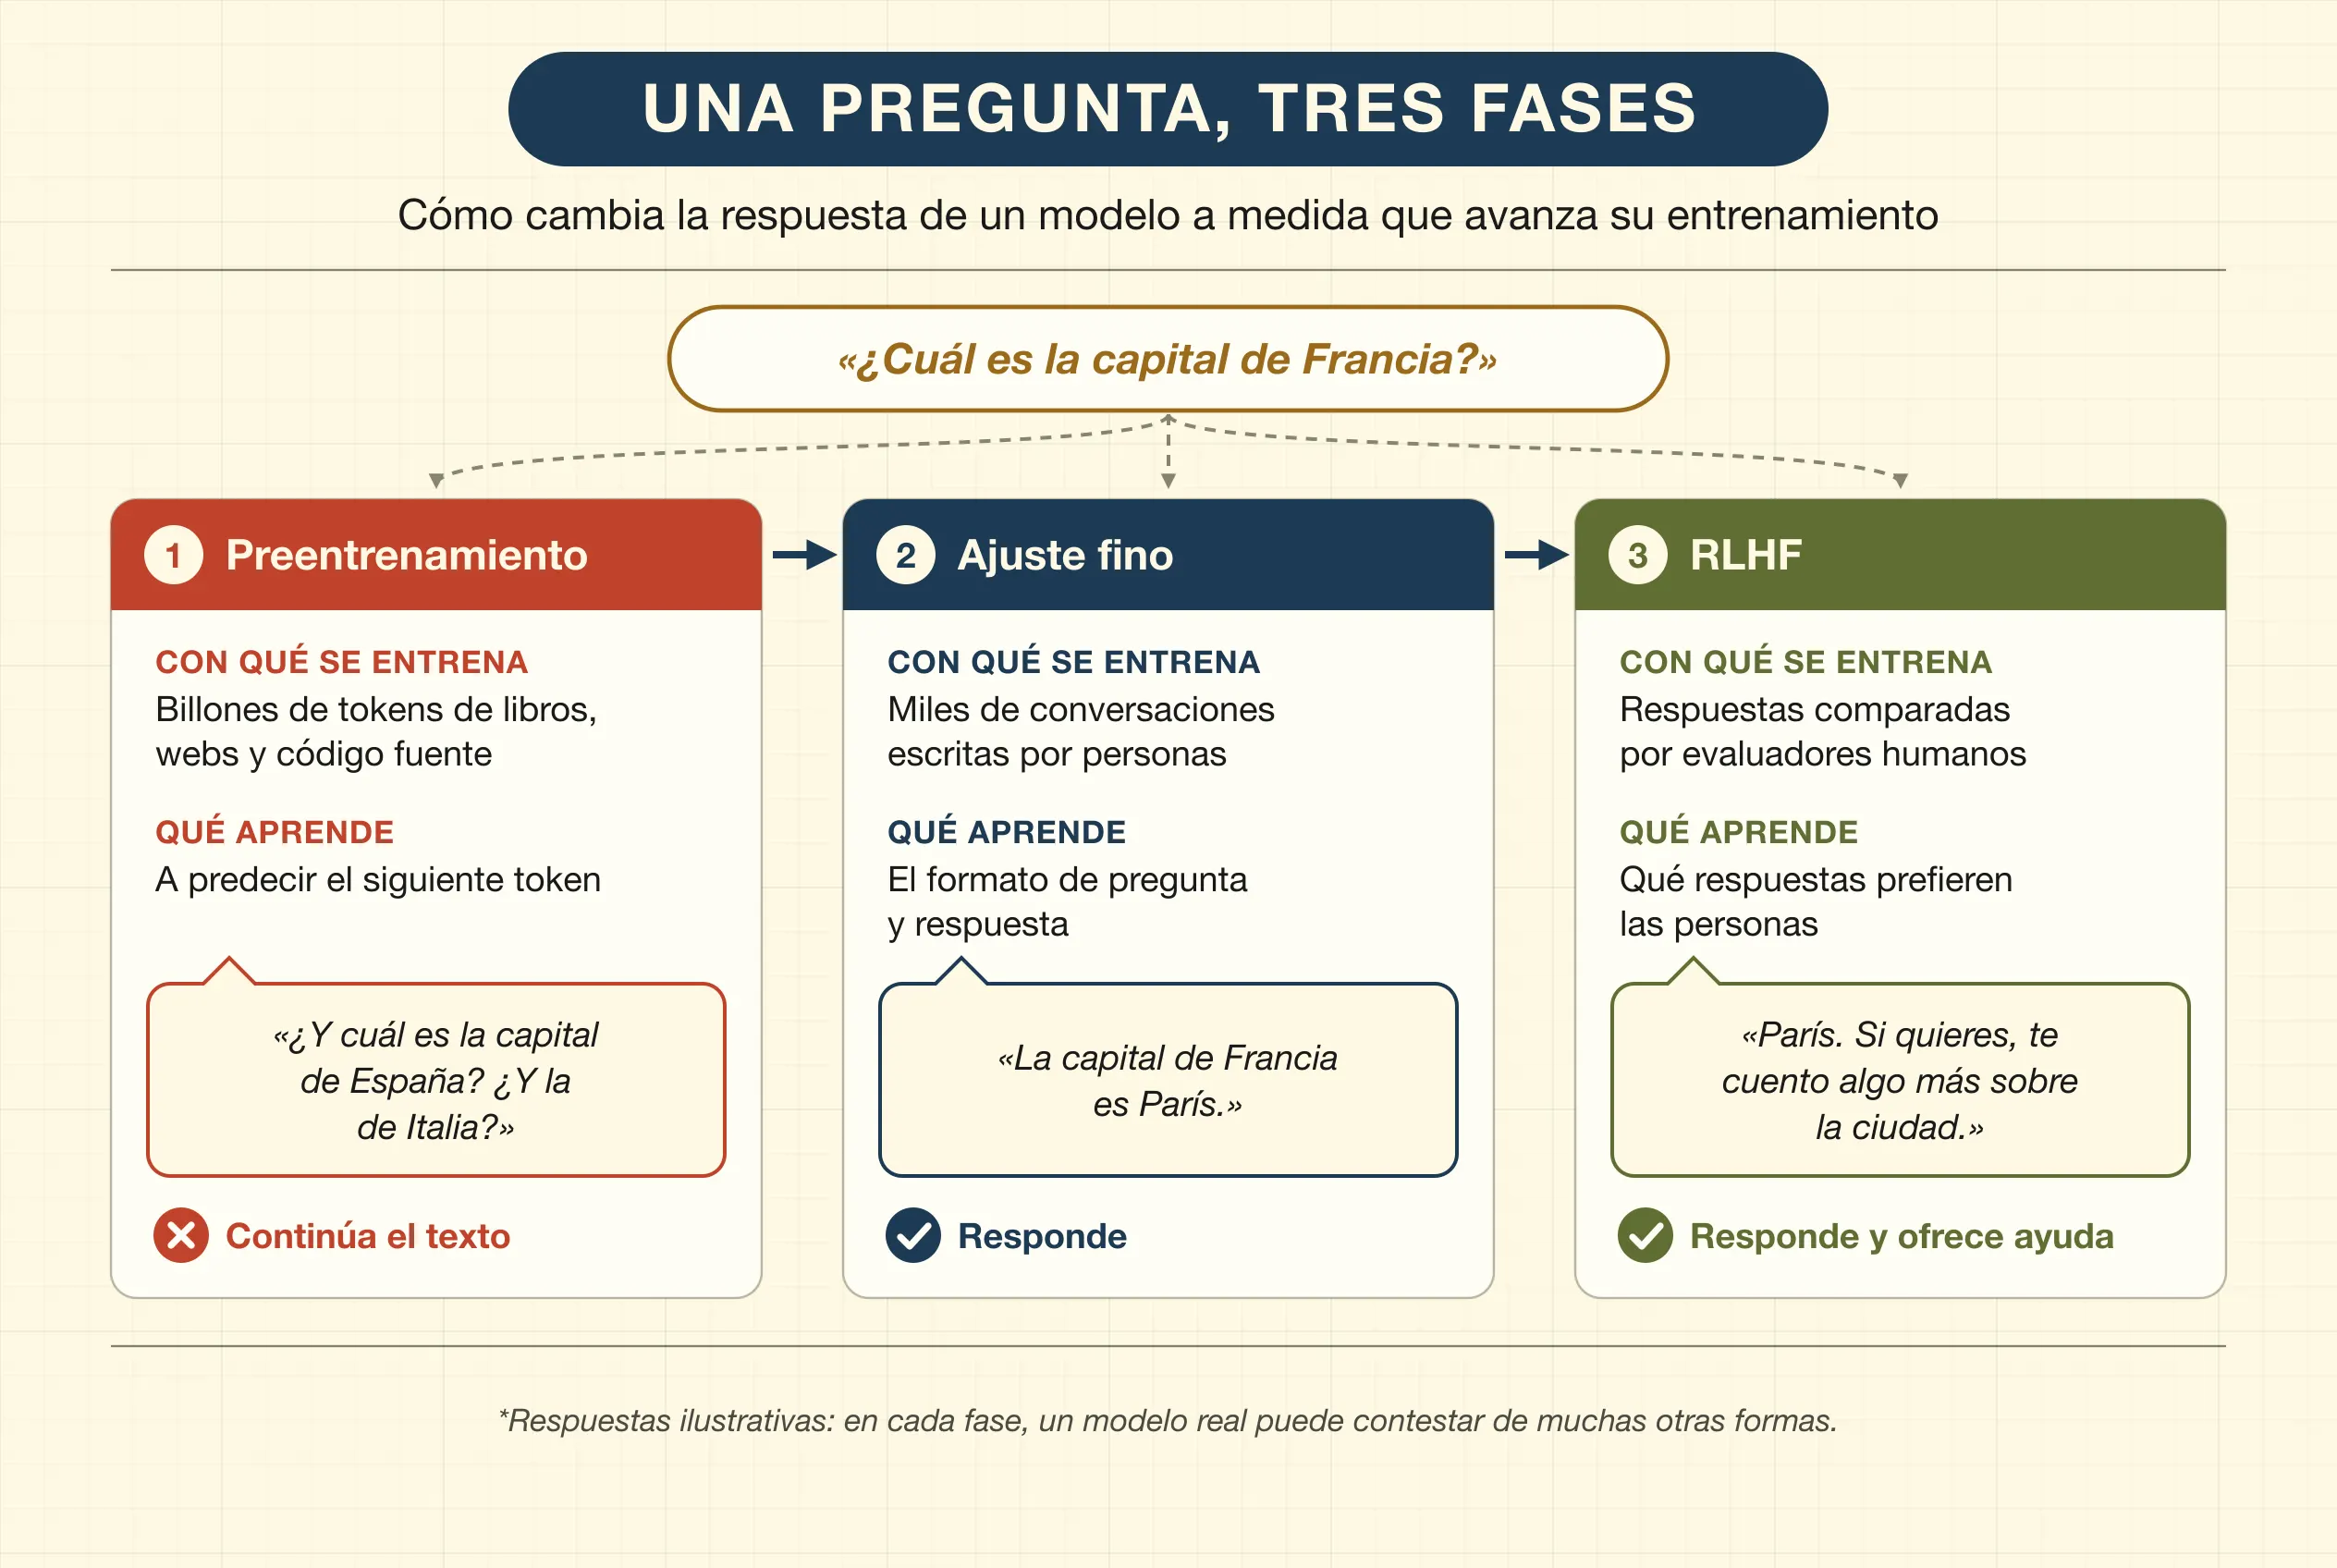
Preentrenamiento: el modelo «lee» internet de forma masiva, con sus libros, artículos y código fuente. Aquí adquiere su comprensión general del lenguaje y del mundo a base de predecir el siguiente token. El proceso requiere supercomputadores durante meses y tiene costes millonarios.
Al terminar esta fase, el modelo es un «completador de textos» puro: si le preguntas «¿Cuál es la capital de Francia?», puede que no responda «París», sino que siga escribiendo «¿Y cuál es la capital de España?», porque ha aprendido a imitar la estructura de lo que lee, y en una lista de ejercicios una pregunta suele ir seguida de otra.
-
Ajuste fino supervisado (fine-tuning): se entrena al modelo con miles de ejemplos de conversaciones escritas y revisadas por personas, que le enseñan a adoptar un formato de pregunta y respuesta útil y seguro. Con el mismo procedimiento se le pueden dar capacidades específicas en un ámbito concreto, como la medicina, el derecho o la programación.
-
RLHF (Reinforcement Learning from Human Feedback): aprendizaje por refuerzo a partir de preferencias humanas. Unos evaluadores comparan varias respuestas del modelo y eligen las mejores; con esas elecciones se le premia o se le penaliza según la utilidad y la veracidad de lo que dice, lo que moldea su tono definitivo.
En los modelos más recientes se suma una etapa más de aprendizaje por refuerzo, esta vez con problemas cuya solución puede comprobarse automáticamente, como los de matemáticas o programación. Es lo que enseña a los llamados modelos de razonamiento a «pensar» paso a paso antes de responder.
Prompts y multimodalidad nativa
En la divulgación reciente se ha popularizado el término prompt como la simple pregunta que un usuario teclea en la caja de chat. Sin embargo, en la arquitectura de software real existe una distinción crucial entre dos tipos de instrucciones.
Prompt de sistema
Es el conjunto de reglas invisibles que los desarrolladores de la herramienta introducen antes de que el usuario escriba una sola letra. El prompt de sistema (system prompt) fija el marco de actuación, el rol, el tono y los límites de la IA.
- Por ejemplo, un prompt de sistema puede dictar: «Actúas como un tutor de matemáticas para niños de 10 años. Nunca des la respuesta directa; explica los conceptos paso a paso con metáforas sencillas y mantén siempre un tono alentador y paciente».
Prompt de usuario
Es la entrada directa del usuario («Ayúdame a resolver esta ecuación de primer grado»). El modelo procesa el prompt de usuario (user prompt) siempre a través de la lente y las restricciones que ha fijado antes el prompt de sistema.
Los modelos se entrenan para dar prioridad a las instrucciones del sistema, pero esa jerarquía no es infalible: un usuario hábil, o un texto malicioso escondido en una página web o en un documento que el modelo lee, puede llegar a saltársela. Es lo que se conoce como inyección de instrucciones (prompt injection).
Multimodalidad nativa
Durante años, para que una IA analizara una imagen, un sistema visual independiente la describía con palabras y después enviaba esa descripción al modelo de lenguaje. Hoy los modelos más avanzados son multimodales de forma nativa: se entrenan desde el principio con texto, imágenes, audio y vídeo, que procesan y relacionan entre sí dentro del mismo espacio vectorial, sin necesidad de traductores intermedios.
Las «manos» del modelo
Un modelo de lenguaje puro está confinado en una caja de arena (sandbox): solo puede predecir texto basándose en su memoria estática de entrenamiento. Para ser verdaderamente útil en el mundo real, necesita extensiones que actúen como sus extremidades y sus sentidos.
Uso de herramientas
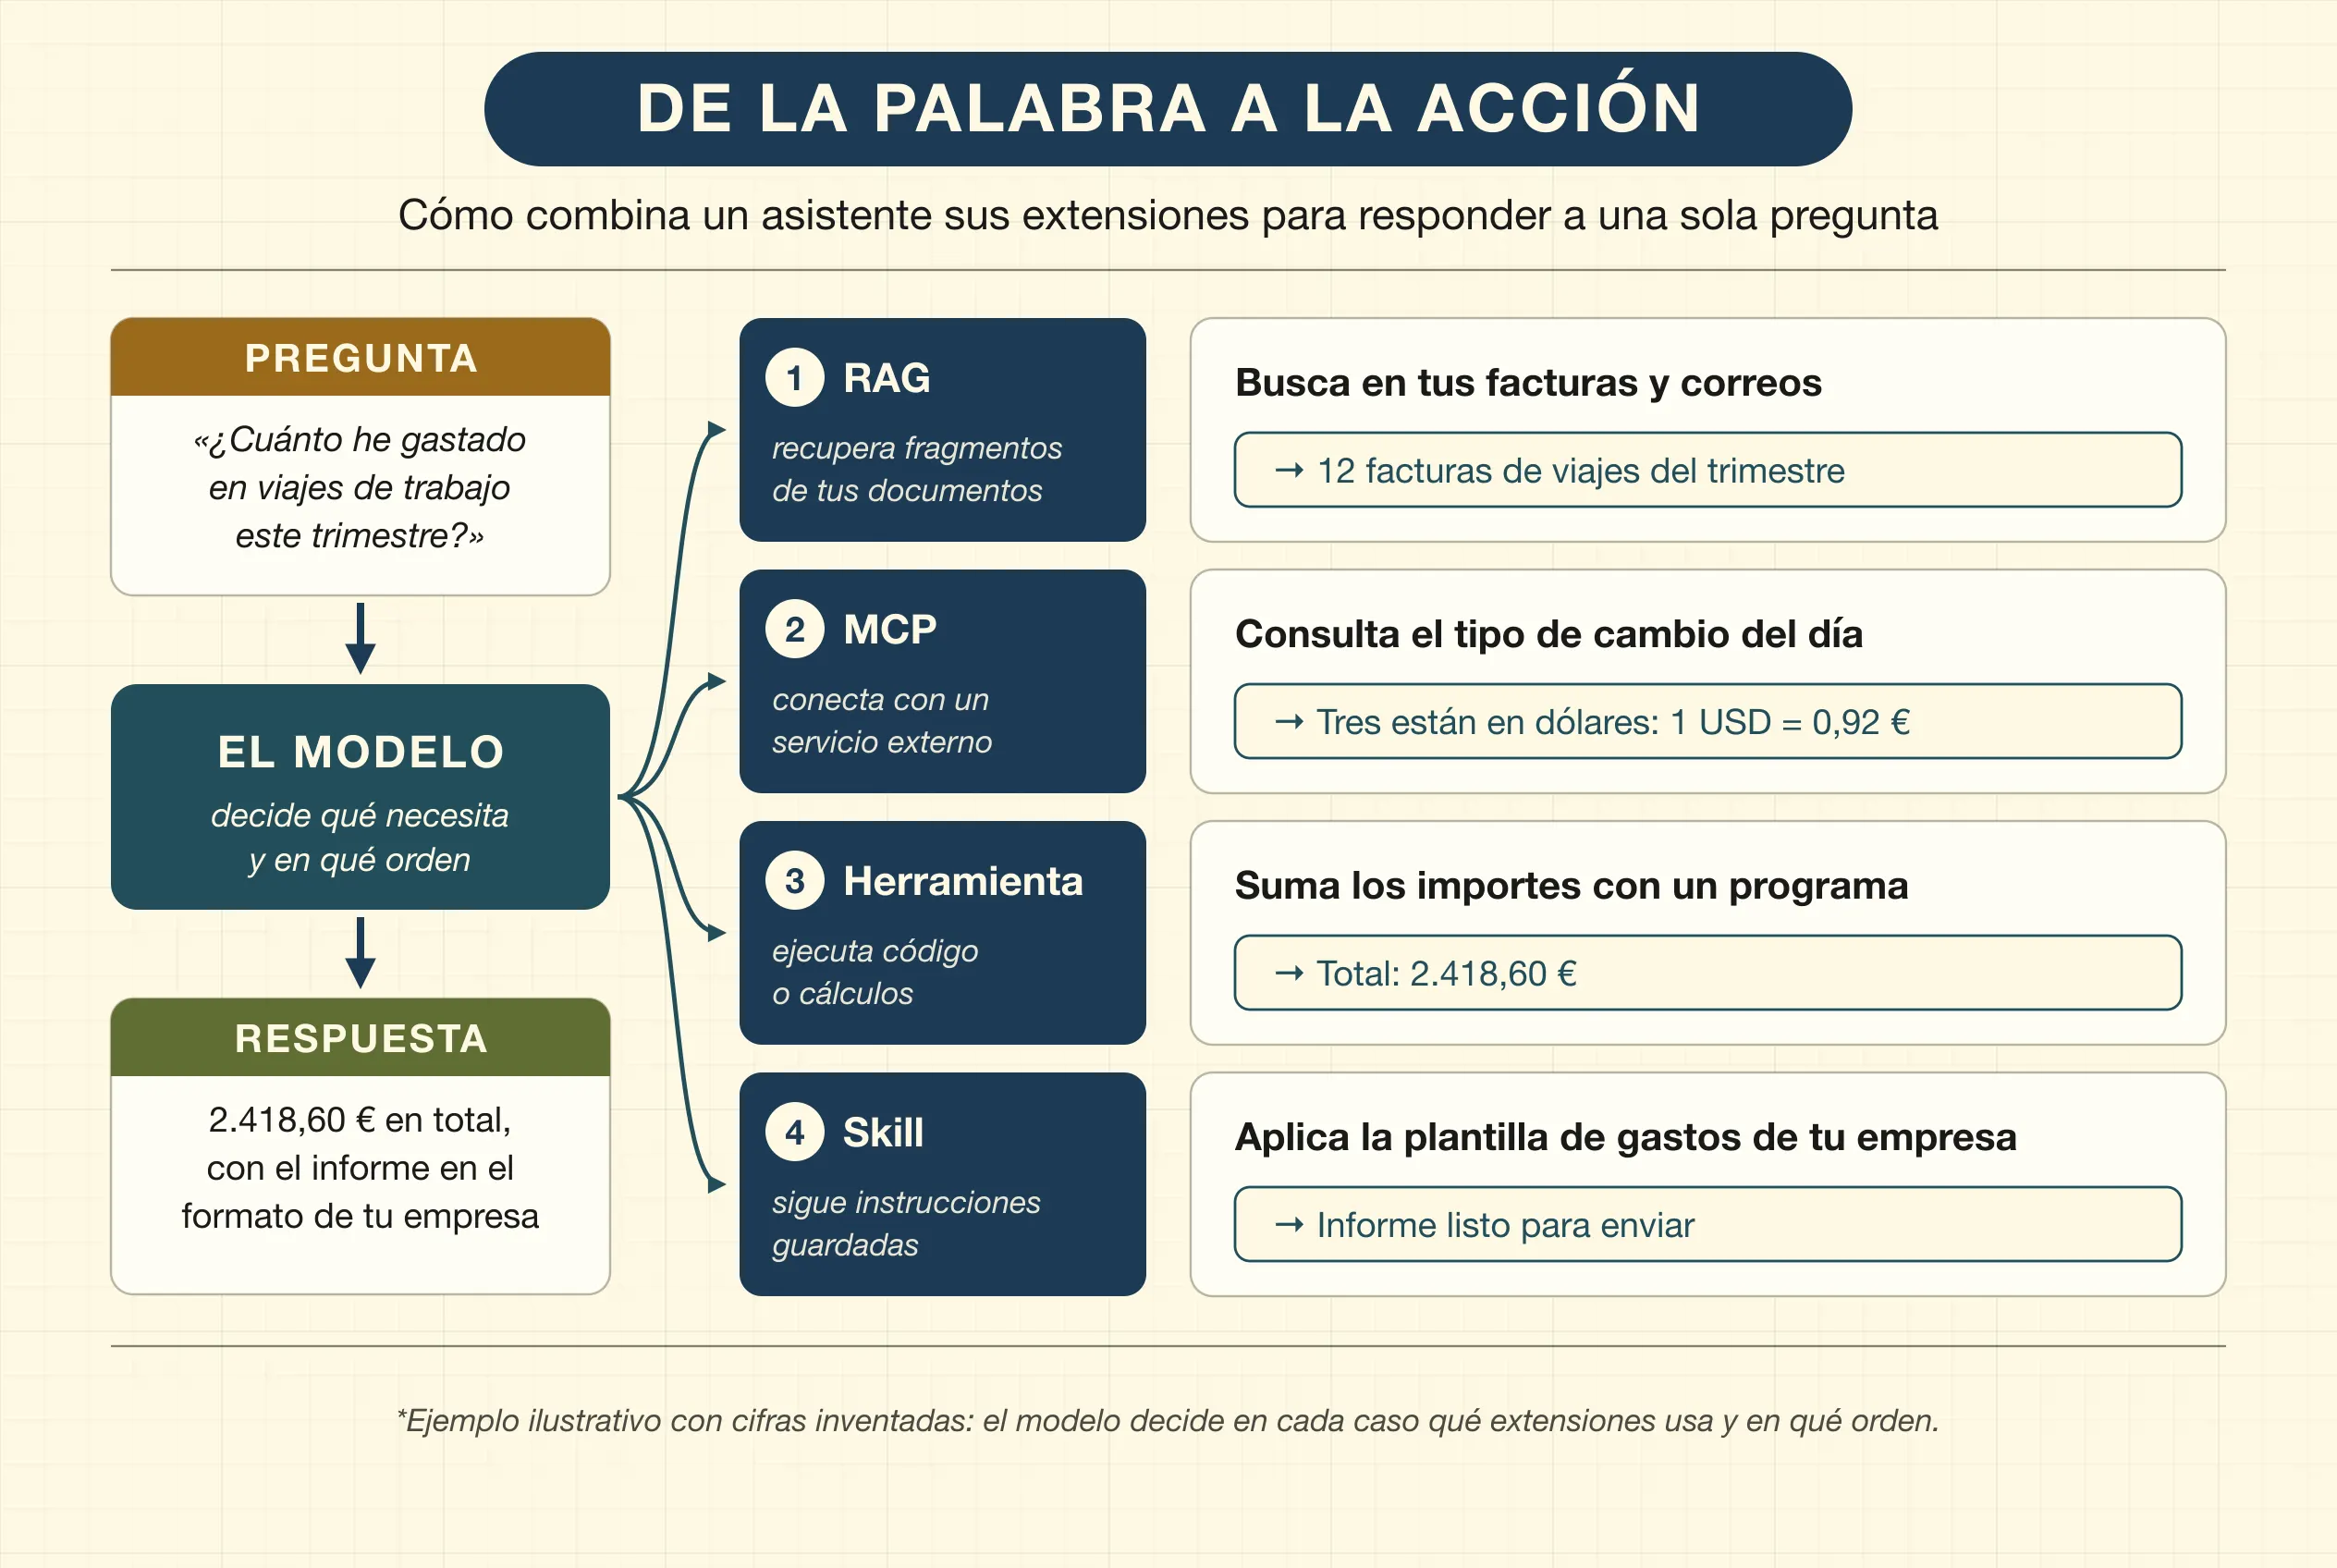
La pieza básica es la capacidad del modelo de reconocer cuándo una tarea queda fuera de su alcance. Si le pides multiplicar dos números de 15 dígitos o conocer las noticias de última hora, un modelo bien entrenado sabe que su cálculo probabilístico puede fallar o que carece del dato. En lugar de inventarlo, emite una petición estructurada para invocar una función externa: la aplicación abre una calculadora, ejecuta un programa en Python o hace una búsqueda web, le devuelve el resultado y el modelo lo usa para darte la respuesta correcta.
No siempre acierta al decidir cuándo necesita ayuda, pero esta capacidad, conocida en inglés como tool use o function calling, es la base de todo lo que sigue.
Skills
Una skill (o habilidad) es un conjunto estructurado de instrucciones, reglas, ejemplos y recursos que se le proporciona a un agente de IA para que sepa exactamente cómo ejecutar una tarea concreta. Puede incluir instrucciones paso a paso, buenas prácticas, restricciones, ejemplos de código, plantillas corporativas o programas auxiliares.
Son especialmente útiles para tareas repetitivas, complejas o de varios pasos que exigen seguir un formato, un tono o un procedimiento muy específico. Funcionan como un manual de instrucciones o una receta que la IA consulta cuando necesita realizar un trabajo determinado, lo que evita tener que escribir un prompt extenso cada vez.
El formato lo presentó Anthropic en octubre de 2025 y hoy es un estándar abierto. Cada skill es una carpeta con un archivo de instrucciones, y el agente solo lee su nombre y su descripción hasta que una tarea la necesita; entonces carga el resto.
MCP (Model Context Protocol)
Un modelo de lenguaje por sí solo es un cerebro aislado en una habitación a oscuras: sabe mucho sobre el pasado, pero no puede ver la hora actual, no sabe qué tiempo hace fuera y no puede consultar tus documentos privados. Para resolverlo, la ingeniería ha dotado a los modelos de la capacidad de interactuar con herramientas y fuentes de datos del «mundo exterior» a través de conectores MCP.
Presentado por Anthropic a finales de 2024 y adoptado después por OpenAI, Google y Microsoft, el Model Context Protocol (MCP) estandariza la conexión entre los modelos de IA y las fuentes de datos locales o corporativas. Actúa como un puerto USB universal: define un protocolo común para que cualquier modelo pueda conectarse en ambos sentidos a bases de datos, herramientas empresariales o programas concretos, como Figma, Slack o Notion. Desde finales de 2025 lo gestiona una fundación independiente, dentro de la Linux Foundation.
A través de un conector MCP, un modelo puede, por ejemplo, consultar un servicio meteorológico para saber qué tiempo hace ahora. Sin este tipo de herramientas le sería imposible saberlo, porque esa información no estaba en sus datos de entrenamiento. La contrapartida es que cada conector abre una puerta: uno malicioso o mal configurado puede filtrar datos o colarle instrucciones al modelo, así que conviene instalar solo los de fuentes de confianza.
RAG (Retrieval-Augmented Generation)
La generación aumentada por recuperación es la técnica preferida por las empresas para que la IA trabaje sobre su documentación privada sin gastar millones en reentrenar el modelo. En lugar de hacer que el modelo aprenda la información de memoria, el sistema RAG funciona como un examen con el libro abierto: cuando el usuario hace una pregunta, la herramienta busca en milisegundos los párrafos más relevantes de los documentos (comparando su significado gracias a los embeddings que vimos en la primera parte), los adjunta de forma invisible al prompt y le pide al modelo que redacte la respuesta basándose exclusivamente en esos fragmentos.
Así se reducen mucho las invenciones, aunque no desaparecen del todo: si la búsqueda trae el párrafo equivocado, el modelo responderá con la misma seguridad.
Ejecución local y modelos de pesos abiertos
Hasta hace poco, usar la inteligencia artificial obligaba a pasar por los servidores de las grandes tecnológicas, lo que implicaba enviar datos privados a la nube. Hoy la optimización del software ha abierto la puerta a la soberanía del dato: ejecutar modelos potentes directamente en nuestro propio ordenador, completamente desconectado de internet. Es lo que permiten los modelos de pesos abiertos que vimos en la segunda parte.
¿Por qué ejecutar en local?
- Privacidad absoluta: tus documentos, datos financieros o textos creativos nunca salen de tu disco duro.
- Sin intermediarios ni suscripciones: decides tú las reglas de uso y no dependes de tarifas mensuales, de cambios en las condiciones de servicio ni de caídas de servidores.
- Trabajo sin conexión: capacidad de procesamiento completa en zonas sin cobertura o en entornos de alta seguridad.
El precio es que los modelos que caben en un ordenador doméstico siguen por detrás de los grandes modelos cerrados de la nube, sobre todo en las tareas más complejas.
Cuantización
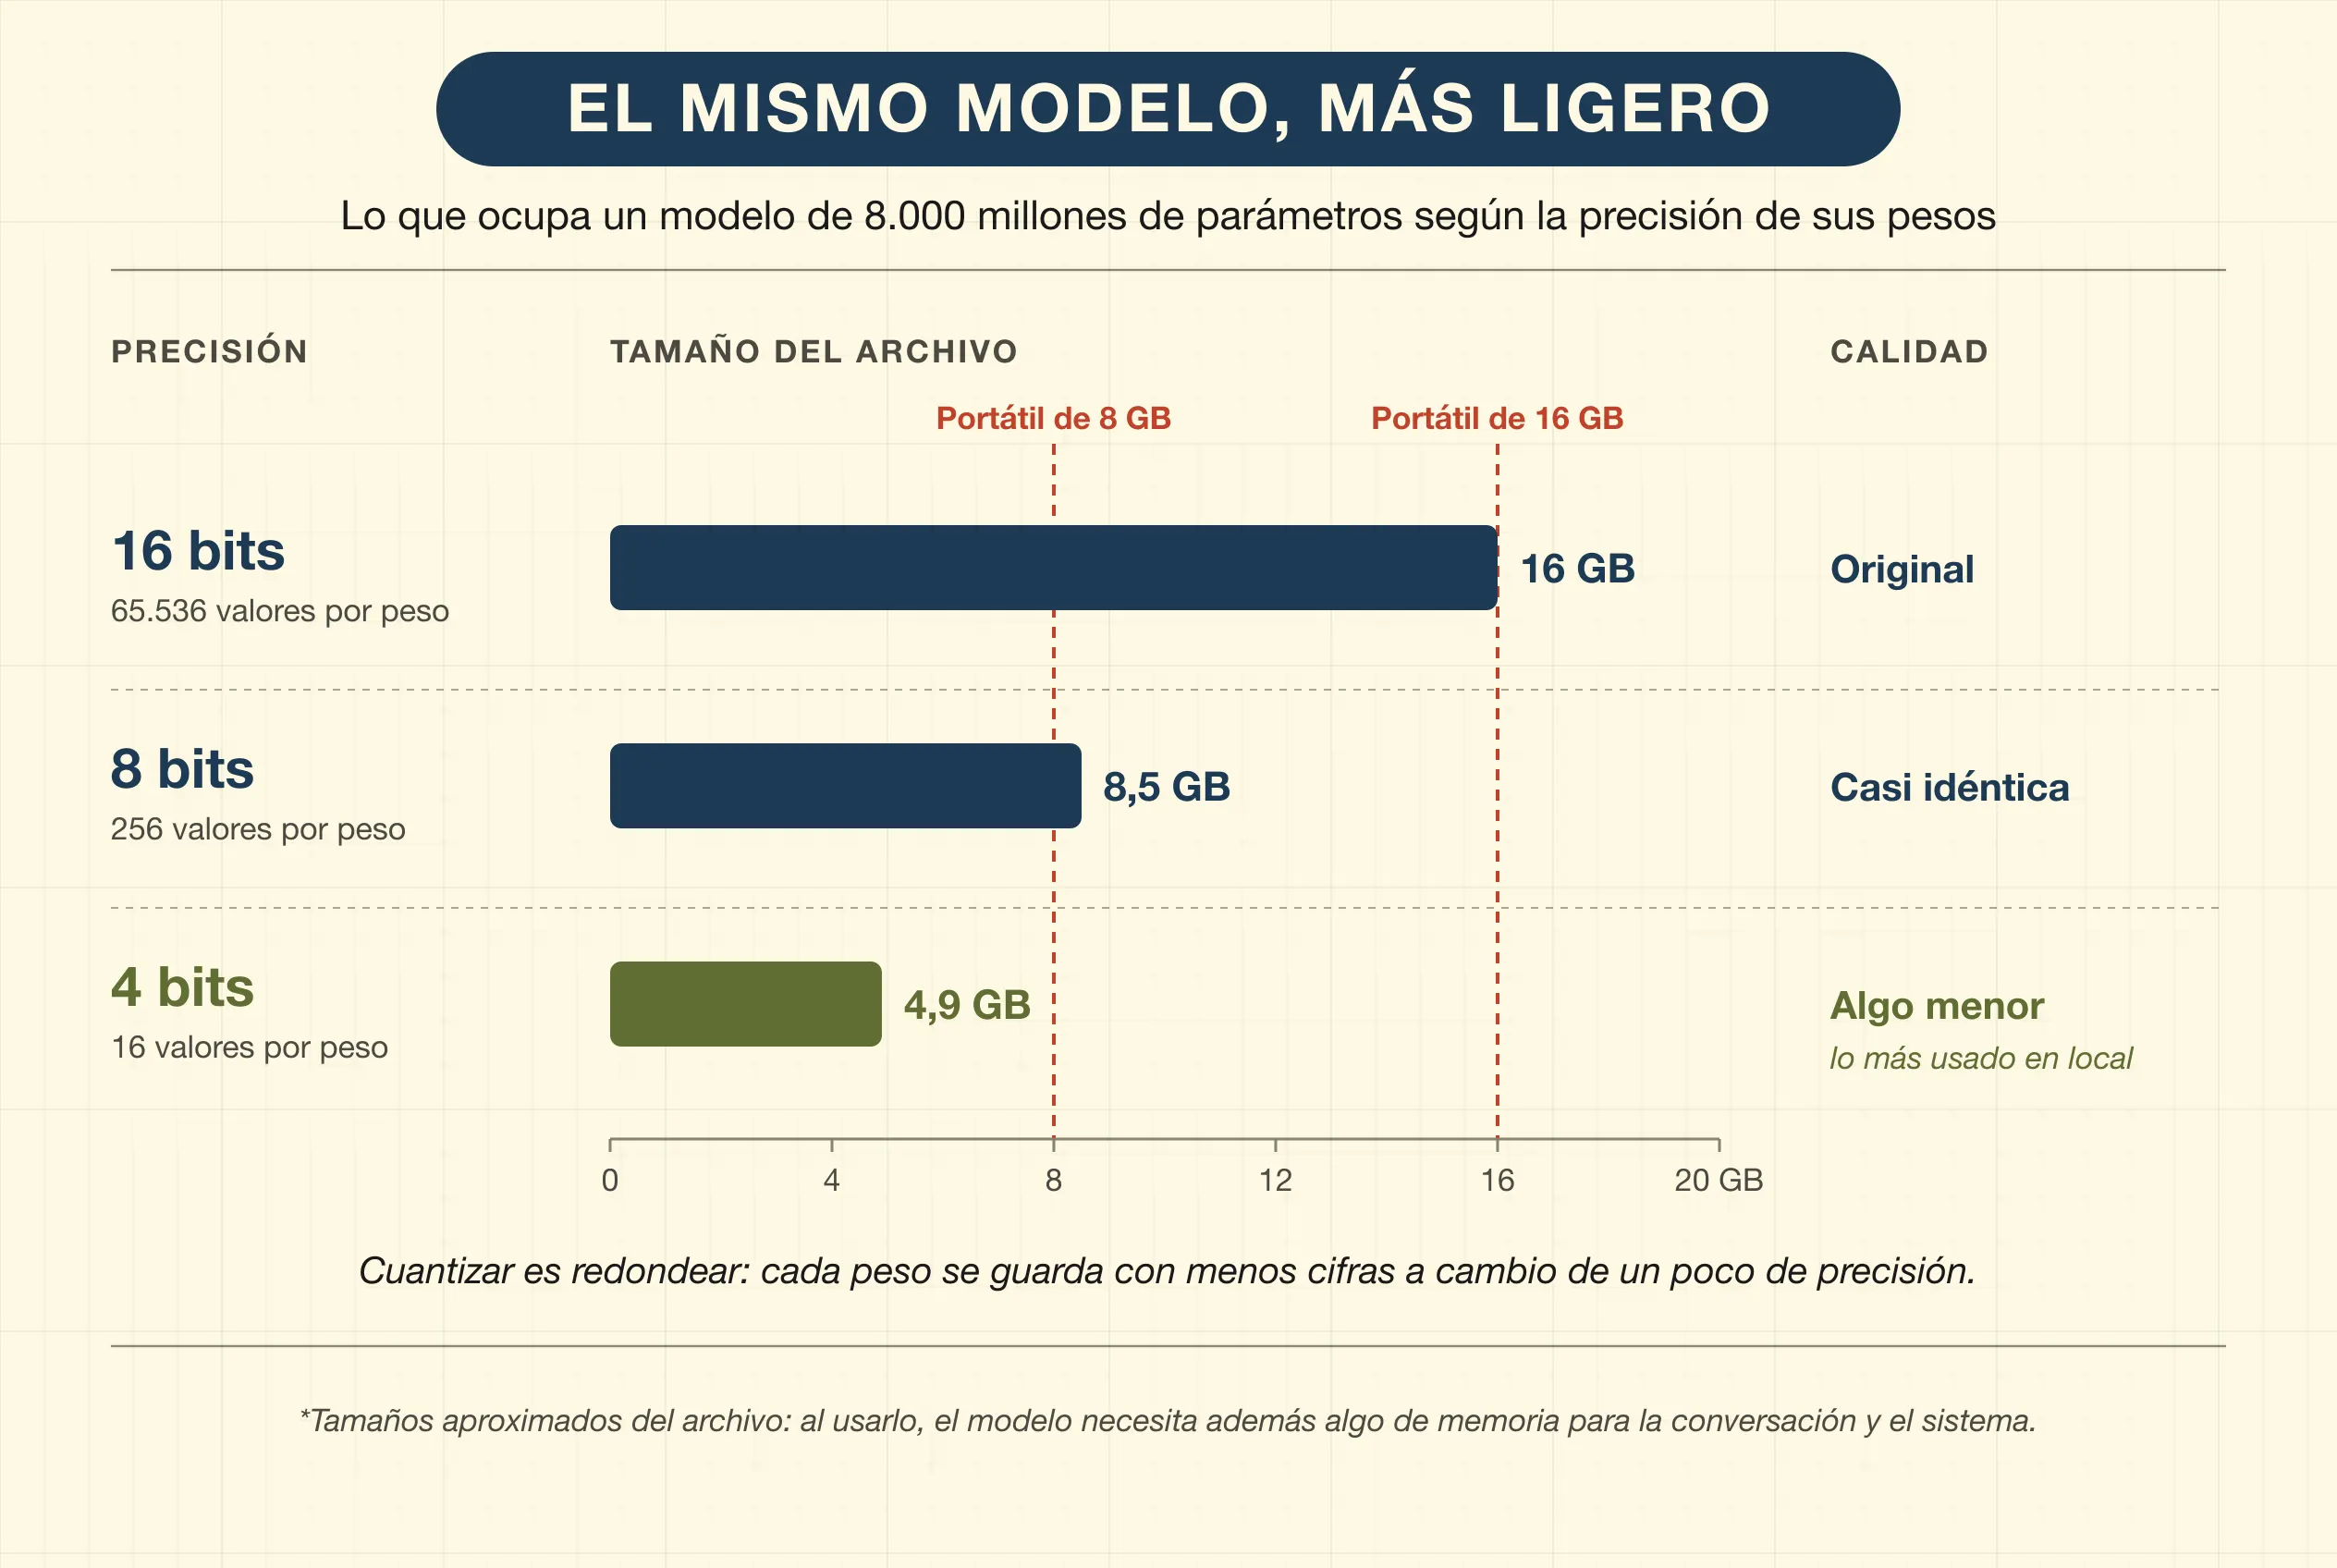
Los modelos originales pesan decenas o cientos de gigabytes y requieren granjas de tarjetas gráficas profesionales. Sin embargo, mediante un proceso matemático llamado cuantización, que reduce la precisión numérica de los pesos (por ejemplo, sustituyendo números decimales de 16 bits por enteros de 4 bits), es posible comprimir un modelo en un formato eficiente, como GGUF. Un modelo de 8.000 millones de parámetros, que ocupa unos 16 GB en su forma original, se queda así en unos 5 GB, con una pérdida de calidad pequeña. Gracias a ello, un portátil de gama media con una tarjeta gráfica decente, o con suficiente memoria compartida, puede ejecutar con soltura modelos muy competentes.
Herramientas de inferencia local
Aplicaciones como Ollama, LM Studio o Jan permiten descargar, gestionar y ejecutar modelos de pesos abiertos con un par de clics, y ofrecen una interfaz de chat privada que funciona sin conexión a internet. Por dentro, muchas se apoyan en el mismo motor de código abierto, llama.cpp, el proyecto que creó el formato GGUF.
- Ollama: nació como herramienta de línea de comandos y se ha convertido en una de las formas más populares de descargar y ejecutar modelos abiertos (Llama, Mistral, Qwen, DeepSeek) con un solo comando. Desde 2025 tiene también aplicación de escritorio.
- LM Studio y Jan: aplicaciones de escritorio con una interfaz gráfica cuidada, tan intuitiva como la de ChatGPT, que permiten chatear con modelos locales sin ninguna conexión.
El arsenal creativo y productivo
La caja de herramientas del creador moderno va mucho más allá de las respuestas de texto y abarca un repertorio multimedia sin precedentes:
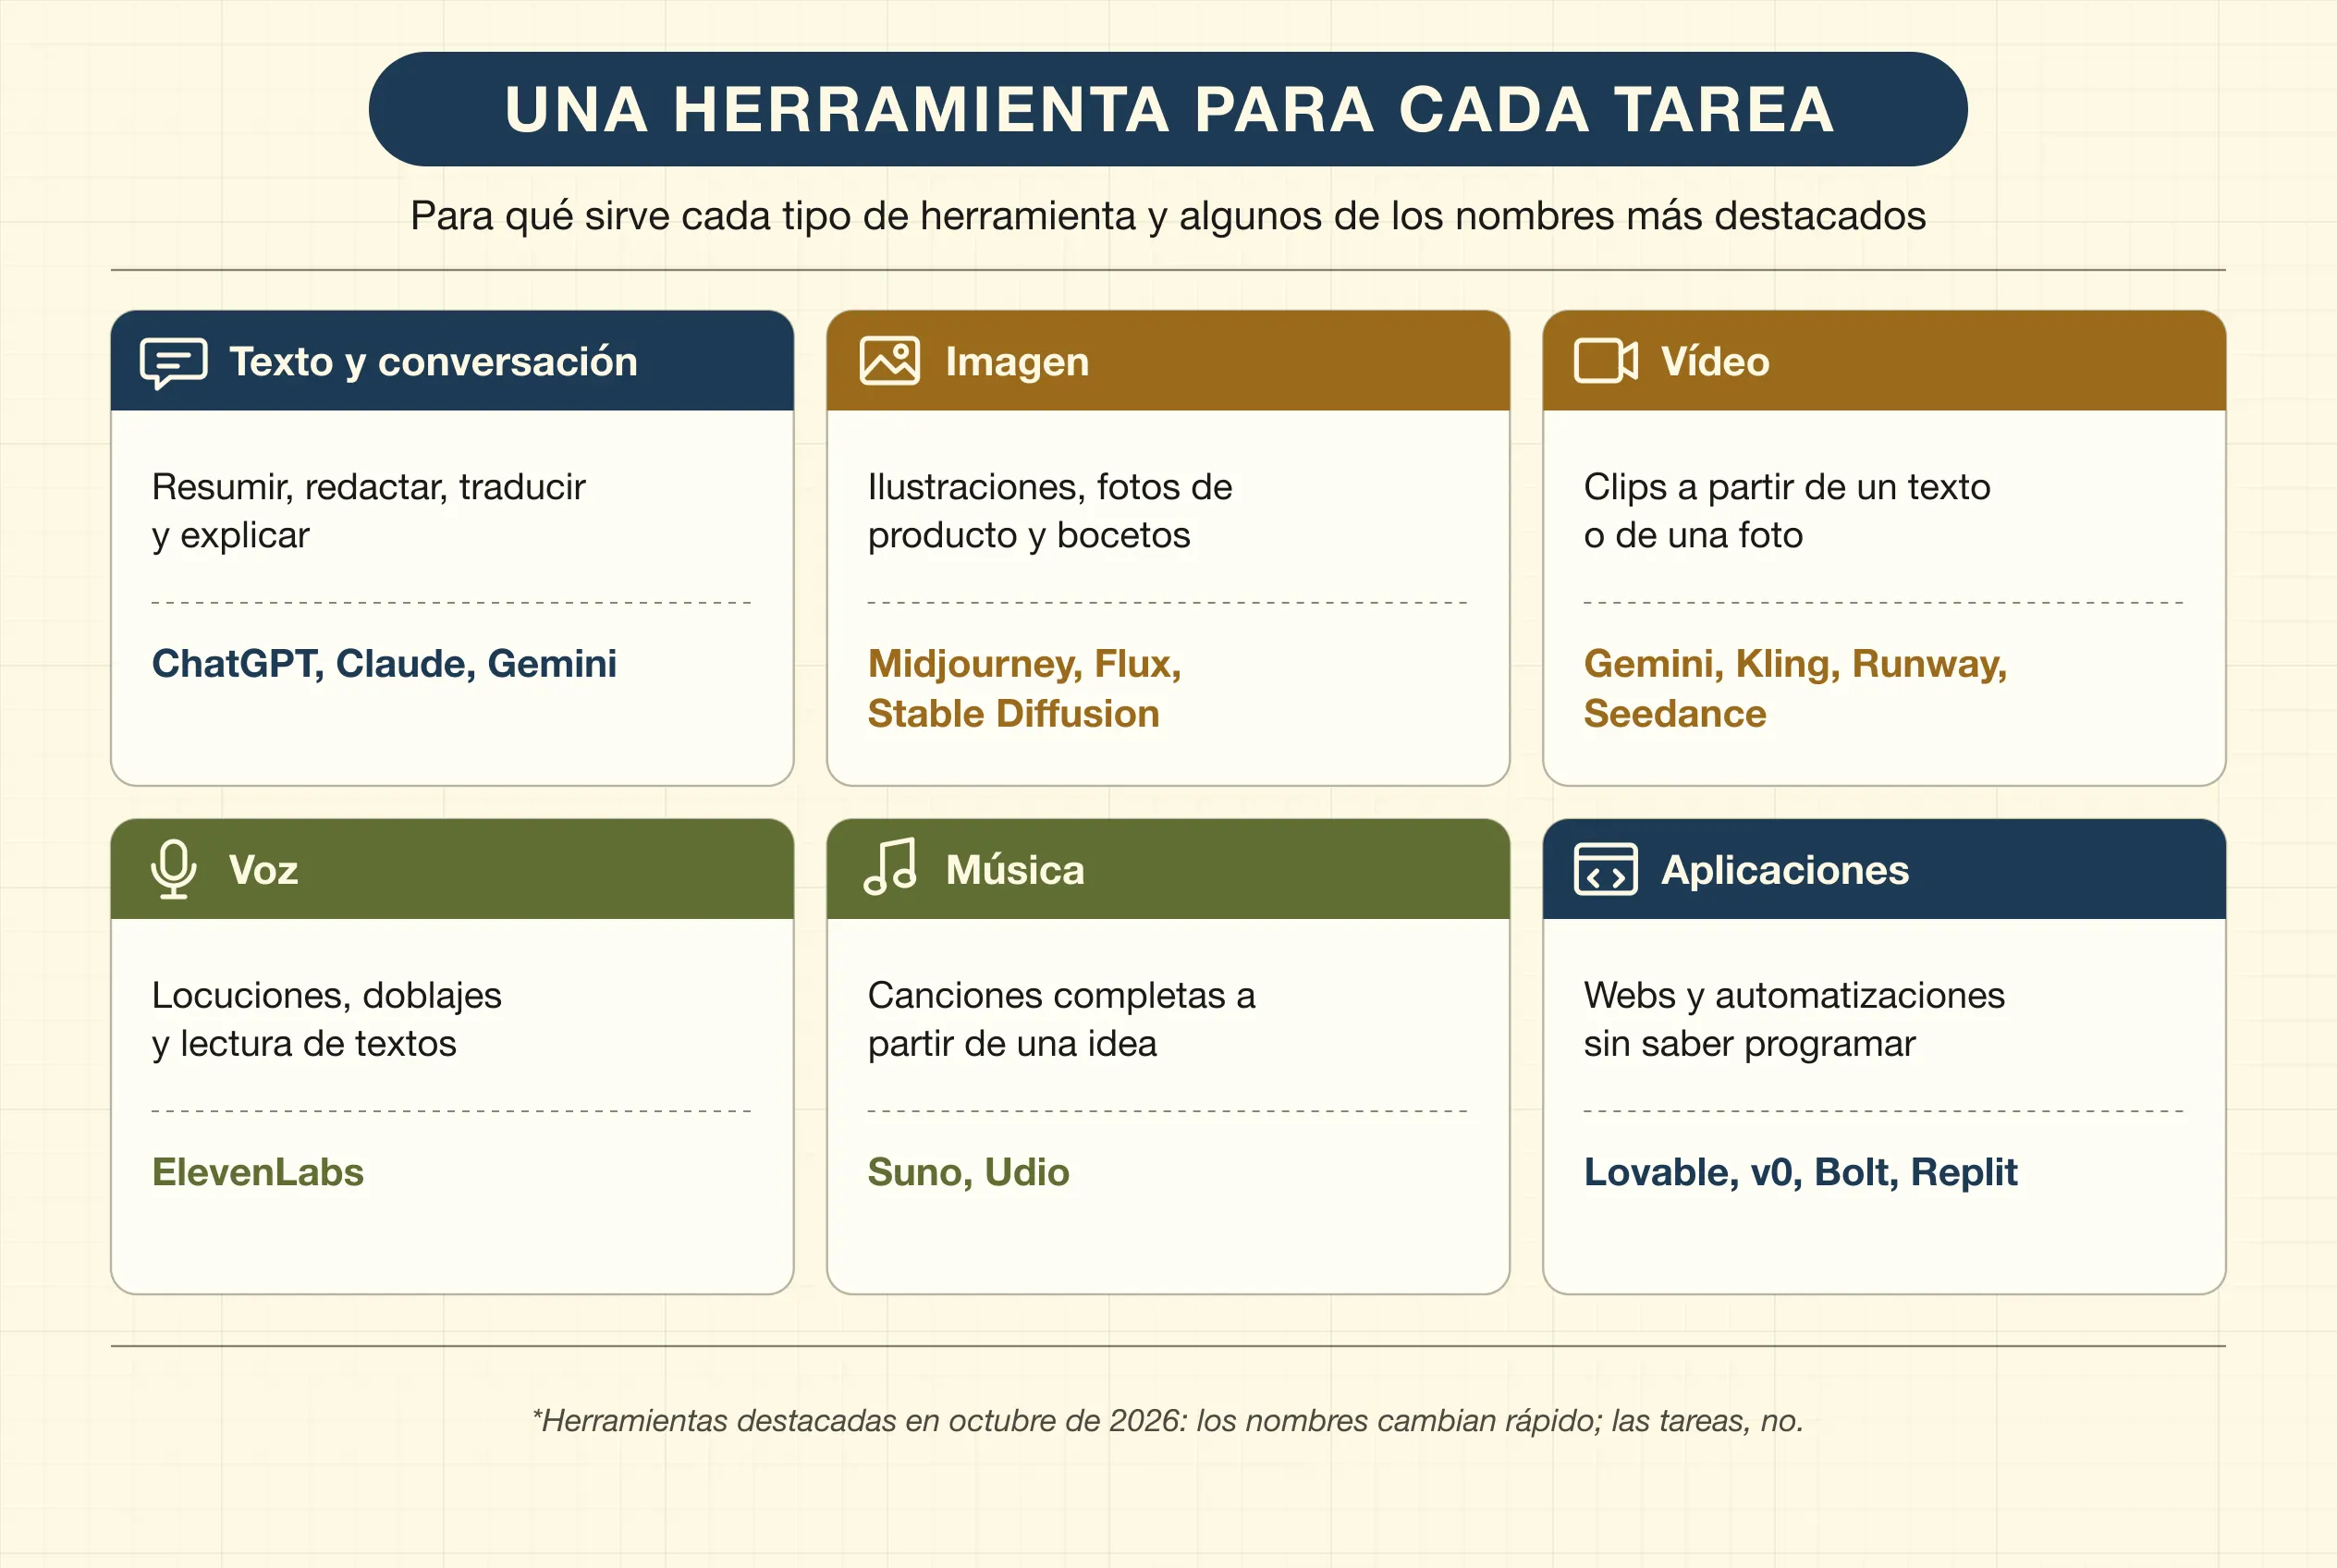
- Generación de imagen: herramientas como Midjourney, Flux, Stable Diffusion o los generadores integrados en ChatGPT y Gemini, capaces de interpretar descripciones complejas y crear ilustraciones, fotografías de producto o conceptos artísticos con un control fino de la iluminación y el estilo. La mayoría se basa en variantes de la difusión que vimos en la segunda parte.
- Vídeo sintético: la frontera del fotorrealismo en movimiento (Gemini, de Google, Kling, Runway o Seedance), capaz de generar secuencias fluidas a partir de instrucciones de texto o de imágenes estáticas. Su coherencia física ha mejorado mucho, pero es aparente: estos modelos imitan cómo se ve el mundo sin haber aprendido sus leyes.
- Audio, clonación de voz y música: plataformas de síntesis y clonación de voz hiperrealistas (ElevenLabs) y motores de composición musical completa (Suno, Udio) capaces de crear canciones estructuradas en cualquier género a partir de un poema o una idea general. Hoy bastan unos segundos de grabación para imitar una voz, lo que obliga a desconfiar de audios inesperados aunque suenen a alguien conocido.
- Programación y creación de aplicaciones: editores asistidos para programadores (Cursor) y plataformas (Lovable, v0, Bolt, Replit) que permiten a personas sin formación previa construir aplicaciones web, automatizaciones y sitios interactivos describiendo en lenguaje natural lo que quieren. La ganancia no siempre es la que parece: en un estudio controlado de 2025, programadores experimentados tardaron un 19 % más con ayuda de la IA en proyectos que conocían bien, aunque creían haber ido más rápido.
Comprender la trastienda de la inteligencia artificial —distinguiendo entre los pesos estáticos del modelo, las interfaces que lo envuelven, las herramientas de conexión como el MCP y la posibilidad real de alojar la tecnología en nuestro propio hardware— transforma radicalmente nuestra postura ante la tecnología. Dejamos de ser meros consumidores pasivos de productos cerrados y nos convertimos en arquitectos de nuestro propio flujo de trabajo digital.
Referencias y respaldo científico
- El modelo de lenguaje sin ajustar: GPT-3 aprendía tareas nuevas solo con unos pocos ejemplos en el propio texto de entrada. Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., … & Amodei, D. (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems, 33, 1877-1901. Consultar estudio en arXiv
- Cómo se convierte un completador de textos en un asistente: ajuste fino con ejemplos humanos y aprendizaje por refuerzo a partir de sus preferencias. Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C. L., Mishkin, P., … & Lowe, R. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35, 27730-27744. Consultar estudio en arXiv
- El aprendizaje por refuerzo con problemas de solución comprobable, que enseña a un modelo a razonar paso a paso. Guo, D., Yang, D., Zhang, H., Song, J., Wang, P., Zhu, Q., … & Zhang, Z. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645(8081), 633-638. Consultar artículo (DOI)
- Cómo se entrena a un modelo para que las instrucciones del sistema pesen más que las del usuario o las de un texto externo. Wallace, E., Xiao, K., Leike, R., Weng, L., Heidecke, J., & Beutel, A. (2024). The instruction hierarchy: Training LLMs to prioritize privileged instructions. arXiv, 2404.13208. Consultar estudio en arXiv
- La inyección indirecta de instrucciones: un texto malicioso escondido en una web o un documento puede tomar el control de una aplicación de IA. Greshake, K., Abdelnabi, S., Mishra, S., Endres, C., Holz, T., & Fritz, M. (2023). Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security, 79-90. Consultar estudio (DOI)
- Una familia de modelos entrenados desde el principio con texto, imagen, audio y vídeo a la vez. Gemini Team, Google. (2023). Gemini: A family of highly capable multimodal models. arXiv, 2312.11805. Consultar informe en arXiv
- Un modelo que aprende por sí mismo cuándo y cómo llamar a una calculadora, un buscador o un traductor. Schick, T., Dwivedi-Yu, J., Dessì, R., Raileanu, R., Lomeli, M., Zettlemoyer, L., Cancedda, N., & Scialom, T. (2023). Toolformer: Language models can teach themselves to use tools. Advances in Neural Information Processing Systems, 36, 68539-68551. Consultar estudio en arXiv
- La presentación de las skills: carpetas de instrucciones y recursos que el agente carga solo cuando la tarea las necesita. Zhang, B., Lazuka, K., & Murag, M. (2025). Equipping agents for the real world with Agent Skills. Anthropic Engineering. Consultar el artículo de Anthropic
- El anuncio del protocolo MCP, un estándar abierto para conectar los modelos con datos y herramientas externas. Anthropic. (2024). Introducing the Model Context Protocol. Consultar el anuncio de Anthropic
- Cómo funciona MCP y qué riesgos de seguridad abre cada servidor conectado. Hou, X., Zhao, Y., Wang, S., & Wang, H. (2026). Model Context Protocol (MCP): Landscape, security threats, and future research directions. ACM Transactions on Software Engineering and Methodology, 35(10), 1-37. Consultar artículo (DOI)
- El artículo que dio nombre a la técnica RAG: combinar un modelo de lenguaje con un buscador de documentos. Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., … & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. Advances in Neural Information Processing Systems, 33, 9459-9474. Consultar estudio en arXiv
- Una revisión de las variantes de RAG, de cómo se evalúan y de sus límites. Gao, Y., Xiong, Y., Gao, X., Jia, K., Pan, J., Bi, Y., … & Wang, H. (2023). Retrieval-augmented generation for large language models: A survey. arXiv, 2312.10997. Consultar estudio en arXiv
- Reducir la precisión de los pesos a 8 bits sin perder calidad, para ejecutar modelos grandes con mucha menos memoria. Dettmers, T., Lewis, M., Belkada, Y., & Zettlemoyer, L. (2022). LLM.int8(): 8-bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems, 35, 30318-30332. Consultar estudio en arXiv
- La cuantización a 3 y 4 bits, que permitió ejecutar modelos de lenguaje en una sola tarjeta gráfica. Frantar, E., Ashkboos, S., Hoefler, T., & Alistarh, D. (2023). GPTQ: Accurate post-training quantization for generative pre-trained transformers. International Conference on Learning Representations (ICLR). Consultar estudio en arXiv
- La variante de la difusión en la que se basan Stable Diffusion 3 y sus sucesores. Esser, P., Kulal, S., Blattmann, A., Entezari, R., Müller, J., Saini, H., … & Rombach, R. (2024). Scaling rectified flow transformers for high-resolution image synthesis. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 12606-12633. Consultar estudio en arXiv
- Los generadores de vídeo producen escenas verosímiles, pero fallan al predecir cómo se comportan los objetos según las leyes de la física. Motamed, S., Culp, L., Swersky, K., Jaini, P., & Geirhos, R. (2026). Do generative video models understand physical principles? Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV), 948-958. Consultar estudio (DOI)
- VALL-E: imitar una voz cualquiera a partir de una grabación de solo tres segundos. Chen, S., Wang, C., Wu, Y., Zhang, Z., Zhou, L., Liu, S., … & Wei, F. (2025). Neural codec language models are zero-shot text to speech synthesizers. IEEE Transactions on Audio, Speech and Language Processing, 33, 705-718. Consultar artículo (DOI)
- Un ensayo controlado con programadores experimentados: con ayuda de la IA tardaron un 19 % más, aunque creían haber ido más rápido. Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv, 2507.09089. Consultar estudio en arXiv
Estamos preparando el espacio para que puedas comentar los artículos.
Sigue leyendo
El corazón en la piel
Cómo la radiación ultravioleta libera el óxido nítrico de la piel para regular la presión arterial y combatir el riesgo cardiovascular
Efecto Zeigarnik o el coste de tener ideas brillantes
El fenómeno psicológico que sabotea tu descanso en nombre de la creatividad
Agua estructurada: el terreno de la salud
La batería líquida de tus células y cómo protegerla del entorno moderno