Il laboratorio del creatore
Modelli, strumenti e le chiavi che permettono all'intelligenza artificiale di collegarsi al mondo reale
Nella cultura popolare si è radicato un fenomeno di metonimia tecnologica simile a quello che a suo tempo ha riguardato marchi come Scottex o Rimmel: usiamo il nome di un prodotto commerciale per indicare un’intera disciplina scientifica. Per la maggior parte degli utenti, «ChatGPT» è sinonimo di intelligenza artificiale, allo stesso modo in cui «scottex» ha preso il posto della carta da cucina nel vocabolario di tutti i giorni.
Nell’ecosistema tecnologico attuale è fondamentale separare il modello fondazionale (l’intelligenza matematica che elabora schemi) dall’applicazione commerciale (l’interfaccia amichevole pensata per il grande pubblico). Capire questa distinzione non è un capriccio accademico: è il primo passo per riprendere il controllo sui nostri dati, capire come agiscono gli strumenti e sapere che cosa succede davvero dietro lo schermo.
Anatomia di un’applicazione di IA
Per capire come funziona l’ecosistema moderno dell’IA bisogna distinguere due concetti che il marketing tende a fondere in uno solo: il modello e lo strumento (o interfaccia).
Il modello
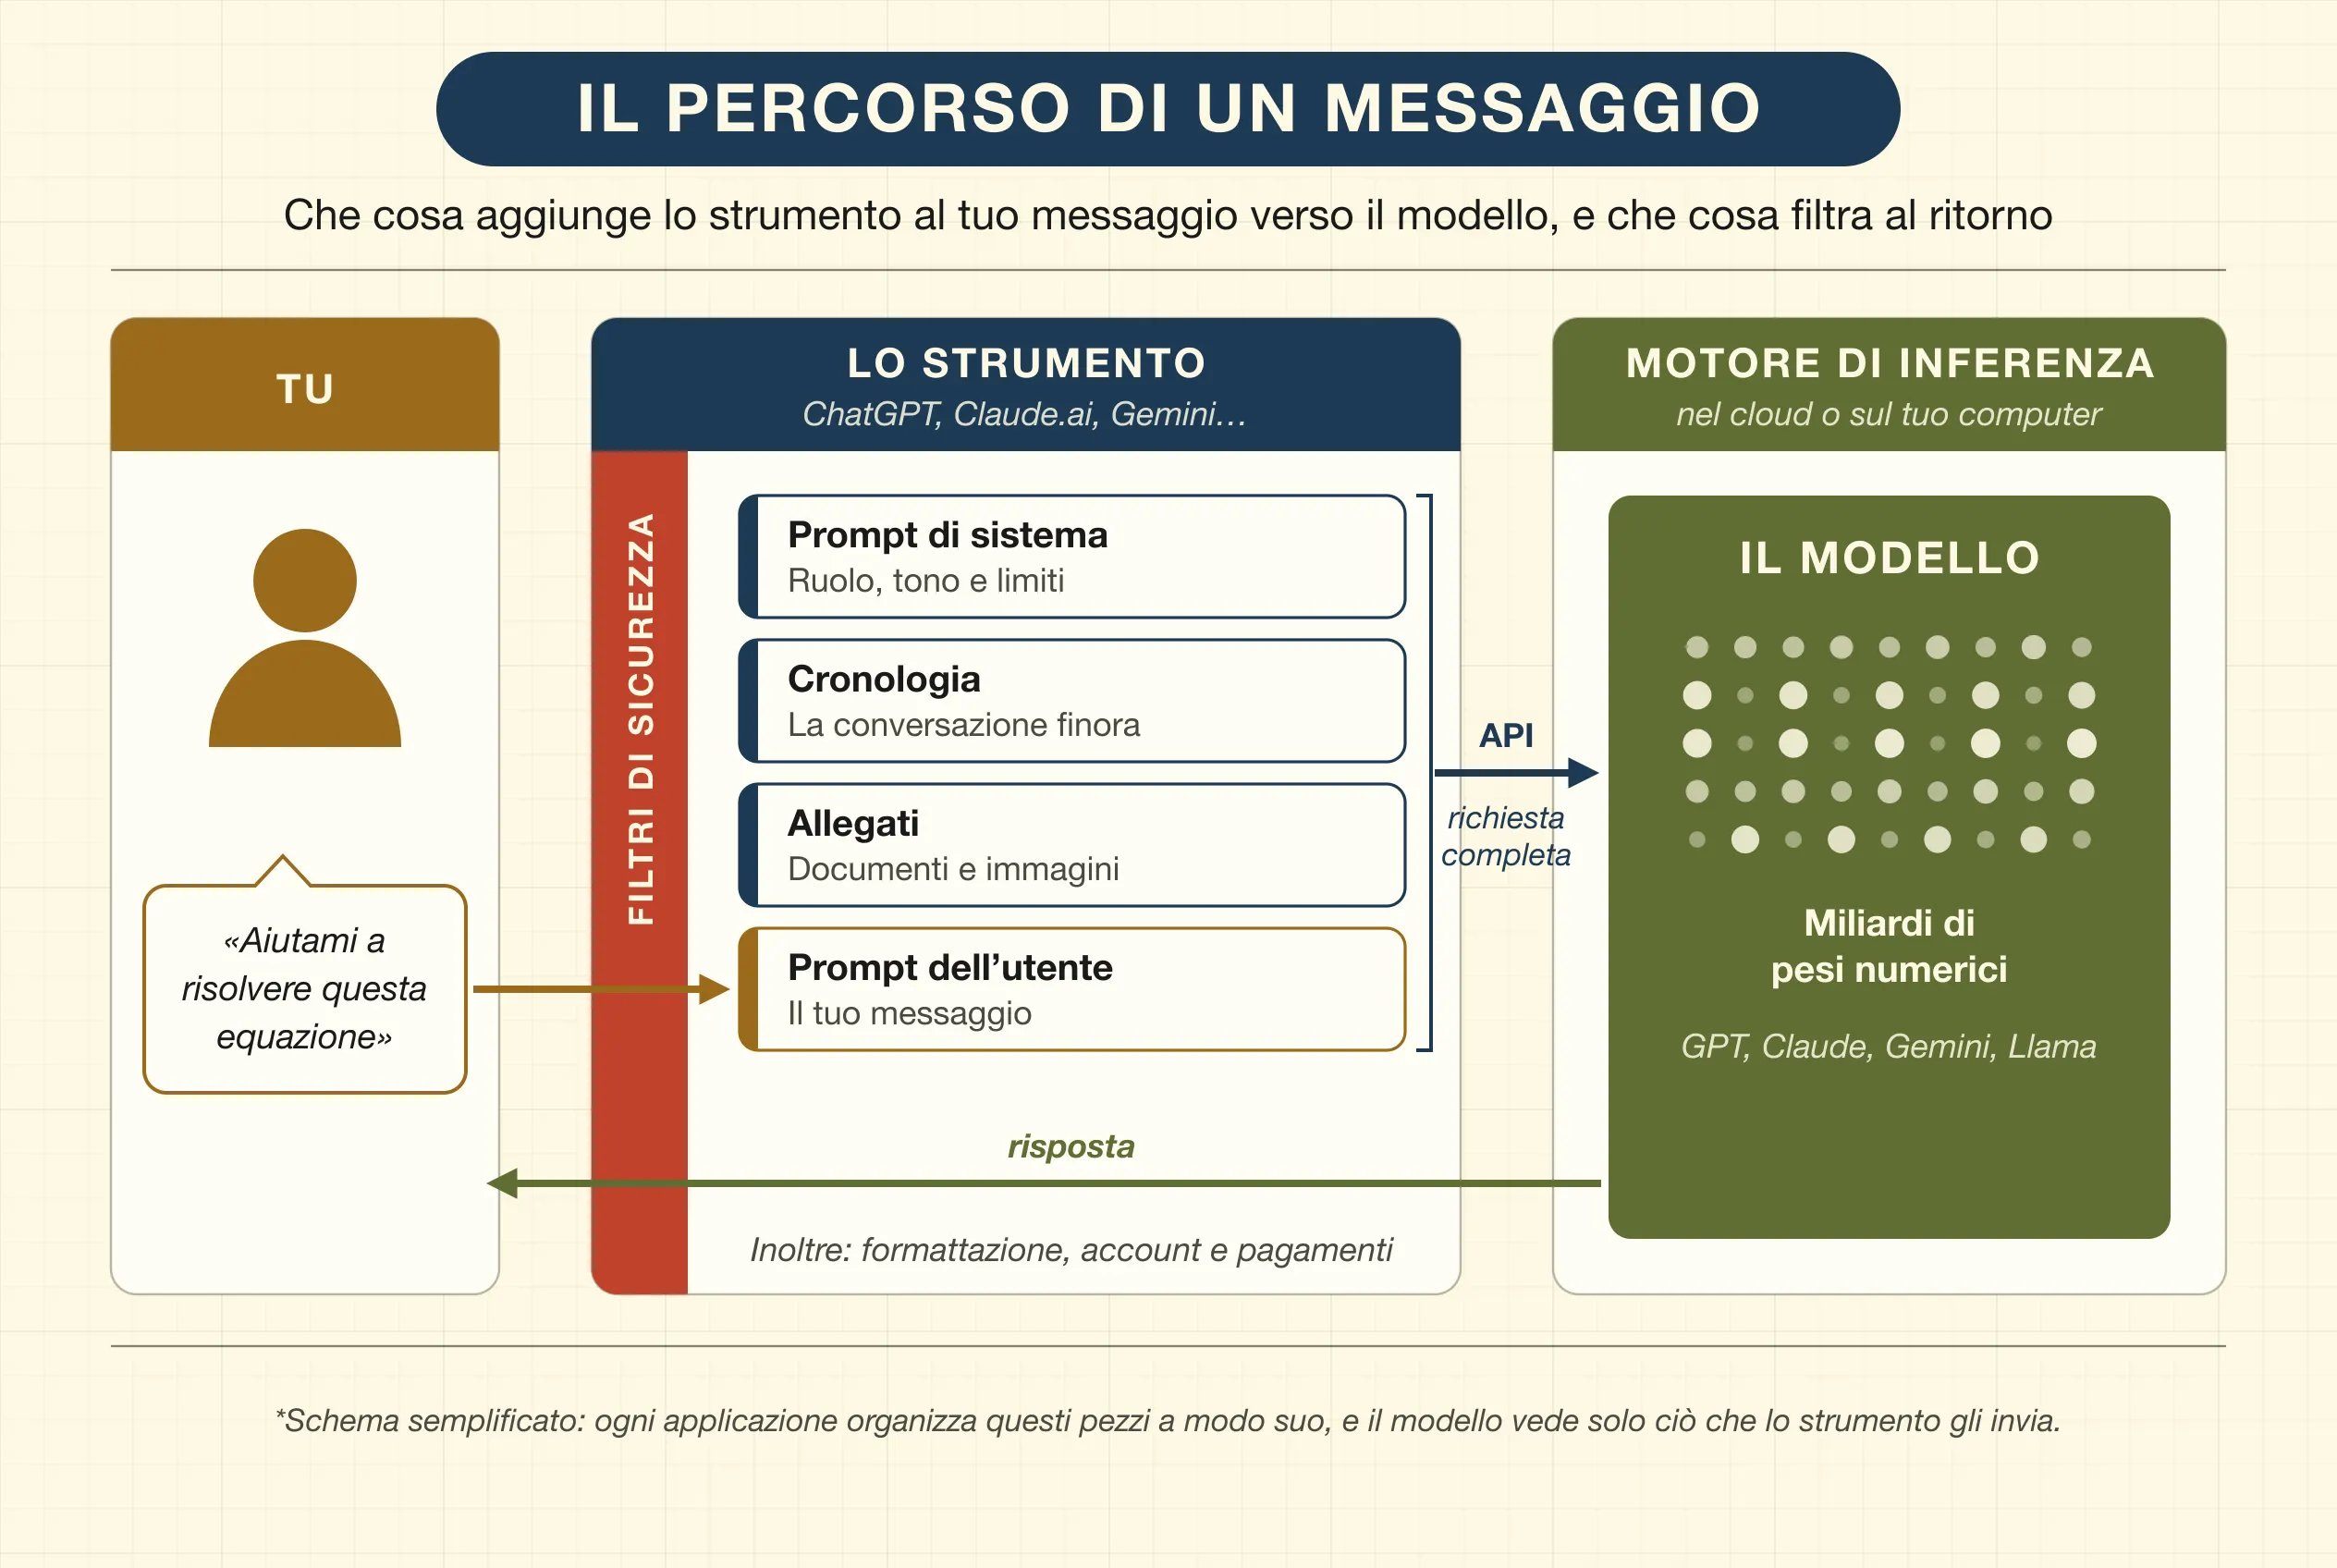
È il nucleo matematico: miliardi di parametri numerici (i pesi sinaptici) regolati per mesi su supercomputer. Da solo, un file di pesi è come un archivio compresso pieno di rumore organizzato: non ha pulsanti, né barra della chat, né cronologia, né i filtri di moderazione che aggiungono le applicazioni, anche se conserva il comportamento appreso durante l’addestramento, come rifiutare certe richieste. Per usarlo serve un motore di inferenza che lo esegua e, di solito, un’interfaccia di programmazione (API) attraverso cui altre applicazioni gli inviano richieste e ne ricevono le risposte.
- Esempi di modelli sono GPT-6.1 Terra, Claude Opus 5.5, Gemini 4 Carbon o Llama 4.
Lo strumento
Sono le applicazioni che traducono la nostra digitazione in richieste comprensibili per il modello e ne presentano la risposta come testo formattato, pulsanti o grafici gradevoli alla vista.
Questo strato di software si occupa di formattare il testo, conservare la cronologia delle conversazioni, permettere il caricamento di allegati, gestire i pagamenti e, soprattutto, applicare i filtri di sicurezza e moderazione prima e dopo che il modello generi una risposta.
- Esempi di strumenti sono il portale web di ChatGPT, l’app Claude.ai o l’interfaccia di Gemini. Lo dice il nome stesso: ChatGPT è lo strumento, e GPT la famiglia di modelli che lavora al suo interno.
Il ciclo di vita di un modello
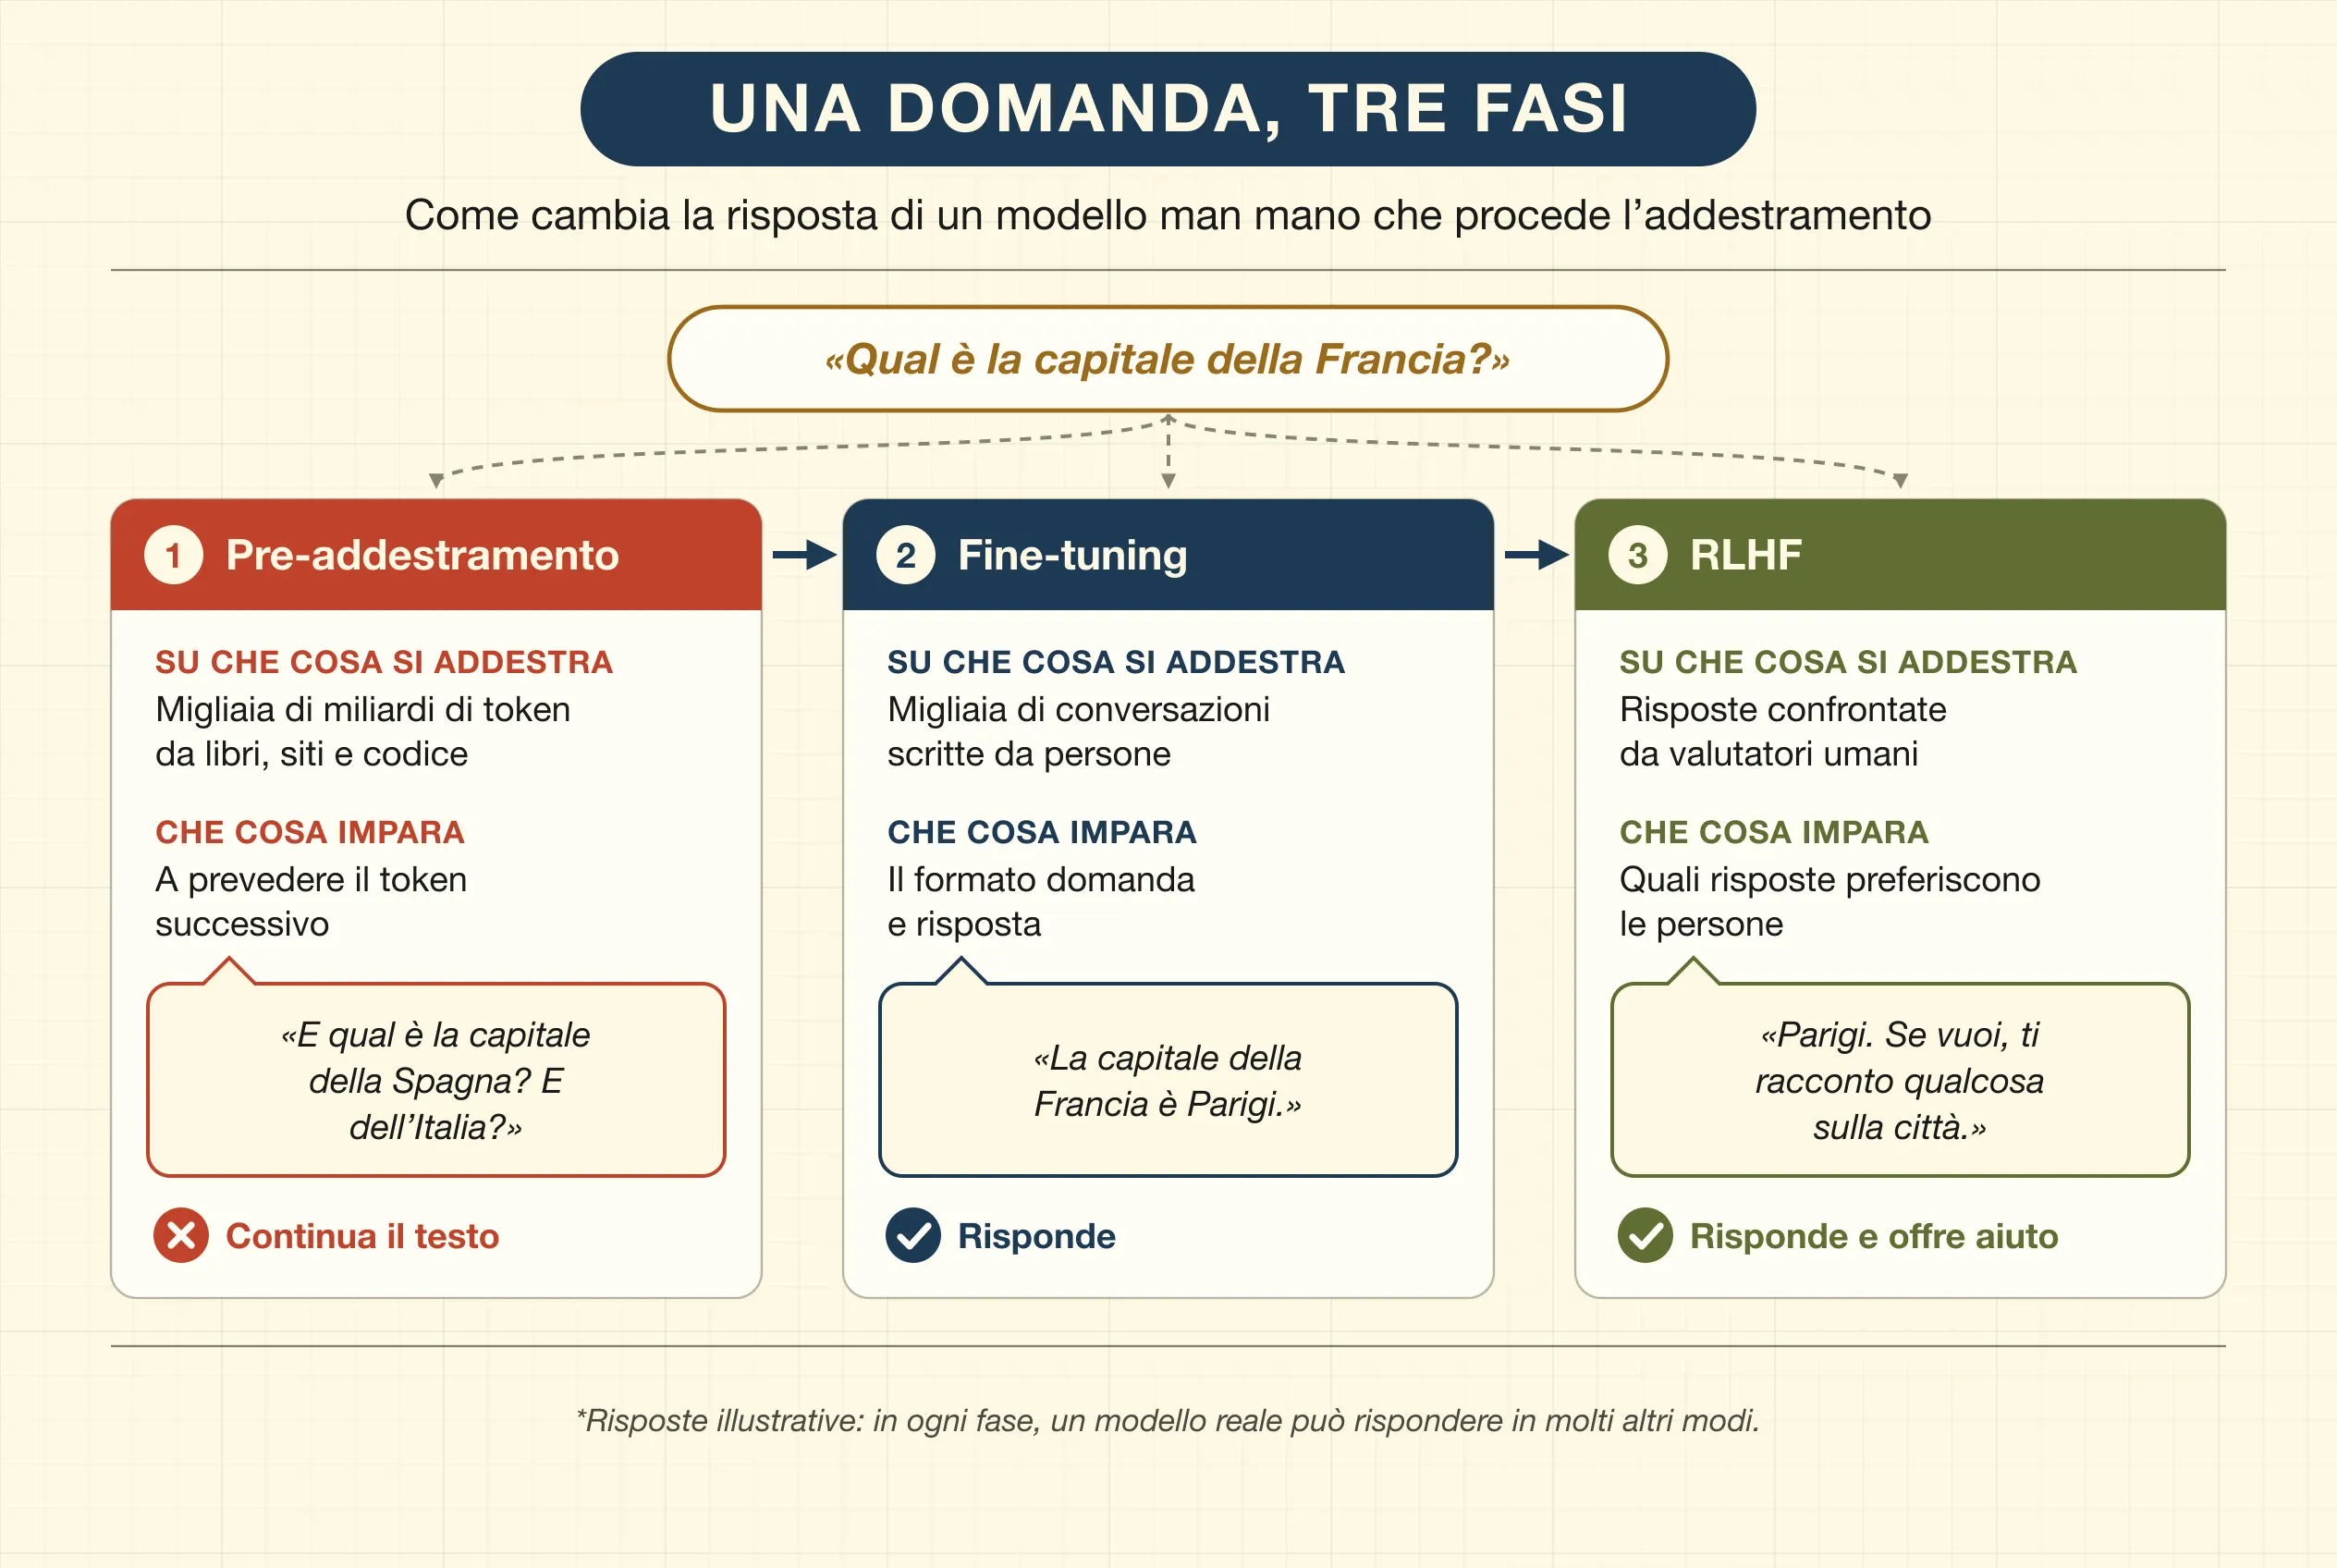
Prima di poter essere integrato in un’applicazione, un modello attraversa un processo rigoroso in tre fasi fondamentali:
-
Pre-addestramento: il modello «legge» internet su vasta scala, con i suoi libri, articoli e codice sorgente. Qui acquisisce la sua comprensione generale del linguaggio e del mondo a forza di prevedere il token successivo. Il processo richiede supercomputer per mesi e costi milionari.
Alla fine di questa fase il modello è un puro «completatore di testi»: se gli chiedi «Qual è la capitale della Francia?», può darsi che non risponda «Parigi», ma che continui scrivendo «E qual è la capitale della Spagna?», perché ha imparato a imitare la struttura di ciò che legge, e in un elenco di esercizi una domanda è di solito seguita da un’altra.
-
Ottimizzazione supervisionata (fine-tuning): il modello viene addestrato con migliaia di esempi di conversazioni scritte e revisionate da persone, che gli insegnano ad adottare un formato di domanda e risposta utile e sicuro. Con lo stesso procedimento gli si possono dare competenze specifiche in un ambito preciso, come la medicina, il diritto o la programmazione.
-
RLHF (Reinforcement Learning from Human Feedback): apprendimento per rinforzo a partire dalle preferenze umane. Alcuni valutatori confrontano diverse risposte del modello e scelgono le migliori; con quelle scelte il modello viene premiato o penalizzato in base all’utilità e alla veridicità di ciò che dice, il che ne modella il tono definitivo.
Nei modelli più recenti si aggiunge un’ulteriore fase di apprendimento per rinforzo, questa volta su problemi la cui soluzione si può verificare automaticamente, come quelli di matematica o di programmazione. È ciò che insegna ai cosiddetti modelli di ragionamento a «pensare» passo dopo passo prima di rispondere.
Prompt e multimodalità nativa
Nella divulgazione recente si è diffusa l’idea del prompt come semplice domanda che l’utente digita nella casella della chat. Nell’architettura software reale, però, esiste una distinzione cruciale tra due tipi di istruzioni.
Prompt di sistema
È l’insieme di regole invisibili che gli sviluppatori dello strumento inseriscono prima che l’utente scriva una sola lettera. Il prompt di sistema (system prompt) fissa il quadro d’azione, il ruolo, il tono e i limiti dell’IA.
- Per esempio, un prompt di sistema può stabilire: «Sei un tutor di matematica per bambini di 10 anni. Non dare mai la risposta diretta; spiega i concetti passo dopo passo con metafore semplici e mantieni sempre un tono incoraggiante e paziente».
Prompt dell’utente
È l’input diretto dell’utente («Aiutami a risolvere questa equazione di primo grado»). Il modello elabora il prompt dell’utente (user prompt) sempre attraverso la lente e le restrizioni fissate in precedenza dal prompt di sistema.
I modelli vengono addestrati a dare la precedenza alle istruzioni del sistema, ma questa gerarchia non è infallibile: un utente abile, o un testo malevolo nascosto in una pagina web o in un documento che il modello legge, può riuscire ad aggirarla. È ciò che si chiama iniezione di istruzioni (prompt injection).
Multimodalità nativa
Per anni, perché un’IA analizzasse un’immagine, un sistema visivo indipendente la descriveva a parole e poi inviava quella descrizione al modello linguistico. Oggi i modelli più avanzati sono multimodali in modo nativo: vengono addestrati fin dall’inizio con testo, immagini, audio e video, che elaborano e mettono in relazione tra loro all’interno dello stesso spazio vettoriale, senza bisogno di traduttori intermedi.
Le «mani» del modello
Un modello linguistico puro è confinato in un recinto chiuso (sandbox): può solo prevedere testo basandosi sulla memoria statica del suo addestramento. Per essere davvero utile nel mondo reale, ha bisogno di estensioni che facciano da arti e da sensi.
Uso di strumenti
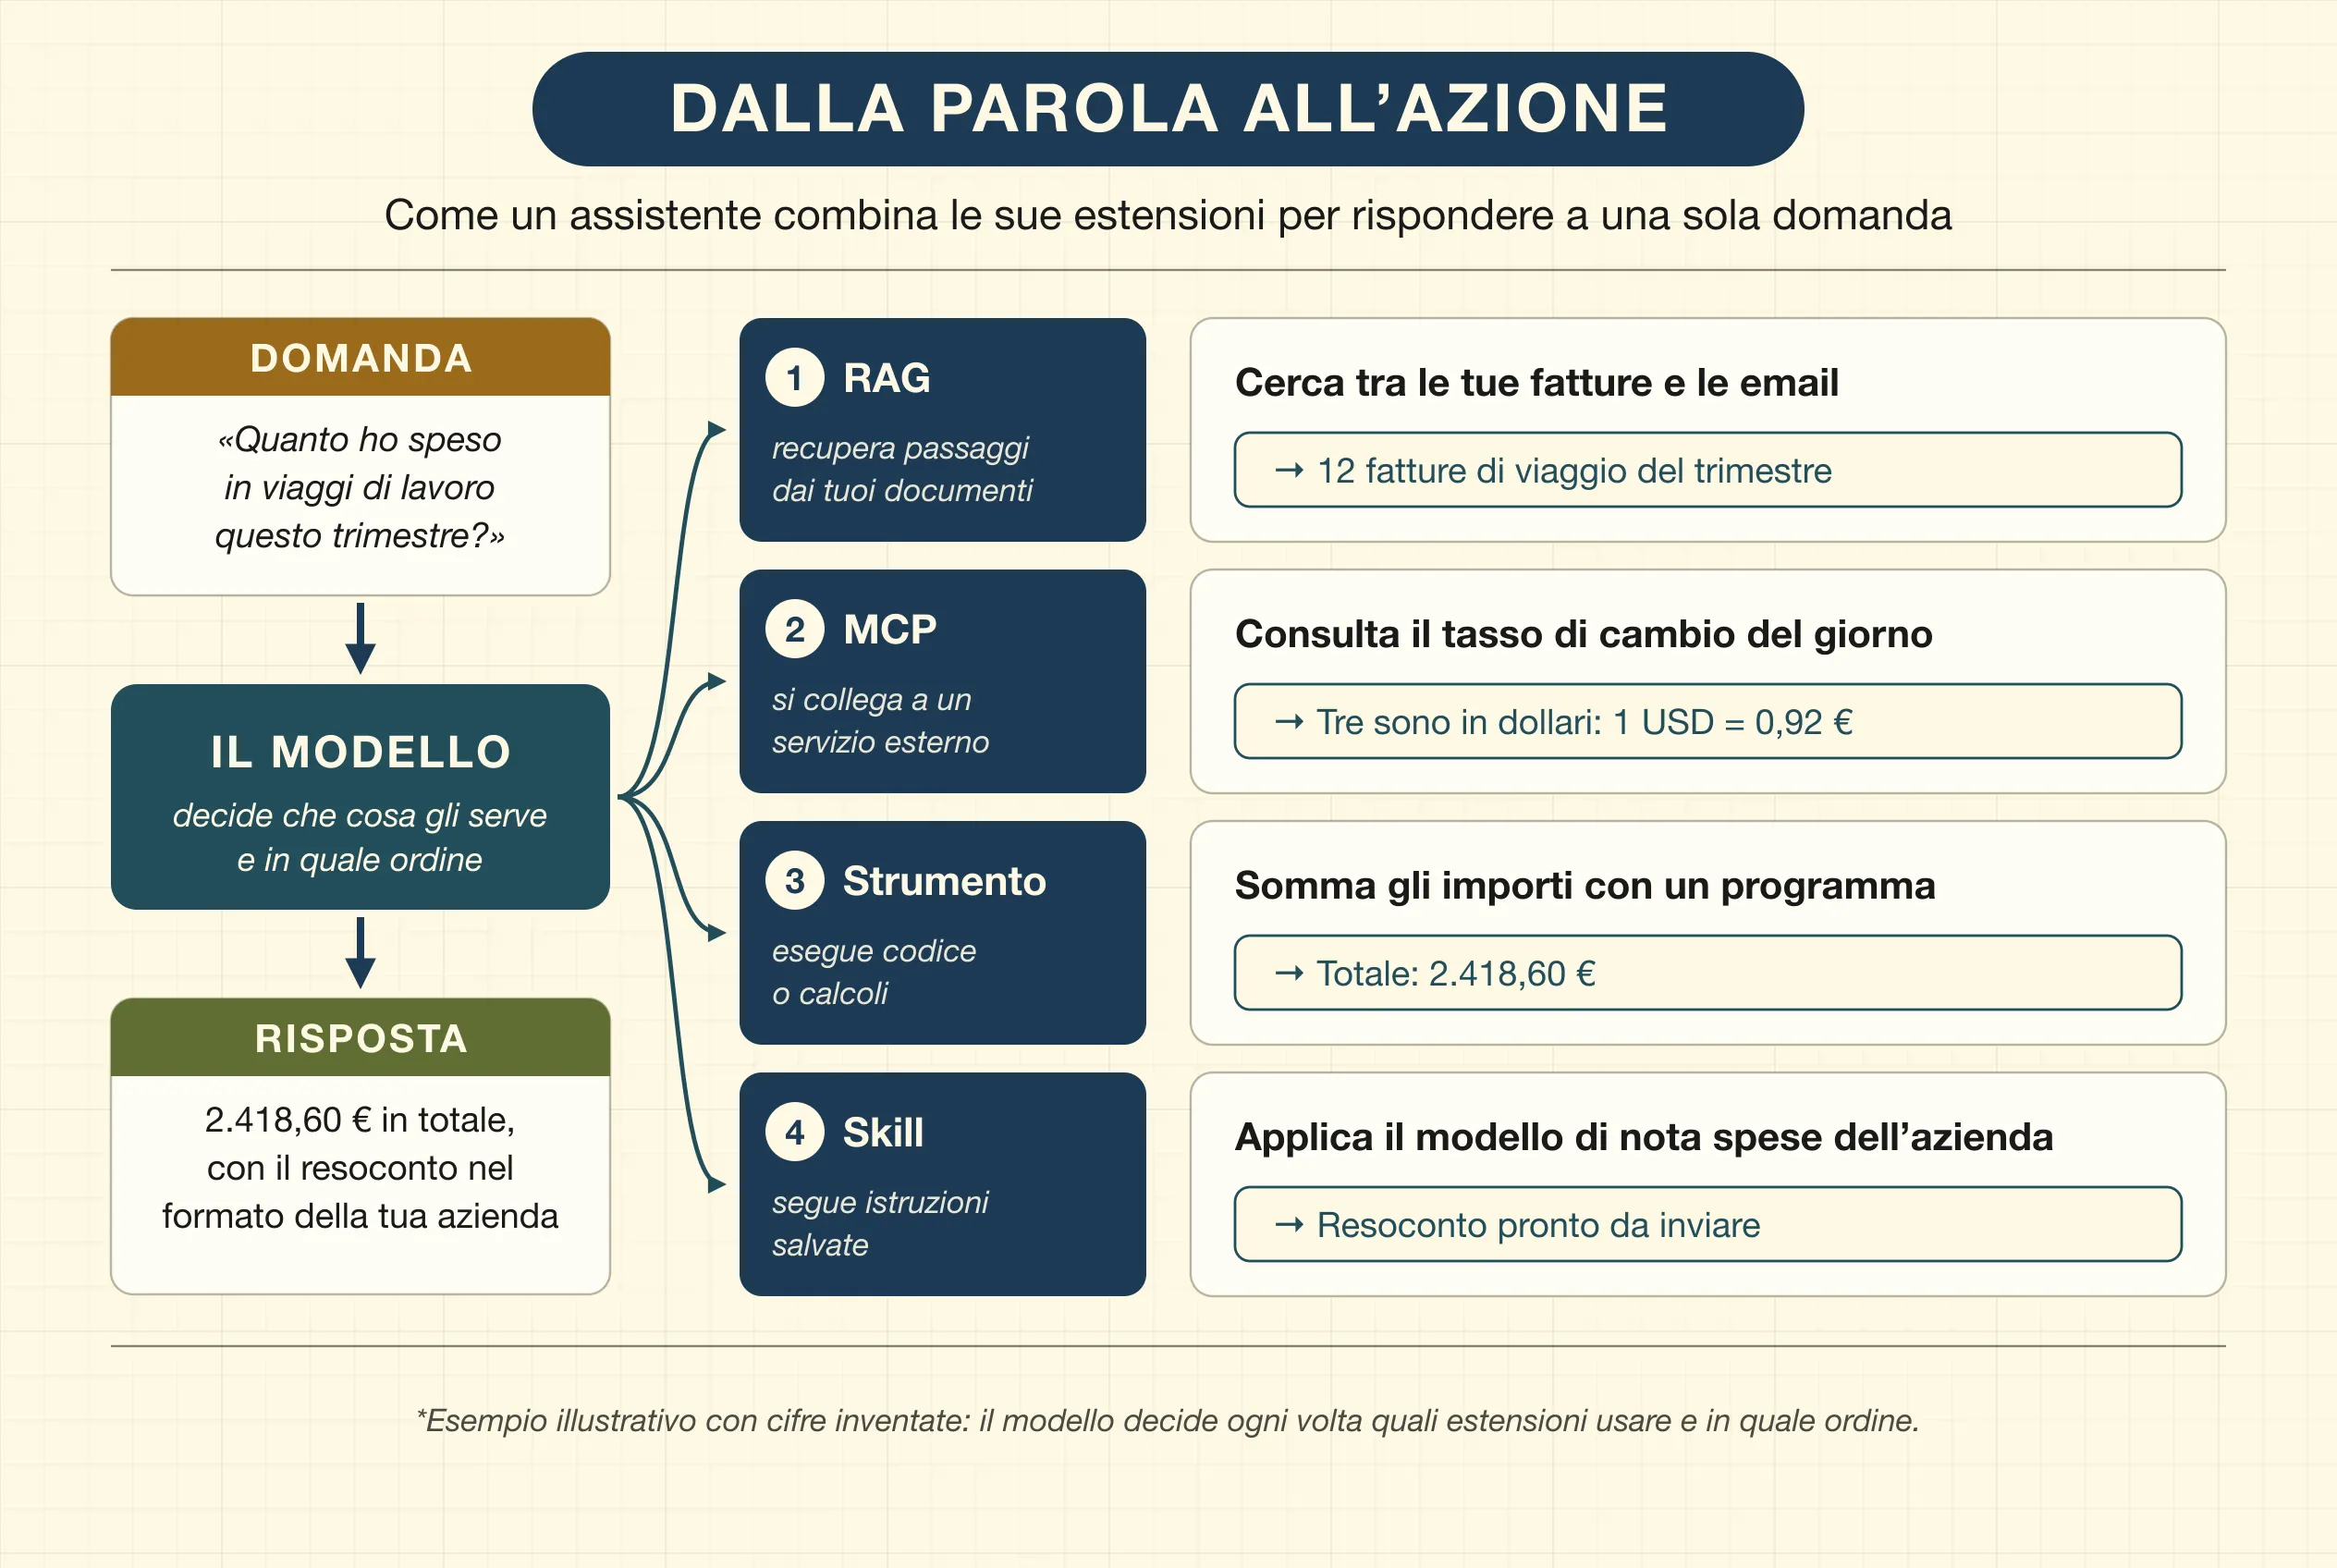
Il tassello di base è la capacità del modello di riconoscere quando un compito è fuori dalla sua portata. Se gli chiedi di moltiplicare due numeri di 15 cifre o di conoscere le ultime notizie, un modello ben addestrato sa che il suo calcolo probabilistico può sbagliare o che gli manca il dato. Invece di inventarlo, emette una richiesta strutturata per invocare una funzione esterna: l’applicazione apre una calcolatrice, esegue un programma in Python o fa una ricerca sul web, gli restituisce il risultato e il modello lo usa per darti la risposta corretta.
Non sempre capisce bene quando ha bisogno di aiuto, ma questa capacità, nota in inglese come tool use o function calling, è la base di tutto ciò che segue.
Skill
Una skill (o abilità) è un insieme strutturato di istruzioni, regole, esempi e risorse che si fornisce a un agente di IA perché sappia esattamente come svolgere un compito preciso. Può includere istruzioni passo dopo passo, buone pratiche, vincoli, esempi di codice, modelli aziendali o programmi ausiliari.
Sono particolarmente utili per compiti ripetitivi, complessi o in più passaggi che richiedono di seguire un formato, un tono o una procedura molto specifici. Funzionano come un manuale di istruzioni o una ricetta che l’IA consulta quando deve svolgere un determinato lavoro, il che evita di dover scrivere ogni volta un prompt lungo.
Il formato è stato presentato da Anthropic nell’ottobre 2025 e oggi è uno standard aperto. Ogni skill è una cartella con un file di istruzioni, e l’agente ne legge solo il nome e la descrizione finché un compito non la richiede; allora carica il resto.
MCP (Model Context Protocol)
Un modello linguistico da solo è un cervello isolato in una stanza buia: sa molto del passato, ma non può vedere l’ora attuale, non sa che tempo fa fuori e non può consultare i tuoi documenti privati. Per risolvere il problema, l’ingegneria ha dato ai modelli la capacità di interagire con strumenti e fonti di dati del «mondo esterno» attraverso i connettori MCP.
Presentato da Anthropic alla fine del 2024 e adottato poi da OpenAI, Google e Microsoft, il Model Context Protocol (MCP) standardizza il collegamento tra i modelli di IA e le fonti di dati locali o aziendali. Funziona come una porta USB universale: definisce un protocollo comune perché qualsiasi modello possa collegarsi in entrambe le direzioni a database, strumenti aziendali o programmi specifici, come Figma, Slack o Notion. Dalla fine del 2025 lo gestisce una fondazione indipendente, all’interno della Linux Foundation.
Attraverso un connettore MCP, un modello può per esempio interrogare un servizio meteorologico per sapere che tempo fa in questo momento. Senza questo tipo di strumenti non avrebbe modo di saperlo, perché quell’informazione non era nei suoi dati di addestramento. Il rovescio della medaglia è che ogni connettore apre una porta: uno malevolo o mal configurato può far trapelare dati o passare istruzioni di nascosto al modello, quindi conviene installare solo quelli di fonti affidabili.
RAG (Retrieval-Augmented Generation)
La generazione aumentata dal recupero è la tecnica preferita dalle aziende per far lavorare l’IA sulla propria documentazione privata senza spendere milioni per riaddestrare il modello. Invece di far imparare le informazioni a memoria al modello, il sistema RAG funziona come un esame a libro aperto: quando l’utente fa una domanda, lo strumento cerca in pochi millisecondi i paragrafi più pertinenti nei documenti (confrontandone il significato grazie agli embedding che abbiamo visto nella prima parte), li allega in modo invisibile al prompt e chiede al modello di redigere la risposta basandosi esclusivamente su quei frammenti.
Così le invenzioni si riducono molto, anche se non scompaiono del tutto: se la ricerca porta il paragrafo sbagliato, il modello risponderà con la stessa sicurezza.
Esecuzione locale e modelli a pesi aperti
Fino a poco tempo fa, usare l’intelligenza artificiale significava passare per i server delle grandi aziende tecnologiche, il che comportava inviare dati privati al cloud. Oggi l’ottimizzazione del software ha aperto la porta alla sovranità del dato: eseguire modelli potenti direttamente sul nostro computer, completamente scollegato da internet. È ciò che permettono i modelli a pesi aperti che abbiamo visto nella seconda parte.
Perché eseguire in locale?
- Privacy assoluta: i tuoi documenti, dati finanziari o testi creativi non lasciano mai il tuo disco.
- Senza intermediari né abbonamenti: sei tu a decidere le regole d’uso e non dipendi da canoni mensili, da cambi nelle condizioni di servizio né da guasti dei server.
- Lavoro offline: piena capacità di elaborazione in zone senza copertura o in ambienti ad alta sicurezza.
Il prezzo da pagare è che i modelli che entrano in un computer domestico restano indietro rispetto ai grandi modelli chiusi del cloud, soprattutto nei compiti più complessi.
Quantizzazione
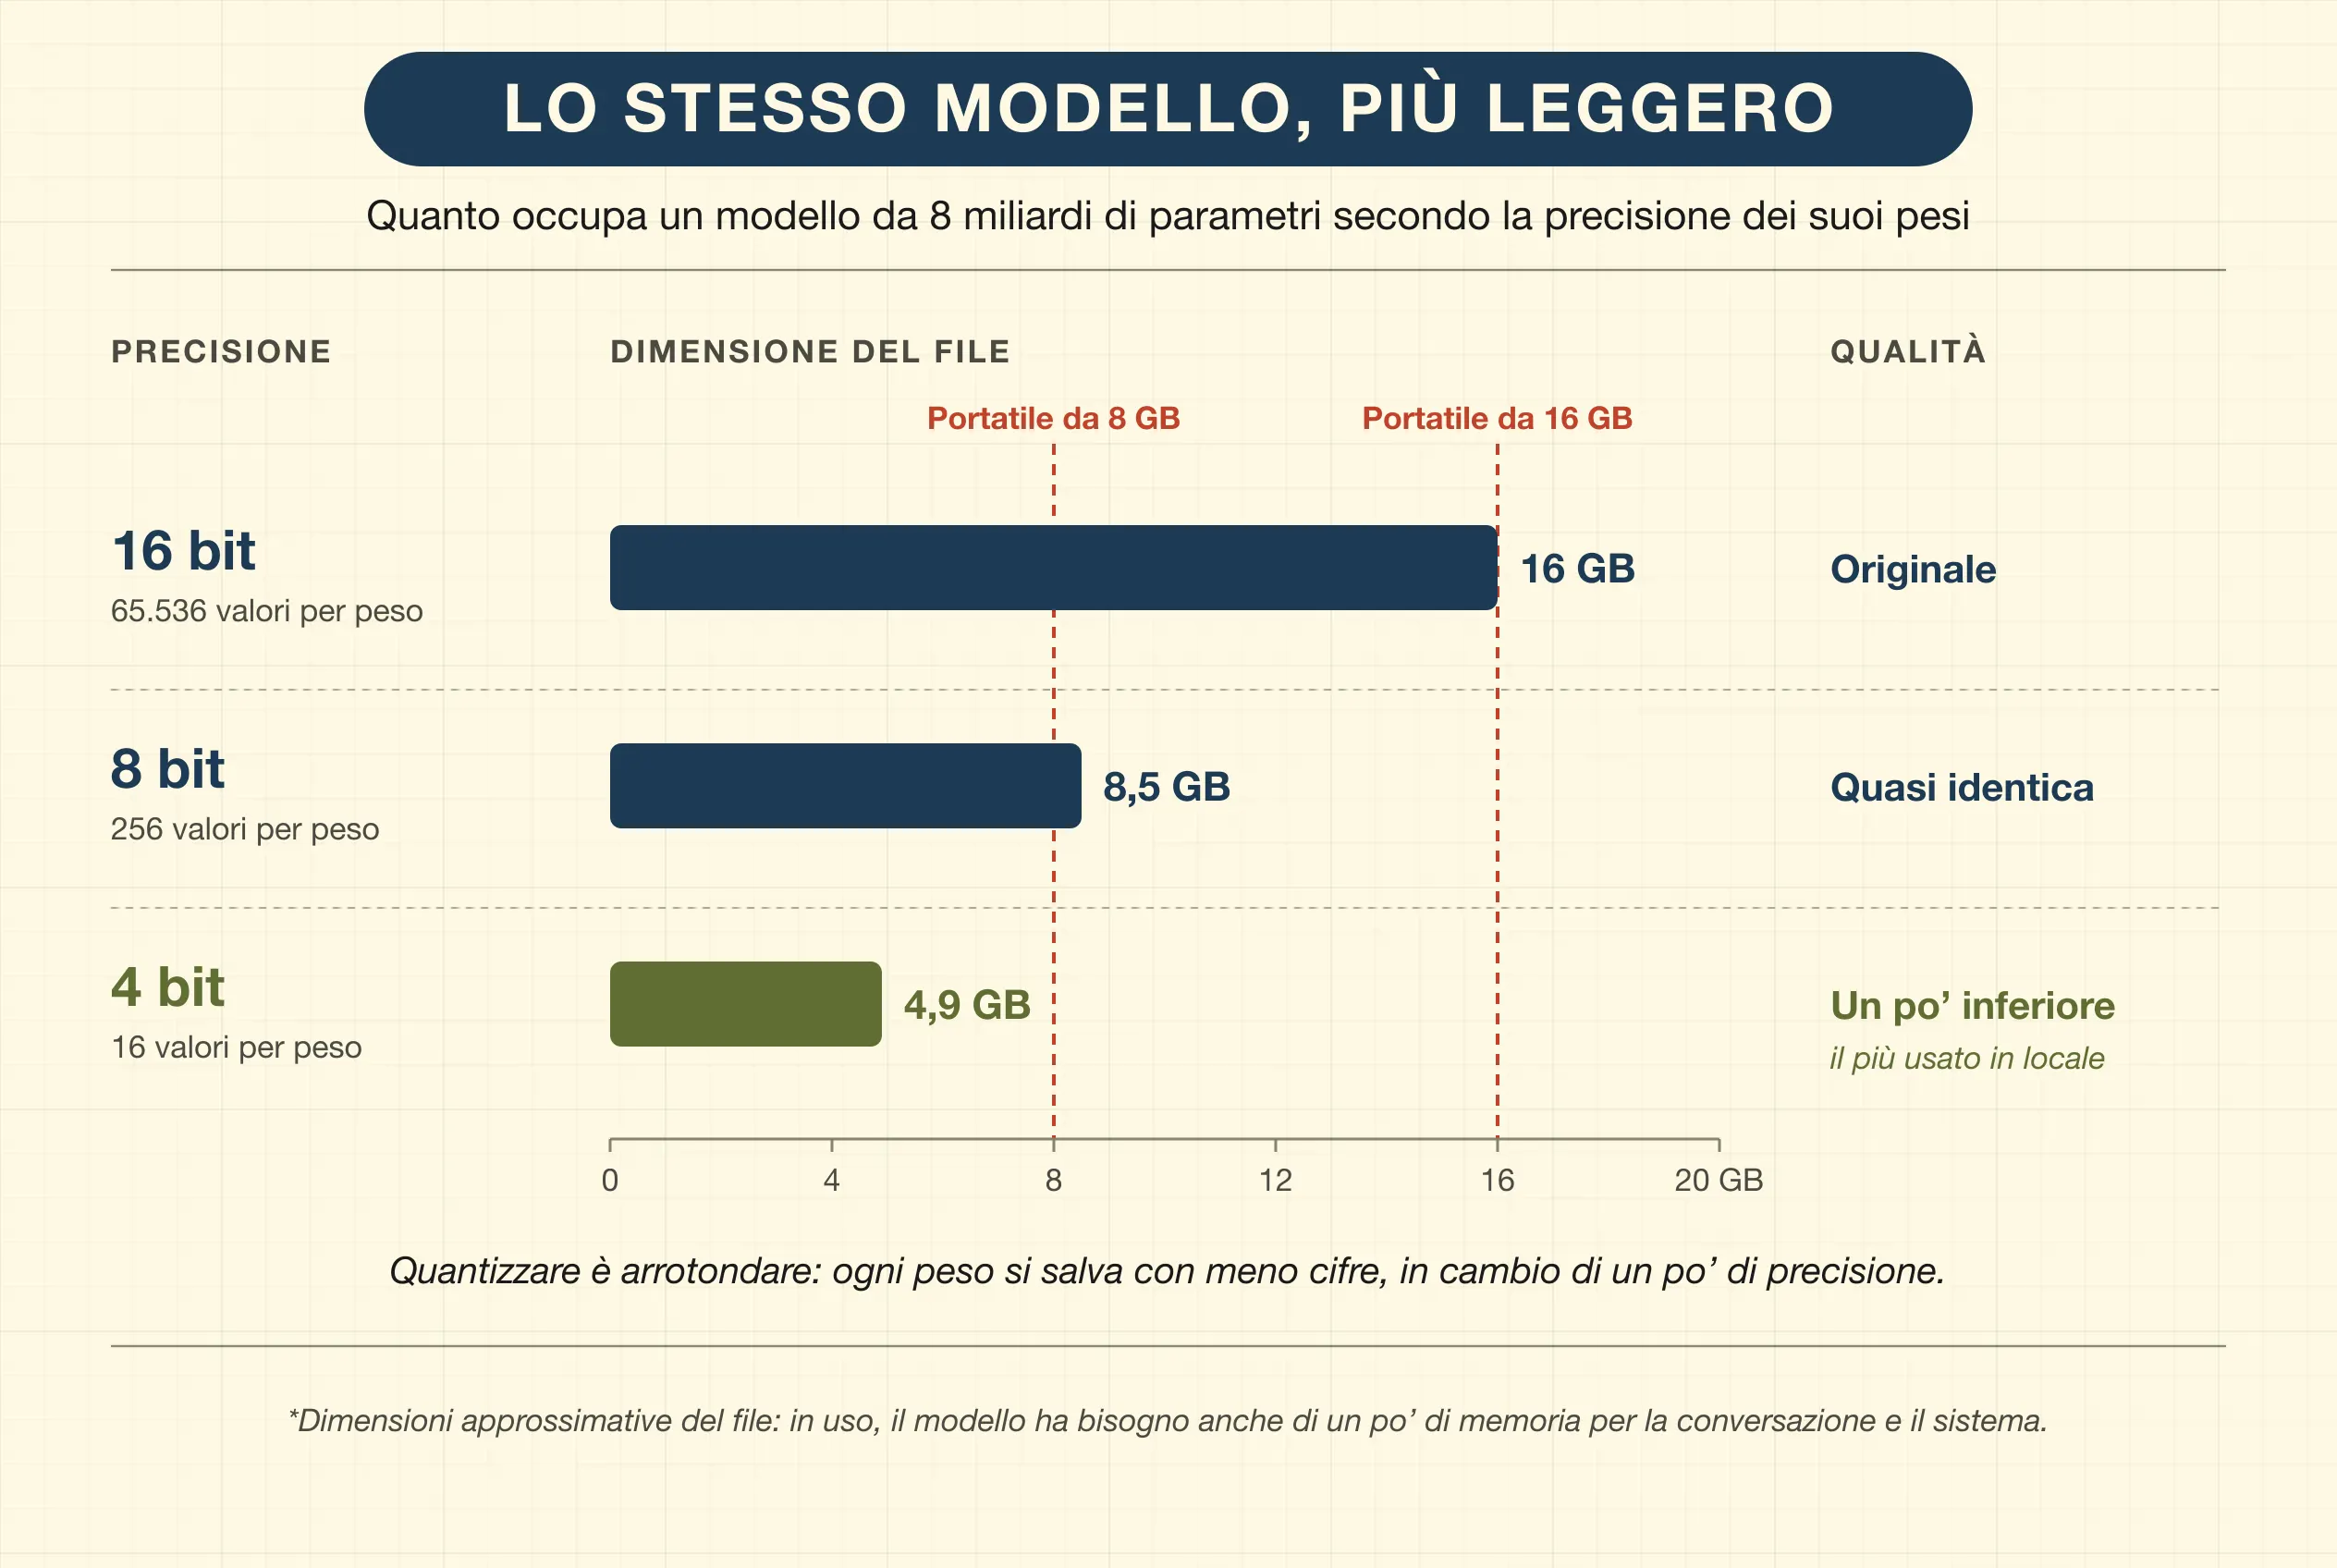
I modelli originali pesano decine o centinaia di gigabyte e richiedono intere batterie di schede grafiche professionali. Tuttavia, grazie a un processo matematico chiamato quantizzazione, che riduce la precisione numerica dei pesi (per esempio, sostituendo numeri decimali a 16 bit con interi a 4 bit), è possibile comprimere un modello in un formato efficiente, come GGUF. Un modello da 8 miliardi di parametri, che nella sua forma originale occupa circa 16 GB, scende così a circa 5 GB, con una piccola perdita di qualità. Grazie a questo, un portatile di fascia media con una scheda grafica discreta, o con abbastanza memoria condivisa, può eseguire senza fatica modelli molto competenti.
Strumenti di inferenza locale
Applicazioni come Ollama, LM Studio o Jan permettono di scaricare, gestire ed eseguire modelli a pesi aperti con un paio di clic, e offrono un’interfaccia di chat privata che funziona senza connessione a internet. Dietro le quinte, molte si appoggiano allo stesso motore open source, llama.cpp, il progetto che ha creato il formato GGUF.
- Ollama: è nato come strumento da riga di comando ed è diventato uno dei modi più diffusi per scaricare ed eseguire modelli aperti (Llama, Mistral, Qwen, DeepSeek) con un solo comando. Dal 2025 ha anche un’applicazione desktop.
- LM Studio e Jan: applicazioni desktop con un’interfaccia grafica curata, intuitiva come quella di ChatGPT, che permettono di chattare con modelli locali senza alcuna connessione.
L’arsenale creativo e produttivo
La cassetta degli attrezzi del creatore moderno va ben oltre le risposte testuali e abbraccia un repertorio multimediale senza precedenti:
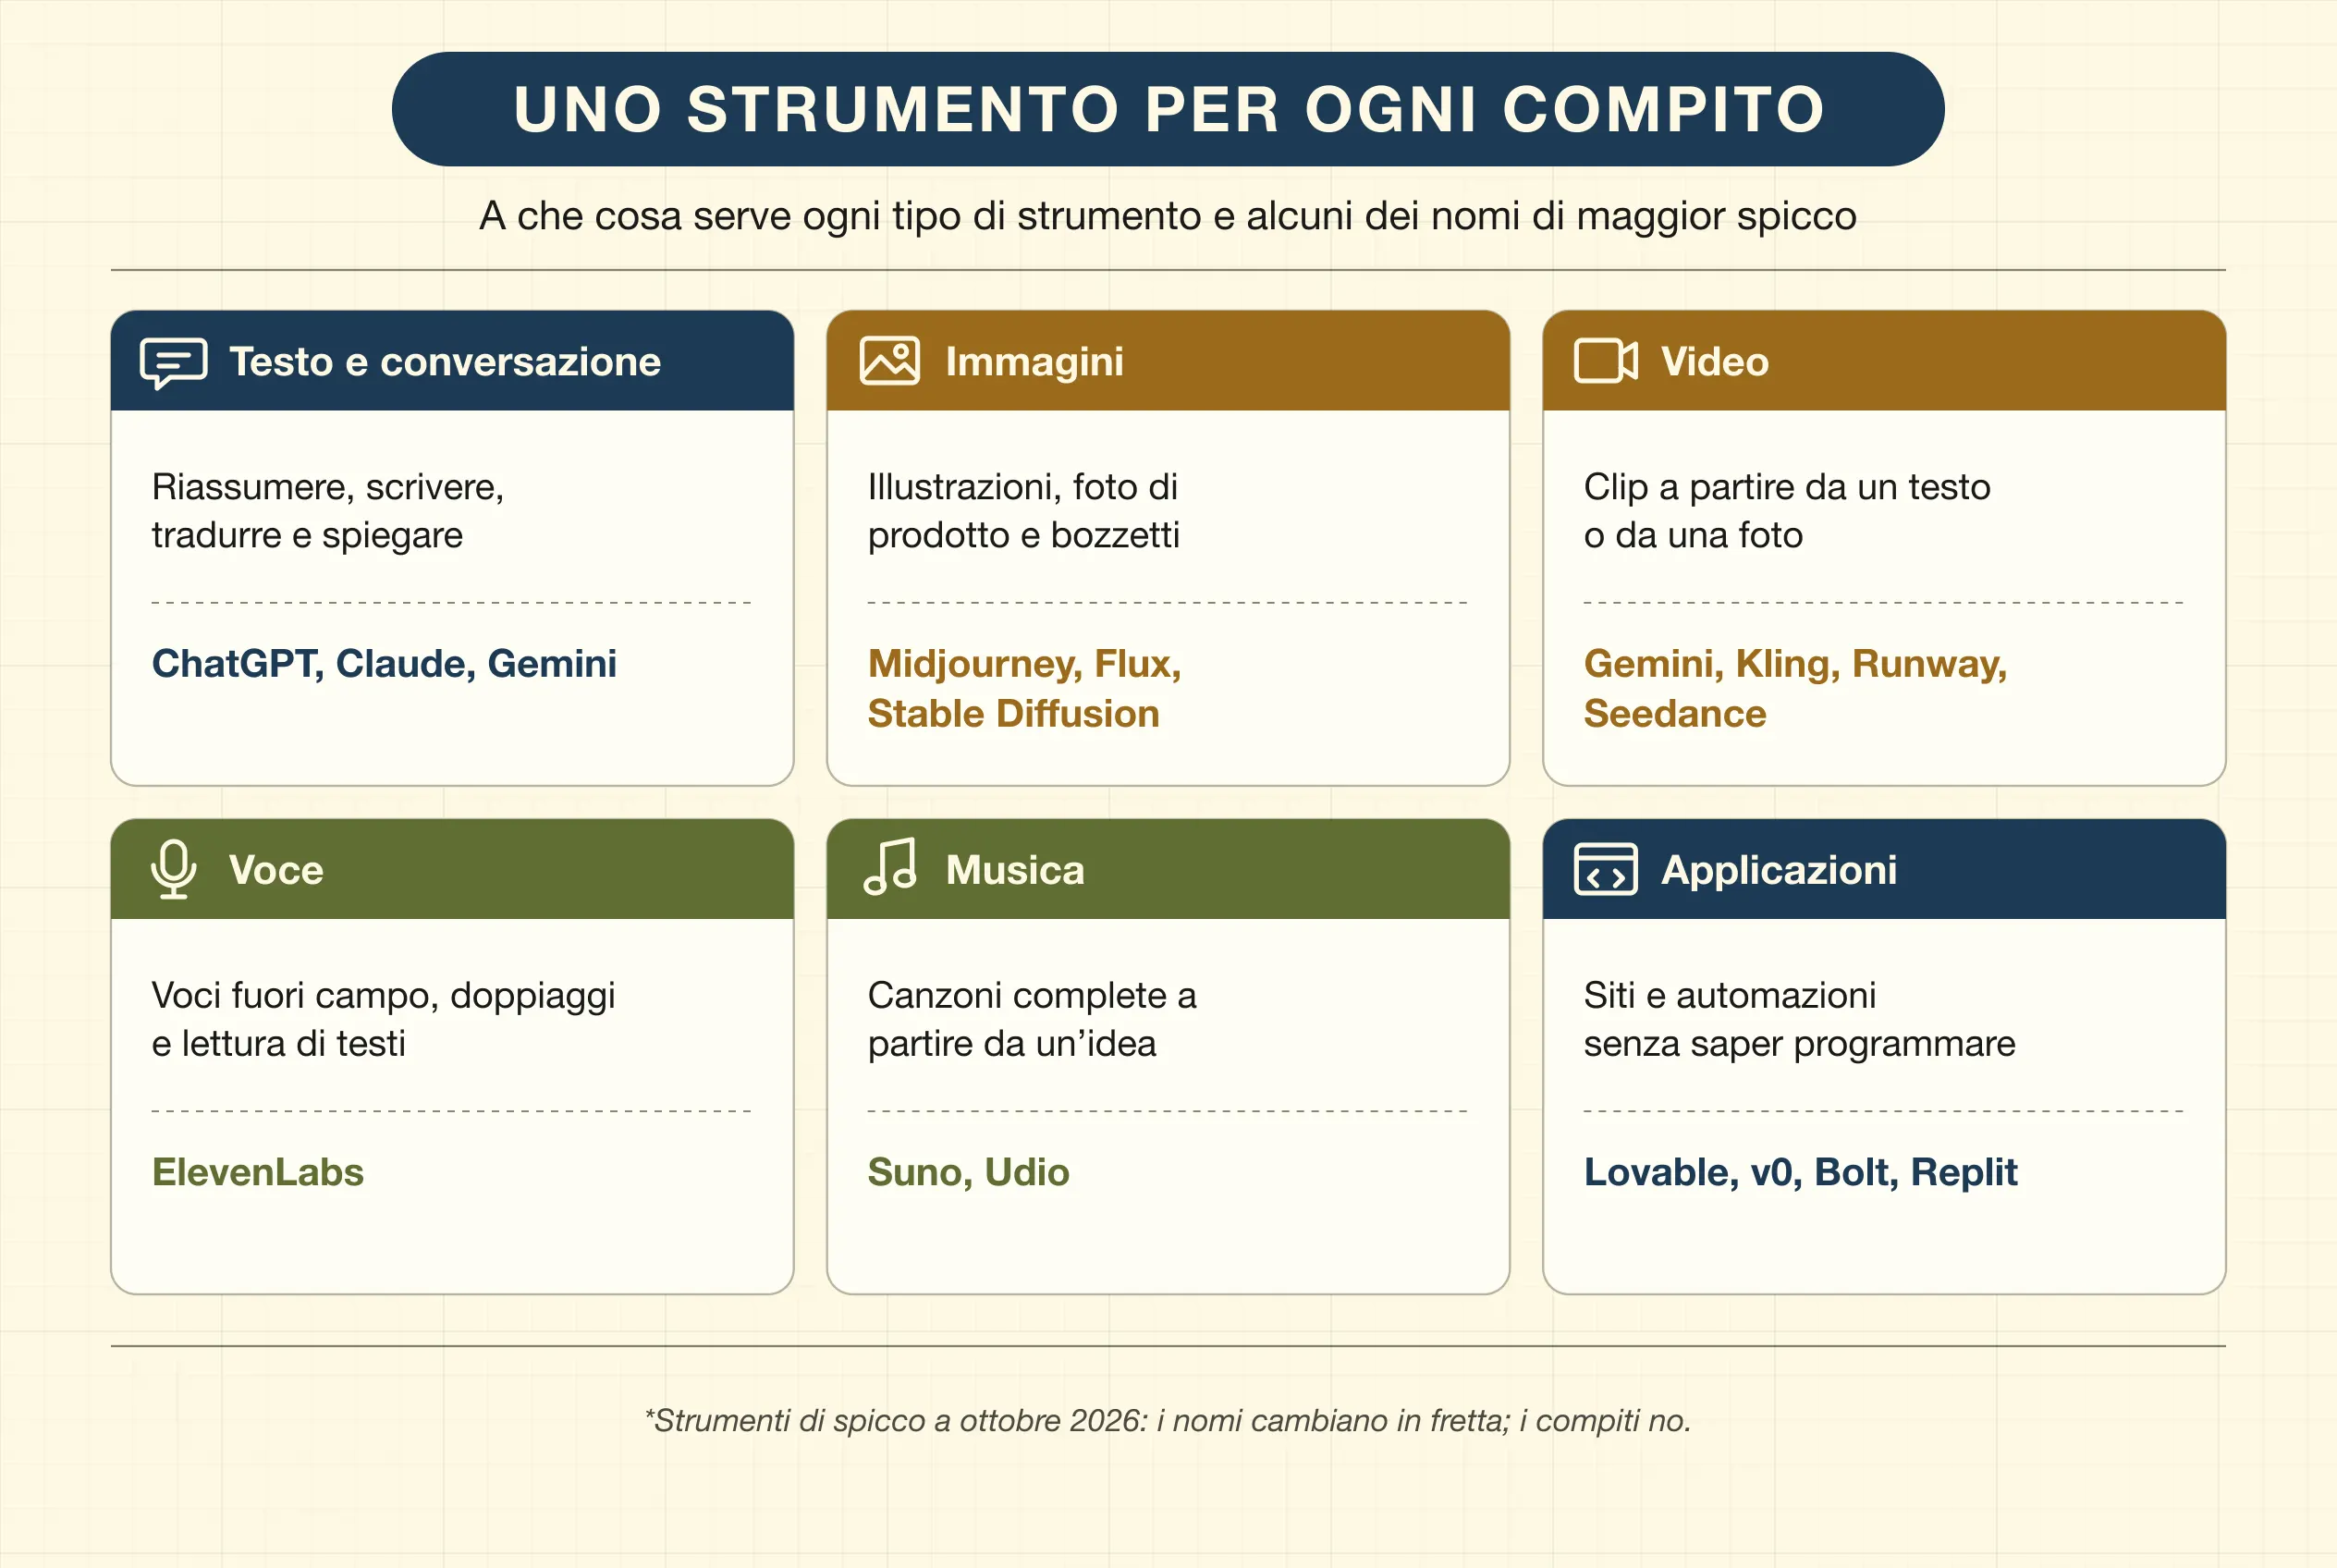
- Generazione di immagini: strumenti come Midjourney, Flux, Stable Diffusion o i generatori integrati in ChatGPT e Gemini, capaci di interpretare descrizioni complesse e creare illustrazioni, foto di prodotto o concept artistici con un controllo fine dell’illuminazione e dello stile. La maggior parte si basa su varianti della diffusione che abbiamo visto nella seconda parte.
- Video sintetico: la frontiera del fotorealismo in movimento (Gemini, di Google, Kling, Runway o Seedance), capace di generare sequenze fluide a partire da istruzioni testuali o da immagini statiche. La loro coerenza fisica è migliorata molto, ma è apparente: questi modelli imitano l’aspetto del mondo senza averne imparato le leggi.
- Audio, clonazione vocale e musica: piattaforme di sintesi e clonazione vocale iperrealistiche (ElevenLabs) e motori di composizione musicale completa (Suno, Udio) capaci di creare canzoni strutturate in qualsiasi genere a partire da una poesia o da un’idea generale. Oggi bastano pochi secondi di registrazione per imitare una voce, il che impone di diffidare dei messaggi audio inattesi anche quando sembrano di una persona conosciuta.
- Programmazione e creazione di applicazioni: editor assistiti per programmatori (Cursor) e piattaforme (Lovable, v0, Bolt, Replit) che permettono a persone senza formazione specifica di costruire applicazioni web, automazioni e siti interattivi descrivendo in linguaggio naturale ciò che vogliono. Il guadagno non è sempre quello che sembra: in uno studio controllato del 2025, programmatori esperti hanno impiegato il 19% in più con l’aiuto dell’IA su progetti che conoscevano bene, pur credendo di essere stati più veloci.
Comprendere il retrobottega dell’intelligenza artificiale —distinguendo tra i pesi statici del modello, le interfacce che lo avvolgono, gli strumenti di collegamento come l’MCP e la possibilità concreta di ospitare la tecnologia sul nostro hardware— trasforma radicalmente il nostro atteggiamento verso la tecnologia. Smettiamo di essere semplici consumatori passivi di prodotti chiusi e diventiamo architetti del nostro flusso di lavoro digitale.
Riferimenti e supporto scientifico
- Il modello linguistico prima della messa a punto: GPT-3 imparava compiti nuovi da pochi esempi inseriti nel testo stesso. Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., … & Amodei, D. (2020). Language models are few-shot learners. Advances in Neural Information Processing Systems, 33, 1877-1901. Consultare lo studio su arXiv
- Come un completatore di testi diventa un assistente: messa a punto con esempi umani e apprendimento per rinforzo dalle preferenze delle persone. Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C. L., Mishkin, P., … & Lowe, R. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35, 27730-27744. Consultare lo studio su arXiv
- L’apprendimento per rinforzo su problemi con soluzione verificabile, che insegna a un modello a ragionare passo dopo passo. Guo, D., Yang, D., Zhang, H., Song, J., Wang, P., Zhu, Q., … & Zhang, Z. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645(8081), 633-638. Consultare l’articolo (DOI)
- Come si addestra un modello perché le istruzioni del sistema pesino più di quelle dell’utente o di un testo esterno. Wallace, E., Xiao, K., Leike, R., Weng, L., Heidecke, J., & Beutel, A. (2024). The instruction hierarchy: Training LLMs to prioritize privileged instructions. arXiv, 2404.13208. Consultare lo studio su arXiv
- L’iniezione indiretta di istruzioni: un testo malevolo nascosto in un sito o in un documento può prendere il controllo di un’applicazione di IA. Greshake, K., Abdelnabi, S., Mishra, S., Endres, C., Holz, T., & Fritz, M. (2023). Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security, 79-90. Consultare lo studio (DOI)
- Una famiglia di modelli addestrati fin dall’inizio con testo, immagini, audio e video insieme. Gemini Team, Google. (2023). Gemini: A family of highly capable multimodal models. arXiv, 2312.11805. Consultare il rapporto su arXiv
- Un modello che impara da solo quando e come chiamare una calcolatrice, un motore di ricerca o un traduttore. Schick, T., Dwivedi-Yu, J., Dessì, R., Raileanu, R., Lomeli, M., Zettlemoyer, L., Cancedda, N., & Scialom, T. (2023). Toolformer: Language models can teach themselves to use tools. Advances in Neural Information Processing Systems, 36, 68539-68551. Consultare lo studio su arXiv
- La presentazione delle skill: cartelle di istruzioni e risorse che l’agente carica solo quando il compito le richiede. Zhang, B., Lazuka, K., & Murag, M. (2025). Equipping agents for the real world with Agent Skills. Anthropic Engineering. Consultare l’articolo di Anthropic
- L’annuncio di MCP, uno standard aperto per collegare i modelli a dati e strumenti esterni. Anthropic. (2024). Introducing the Model Context Protocol. Consultare l’annuncio di Anthropic
- Come funziona MCP e quali rischi di sicurezza apre ogni server collegato. Hou, X., Zhao, Y., Wang, S., & Wang, H. (2026). Model Context Protocol (MCP): Landscape, security threats, and future research directions. ACM Transactions on Software Engineering and Methodology, 35(10), 1-37. Consultare l’articolo (DOI)
- L’articolo che ha dato il nome alla tecnica RAG: unire un modello linguistico a un motore di ricerca di documenti. Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., … & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. Advances in Neural Information Processing Systems, 33, 9459-9474. Consultare lo studio su arXiv
- Una rassegna delle varianti di RAG, di come si valutano e dei loro limiti. Gao, Y., Xiong, Y., Gao, X., Jia, K., Pan, J., Bi, Y., … & Wang, H. (2023). Retrieval-augmented generation for large language models: A survey. arXiv, 2312.10997. Consultare lo studio su arXiv
- Ridurre la precisione dei pesi a 8 bit senza perdere qualità, per eseguire modelli grandi con molta meno memoria. Dettmers, T., Lewis, M., Belkada, Y., & Zettlemoyer, L. (2022). LLM.int8(): 8-bit matrix multiplication for transformers at scale. Advances in Neural Information Processing Systems, 35, 30318-30332. Consultare lo studio su arXiv
- La quantizzazione a 3 e 4 bit, che ha permesso di eseguire modelli linguistici su una sola scheda grafica. Frantar, E., Ashkboos, S., Hoefler, T., & Alistarh, D. (2023). GPTQ: Accurate post-training quantization for generative pre-trained transformers. International Conference on Learning Representations (ICLR). Consultare lo studio su arXiv
- La variante della diffusione su cui si basano Stable Diffusion 3 e i suoi successori. Esser, P., Kulal, S., Blattmann, A., Entezari, R., Müller, J., Saini, H., … & Rombach, R. (2024). Scaling rectified flow transformers for high-resolution image synthesis. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 12606-12633. Consultare lo studio su arXiv
- I generatori di video producono scene verosimili, ma sbagliano nel prevedere come si comportano gli oggetti secondo le leggi della fisica. Motamed, S., Culp, L., Swersky, K., Jaini, P., & Geirhos, R. (2026). Do generative video models understand physical principles? Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV), 948-958. Consultare lo studio (DOI)
- VALL-E: imitare una voce qualsiasi a partire da una registrazione di soli tre secondi. Chen, S., Wang, C., Wu, Y., Zhang, Z., Zhou, L., Liu, S., … & Wei, F. (2025). Neural codec language models are zero-shot text to speech synthesizers. IEEE Transactions on Audio, Speech and Language Processing, 33, 705-718. Consultare l’articolo (DOI)
- Uno studio controllato con programmatori esperti: con l’aiuto dell’IA hanno impiegato il 19% in più, pur credendo di essere stati più veloci. Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv, 2507.09089. Consultare lo studio su arXiv
Scrive di salute, nutrizione e delle certezze che nessuno rimette in discussione.
Stiamo preparando lo spazio per commentare gli articoli.
Continua a leggere
Il cuore nella pelle
Come la radiazione ultravioletta libera l'ossido nitrico della pelle per regolare la pressione arteriosa e contrastare il rischio cardiovascolare
L'effetto Zeigarnik, o il prezzo delle idee brillanti
Il fenomeno psicologico che sabota il tuo riposo in nome della creatività
Acqua strutturata: il terreno della salute
La batteria liquida delle tue cellule e come proteggerla dall'ambiente moderno